[논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
링크: 논문 PDF로 바로 열기
**저자:** Bingxi Hou, Guochao Jiang, Guofeng Quan, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문은 Waypoint-OPD 방법론과 관련된 여러 핵심 기술 용어를 사용하며, 그 정의는 다음과 같습니다.
- **On-Policy Distillation (OPD)**: 학생 모델이 생성한 궤적(trajectory)에 대해 교사 모델의 토큰 분포를 모방하도록 훈련하는 지식 증류(knowledge distillation) 방식입니다.
- **Policy Shift**: 강화 학습(Reinforcement Learning, RL) 훈련 전후의 교사 모델(teacher model) 로그 확률(log probability) 간의 차이를 나타내며, 이는 학생 모델 훈련을 위한 supervision signal로 사용됩니다.
- **Waypoint Checkpoint**: RL 훈련의 초기(Initial) 단계와 최종(Final) 단계 사이에 위치하는 중간 교사 모델 체크포인트를 의미합니다. 이 체크포인트는 초기 및 최종 정책 변화 간의 일관성을 평가하는 데 사용됩니다.
- **Agreement Gating**: 초기-Waypoint 및 Waypoint-최종 정책 변화 간의 방향 일치(directional agreement) 여부에 따라 최종 정책 변화(endpoint shift) 신호에 가중치를 부여하는 메커니즘입니다. 일치하지 않는 경우 신호를 억제합니다.
- **Batch-Scale Normalization**: 배치(batch) 내의 게이트(gate) 스케일을 안정화하기 위해 모든 gated reward에 적용되는 스케일링 계수(scaling factor)를 의미합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Reinforcement Learning (RL)은 인간 선호도 또는 검증 가능한 보상(verifiable rewards)을 사용하여 언어 모델의 지시 따르기(instruction following) 및 수학/코드 추론(mathematical and code reasoning) 능력을 향상시킬 수 있습니다. 이러한 RL 훈련 노력은 비용이 많이 들기 때문에, 교사 모델의 RL 개선 사항을 학생 모델(student model)로 전이하는 `Policy-shift distillation`이 중요한 연구 과제로 부상했습니다. 기존 `Direct On-Policy Distillation (Direct-OPD)`은 RL 훈련 전후 교사 모델 간의 `Initial-to-Final log-probability ratio`를 사용하여 `RL-induced policy shift`를 학생 모델에 전이하지만, 이 `endpoint-only` 신호는 교사 훈련 과정에서 국부적인(local) 행동 선호도가 일관되게 진화했는지 여부를 반영하지 못합니다. 즉, 동일한 `endpoint shift`가 초기 및 후기 변화가 서로 강화되거나 부분적으로 상쇄되는 경우 모두에서 발생할 수 있으므로, 단일 `endpoint signal`만으로는 이러한 모호성을 구분할 수 없습니다. 본 연구는 이러한 `endpoint-only transfer`의 한계를 해결하기 위해, 초기 및 후기 교사 정책 변화 간의 `directional agreement`가 `selective transfer`를 안내할 수 있다는 가설을 제안합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 `RL-induced policy shifts`의 효과적인 전이를 위해 `Waypoint-guided On-Policy Distillation (Waypoint-OPD)`을 제안합니다. Waypoint-OPD는 `Initial`, `Waypoint`, `Final`의 세 가지 교사 체크포인트를 활용하여, 학생 모델이 생성한 `prefix`에서 초기(`Initial`-`Waypoint`) 및 후기(`Waypoint`-`Final`) `policy shift` 간의 `directional agreement`를 측정합니다. 이 `agreement`는 `endpoint shift`에 `gating`을 적용하여, 일치하는 변화는 유지하고 상반되는 변화는 억제합니다. 제안된 방법론은 학생이 방문한 `prefix`에서 `Top-K` 토큰 후보에 대해 `student-local trajectory consistency`를 평가하며, `centered segment shifts`를 통해 `agreement gate`를 정의합니다. 또한 `batch-scale normalization`을 통해 `gate` 스케일을 안정화하고 `dense candidate objective`를 사용하여 학생 모델을 업데이트합니다.
`Qwen3-4B` 교사 모델과 `Qwen3-8B`, `Qwen3-14B`, `Qwen3-30B-A3B` 학생 모델을 사용하여 수학 및 코드 추론 분야에서 `Waypoint-OPD`의 성능을 평가한 결과, 모든 6가지 `domain-student` 설정에서 `Waypoint-OPD`는 비교된 `distillation` 방법 중 가장 높은 `domain-average score`를 달성했습니다. 특히, 수학 추론에서 `Direct-OPD` 대비 `Qwen3-8B`에서 **2.18** 퍼센트 포인트, `Qwen3-14B`에서 **1.59** 퍼센트 포인트, `Qwen3-30B-A3B`에서 **1.89** 퍼센트 포인트의 평균 `accuracy` 향상을 보였습니다. 코드 추론에서도 `Direct-OPD` 대비 `Qwen3-8B`에서 **2.66** 퍼센트 포인트, `Qwen3-14B`에서 **1.52** 퍼센트 포인트, `Qwen3-30B-A3B`에서 **1.19** 퍼센트 포인트의 평균 `mean@8 score` 향상을 기록했습니다. `Ablation study` 결과, `Qwen3-8B` 수학 추론에서 `gating` 메커니즘을 제거하거나 `gate`를 무작위로 섞는 경우 성능이 크게 저하되어, `temporal gating`과 `prefix-specific gate assignment`의 중요성을 입증했습니다. `batch-scale normalization` 또한 평균 **0.92** 퍼센트 포인트의 추가적인 성능 개선에 기여했습니다.
## 4. Conclusion & Impact (결론 및 시사점)
본 논문은 `RL-induced policy shifts`를 효과적으로 전이하기 위해 `temporal agreement` 기반의 `Waypoint-OPD`를 성공적으로 제안했습니다. `Waypoint checkpoint`를 활용하여 `early` 및 `late policy changes` 간의 `directional agreement`를 평가하고, 이를 통해 `endpoint transfer signal`의 가중치를 조절하는 접근 방식은 `endpoint-only` 방법론의 한계를 극복했습니다. 이 연구는 추가적인 `teacher training`이나 `verifier calls` 없이 단 한 번의 `frozen-teacher scoring pass`만으로 구현 가능하다는 점에서 실용적인 가치를 가집니다. `Waypoint-OPD`는 수학 및 코드 추론과 같은 복잡한 `reasoning task`에서 다양한 `student model` 규모에 걸쳐 기존 `Direct-OPD` 대비 우수한 성능을 보여주었습니다. 이러한 결과는 중간 `teacher checkpoint`가 학생 학습 과정에서 `local policy changes`의 가중치를 결정하는 데 중요한 증거를 제공하며, 향후 `knowledge distillation` 및 `policy transfer` 연구에 새로운 방향을 제시할 수 있습니다.
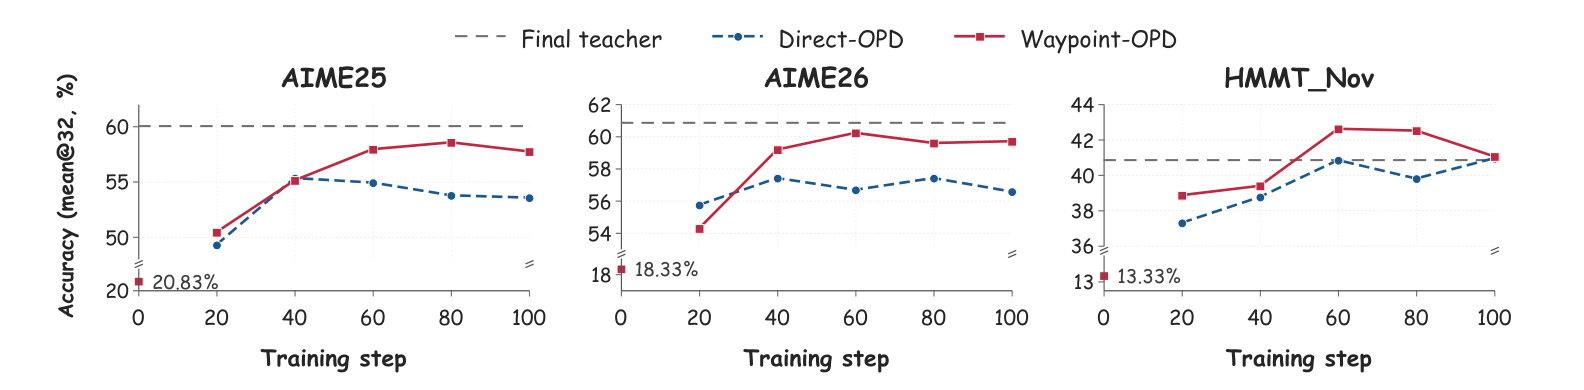
*Figure 3 — 훈련 중 평가 정확도*
> ⚠️ **알림:** 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
- [논문리뷰] Calibrating Teacher--Student Discrepancy for On-Policy Distillation
- [논문리뷰] Does On-Policy Distillation Really Distill? From Noisy Teacher to Self-Improvement
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] Pass the Baton: Trajectory-Relayed On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] Virtual Head Attention
- 현재글 : [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- 다음글 [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
댓글