[논문리뷰] MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
링크: 논문 PDF로 바로 열기
저자: Juekai Lin, Honglin Lin, Yuqian Yuan, Xiaolong Wu, Jie Cao, Liang Liang, Yunqi Cao, Yun Zhu, Wenqiao Zhang, Lijun Wu
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 주요 용어들은 다음과 같다:
- MMVistaReason (MVR): 오픈 데이터 큐레이션부터 SFT(Supervised Fine-Tuning) 및 RL(Reinforcement Learning) 데이터 구축, 도메인별 RL training, 그리고 multi-teacher OPD(On-Policy Distillation) 통합까지 multimodal reasoning을 위한 체계적인 파이프라인과 adaptive training recipe를 의미한다.
- Analytical Reasoning: 구조화되고 지식 집약적인 문제 해결에 중점을 두는 reasoning 그룹으로, 수학, 과학, 시각 논리, 차트 reasoning 등을 포함한다.
- Real-World Reasoning: 시각적 인지 및 공간 grounding에 중점을 두는 reasoning 그룹으로, 일반 인지, counting, 공간 이해, GUI grounding 등을 포함한다.
- Answer-Likelihood Best-of-N: 여러 teacher-generated trajectory 중 최종 답변 토큰의 normalized log-likelihood를 기준으로 가장 신뢰할 수 있는 trajectory를 선택하는 방법론이다.
- Multi-Teacher On-Policy Distillation (MOPD): 상호 보완적인 RL expert들의 특화된 capabilities를 통합하여 unified generalist 모델을 구축하는 on-policy distillation 전략이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Multimodal reasoning 모델의 성능 향상에도 불구하고, 신뢰할 수 있는 post-training은 여전히 어려운 문제로 남아있다. 기존 연구들은 주로 모델 스케일링에 초점을 맞추었으나, 데이터 품질 불균형, 비효율적인 supervision 구축, 난이도 불균형, 그리고 cross-domain interference와 같은 병목 현상에 직면해 있다. 특히, 기존 multimodal reasoning 데이터는 분석적인 task(수학, 과학, 구조화된 시각 reasoning)에 편중되어 Real-World capabilities(인지, counting, 공간 이해, GUI grounding)는 상대적으로 덜 강조되는 한계가 있다. 또한, supervision distillation 과정에서 단일 teacher에 의존하며, SFT와 RL에 필요한 supervision 특성이 달라 효율적인 데이터 구축이 어렵다. 마지막으로, 이질적인 reasoning domain들을 단일 목표로 학습할 경우 cross-domain negative transfer가 발생할 수 있어, specialist 모델의 강점을 unified generalist에 통합하는 방법론이 부족하다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
MMVistaReason (MVR)은 세 가지 주요 관점에서 이러한 multimodal reasoning의 난제를 해결하는 체계적인 프레임워크를 제안한다. 첫째, broader capability coverage를 위해 multimodal reasoning을 Analytical과 Real-World 두 그룹으로 분류하여 균형 잡힌 학습을 목표로 한다. 둘째, efficient SFT 및 RL 데이터 구축을 위해 난이도 인지 cascaded teacher distillation(Qwen3.5-9B, 27B, 122B teacher 사용)과 Answer-Likelihood Best-of-N trajectory selection을 통해 MVR-SFT-528K 데이터를 구축했다. RL 데이터인 MVR-RL-63K는 scale-specific frontier filtering을 통해 모델이 불안정하게 해결하는 frontier samples에 집중한다. 셋째, specialize-then-integrate training 방식은 각 reasoning 그룹별로 보완적인 RL expert들을 GSPO를 사용하여 학습시키고, 이들의 capabilities를 multi-teacher MOPD를 통해 unified generalist 모델로 통합한다 [Figure 2].
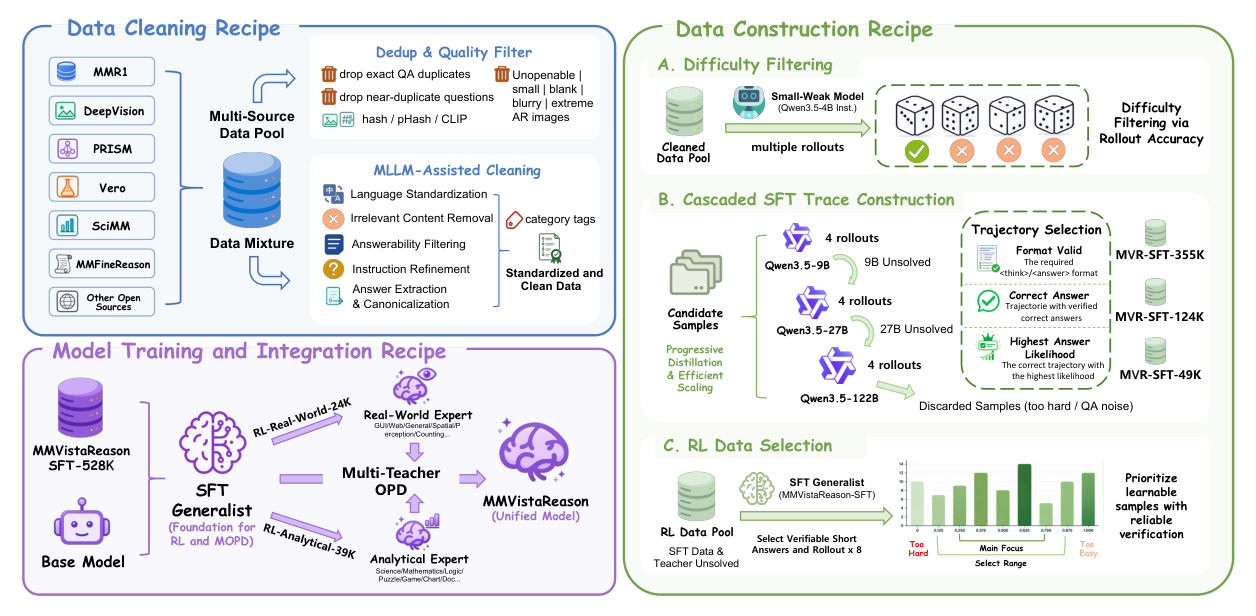
Figure 2 — MMVistaReason 프레임워크의 데이터 cleaning, 데이터 구축, 모델 training 및 통합에 이르는 전체 파이프라인을 보여주는 핵심 다이어그램.
실험 결과, MVR-4B는 15개 multimodal 벤치마크에서 평균 72.8점을 달성하며, Qwen3.5-9B (Instruct) 및 MMFineReason-8B를 능가하는 성능을 보였고, MMFineReason 대비 약 70% 적은 SFT 샘플을 사용했다. MVR-9B로 스케일링 시 평균 74.4점으로, Qwen3.5-35B-A3B (Instruct)를 능가하며 GPT-5.1에 근접한 성능을 달성했다 [Figure 1, Table 2]. 특히, MVR-4B는 Real-World Average에서 82.0를 기록하여 MFR-8B 대비 3.3점 높은 점수를 얻었으며, MVR-9B는 Analytical Average에서 68.1을 달성했다. MOPD 통합 후 4B 모델의 전체 평균은 70.8에서 72.8로, 9B 모델은 72.3에서 74.4로 향상되어, SFT 일반화 모델 대비 일관된 성능 개선을 보였다 [Table 3]. 또한, MOPD는 mixed-domain RL 대비 cross-domain interference를 줄이고 일관된 capability integration을 제공함을 입증했다 [Figure 6].
4. Conclusion & Impact (결론 및 시사점)
MMVistaReason은 open-data 프레임워크와 적응형 training recipe를 통해 multimodal reasoning의 신뢰성을 향상시키는 데 성공했다. 본 연구는 multimodal reasoning을 단순히 모델 스케일링의 문제로 보지 않고, 데이터 구축, 난이도 인지 샘플 선택, expert specialization, 그리고 capability integration의 복합적인 도전 과제로 접근한다. MVR은 체계적인 데이터 cleaning, answer normalization, model-aware difficulty filtering, cascaded rejection sampling, Answer-Likelihood Best-of-N trajectory selection 등을 통해 이질적인 오픈 데이터를 고품질의 검증 가능한 reasoning supervision으로 변환한다. 이 연구는 domain-specific specialization과 MOPD를 통해 상호 보완적인 expert capabilities를 cross-domain interference를 줄이면서 unified 모델에 효과적으로 통합할 수 있음을 보여준다. 궁극적으로 MMVistaReason은 신뢰할 수 있는 multimodal reasoning 모델을 구축하기 위한 실용적이고 확장 가능한 경로를 제시한다.
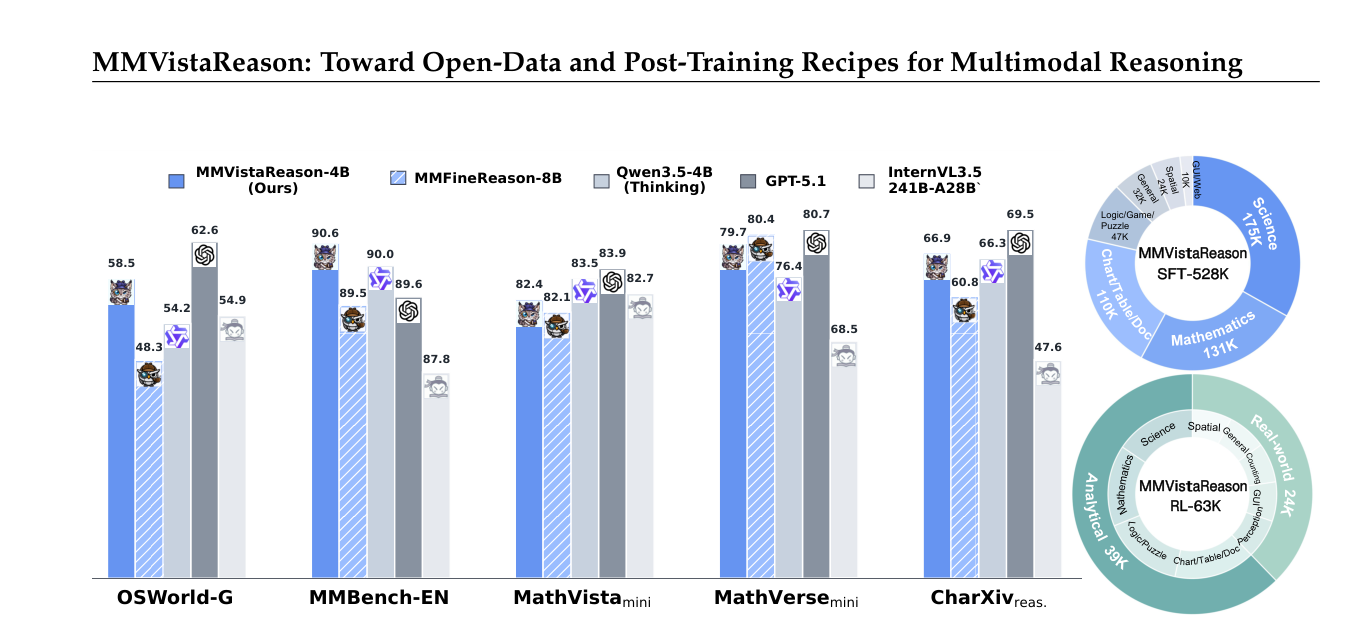
Figure 1 — MMVistaReason의 벤치마크 성능과 데이터셋의 reasoning domain 커버리지를 시각적으로 요약하여 전반적인 강점과 scope를 보여준다.
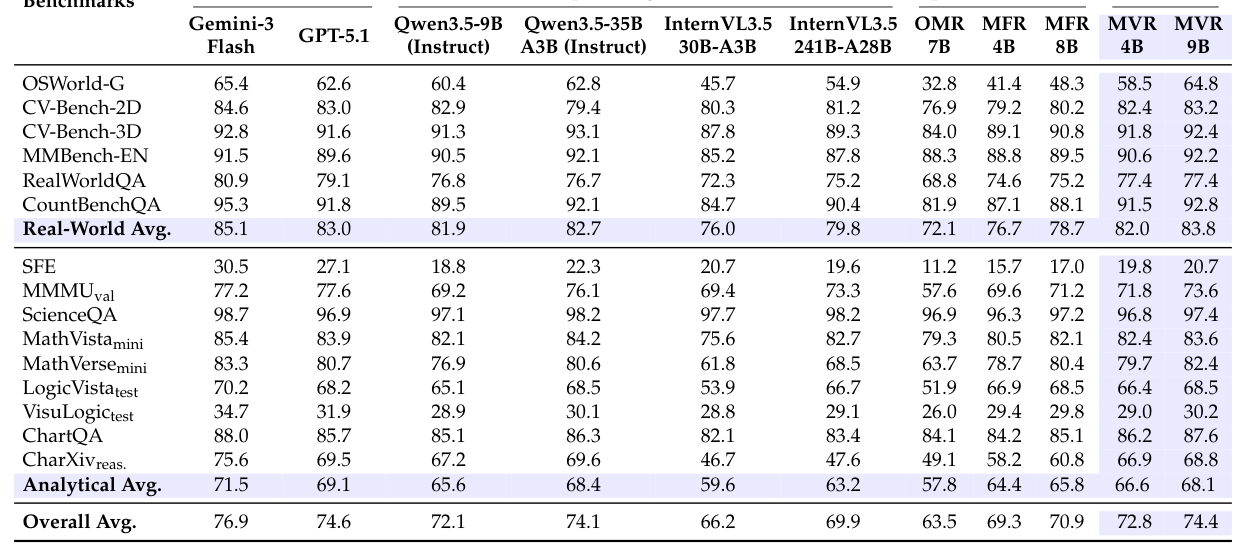
Table 2 — MMVistaReason 모델과 다양한 closed-source, open-weight, open-source VLM baseline들의 15개 multimodal 벤치마크에서의 정량적 성능을 비교하는 핵심 결과 테이블.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Typhoon-S: Minimal Open Post-Training for Sovereign Large Language Models
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] Distilled Reinforcement Learning for LLM Post-training
- [논문리뷰] On-Policy Delta Distillation
Review 의 다른글
- 이전글 [논문리뷰] LoCA: Enabling Multi-Modality in Geospatial Location Encoders
- 현재글 : [논문리뷰] MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
- 다음글 [논문리뷰] MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
댓글