[논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
링크: 논문 PDF로 바로 열기
저자: Anni Zou, Cheng Chen, Jiaji Deng, Weikang Zhou, Xinji Mai, Yue Wu, Jianing Lin, Lipeng Xie, Lixiong Qin, Qingyue Zhao, Que Shen, Shuchang Tao, Xuchen Pan, Yaliang Li, Yunpeng Zhai, Yushuo Chen, Zhihai Wang, Zhuo Zhang, Zhaoyang Liu, Bolin Ding, Jingren Zhou
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 제안하는 Cowork-Gym 프레임워크와 방법론을 이해하기 위한 핵심 용어들은 다음과 같다.
- Cowork environment: 에이전트와 사용자가 공유 Workspace에서 상호작용하며 특정 목표를 달성하는 태스크를 정의하는 환경이다. 이는 태스크 목표, 초기 Workspace, 사용 가능한 인터페이스, 사용자 상호작용 정책, 그리고 검증 기준을 포함한다.
- Stateful User Simulator: 에이전트의 행동에 따라 대화 및 공유 Workspace에 대한 직접적인 편집을 통해 응답하는 시뮬레이터로, 현실적인 Cowork Dynamics를 모방한다. 이 시뮬레이터는 Persona, Latent Goal, Knowledge Boundary, Signal Plan을 포함하는 Private User State를 유지한다.
- Build–Execute–Revise loop: Cowork-Gym의 핵심 환경 합성 메커니즘으로, 실행 증거(Execution Evidence)와 검토 피드백(Review Feedback)을 사용하여 생성된 환경의 일관성(Consistency)을 검증하고 수정하는 반복적인 프로세스이다.
- Hybrid Verifier (𝒱code, 𝒱LLM): 최종 Workspace, 아티팩트에 대한 결정론적 검사(Deterministic Checks)를 수행하는 𝒱code와, 의미론적 정확성(Semantic Correctness) 및 태스크 관련 프로세스 증거에 대한 LLM 기반 평가를 결합한 검증 시스템이다.
- Trajectory: 특정 환경에서 에이전트 정책(Agent Policy) 및 Harness 구성에 따라 생성된 Workspace의 진화, 에이전트 액션, 사용자 개입, Tool 호출 및 Tool 결과에 대한 기록이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Cowork 에이전트의 개발을 위한 환경 확장은 태스크 목표, 실행 가능한 리소스, 사용자 행동, 성공 기준 간의 일관성을 유지하기 어렵다는 핵심 문제에 직면한다. 기존 연구들은 웹(Web)이나 컴퓨터 사용(Computer-use) 에이전트를 위한 재현 가능하고 실행 가능한 테스트베드를 구축했지만, 사용자 상호작용과 Workspace 변화에 따라 동적으로 진화하는 Cowork 환경의 복잡성을 대규모로 다루는 데 한계가 있었다. 특히, 수동으로 Cowork 환경을 구성하고 검증하는 것은 비용이 많이 들고 오류 발생 가능성이 높으며, 이는 태스크를 해결 불가능하게 만들거나 잘못 평가하는 결과를 초래할 수 있다. 따라서 본 연구는 Workspace 상태와 사용자 요구 사항이 상호작용 중에 진화하는 Cowork 환경을 자동으로 합성하기 위한 확장 가능한 프레임워크의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 대규모 대화형 작업 환경을 합성하기 위한 프레임워크인 Cowork-Gym을 제안한다 [Figure 3]. Cowork-Gym은 taxonomy-guided generation과 resource-grounded generation이라는 두 가지 보완적인 경로를 통해 태스크를 정의하며, 각 태스크는 Build–Execute–Revise loop를 통해 실행 가능한 환경으로 인스턴스화되고 정제된다. 이 루프는 Builder가 초기 Workspace 상태, 인터페이스 세트 및 상태 저장 사용자 정책을 구성하고, Verifier Constructor가 Hybrid Verifier를 구축하며, Issue Detector가 조립된 환경을 실행하여 결함을 식별하고 수정을 유도한다. 특히, Stateful User Simulator는 에이전트의 진행 상황에 따라 대화 및 Workspace 직접 편집을 통해 응답하여, 에이전트가 변경된 요구 사항 및 입력에 맞춰 작업을 조정해야 하는 다중 턴 협업(Multi-turn Collaboration)을 지원한다 [Figure 4].
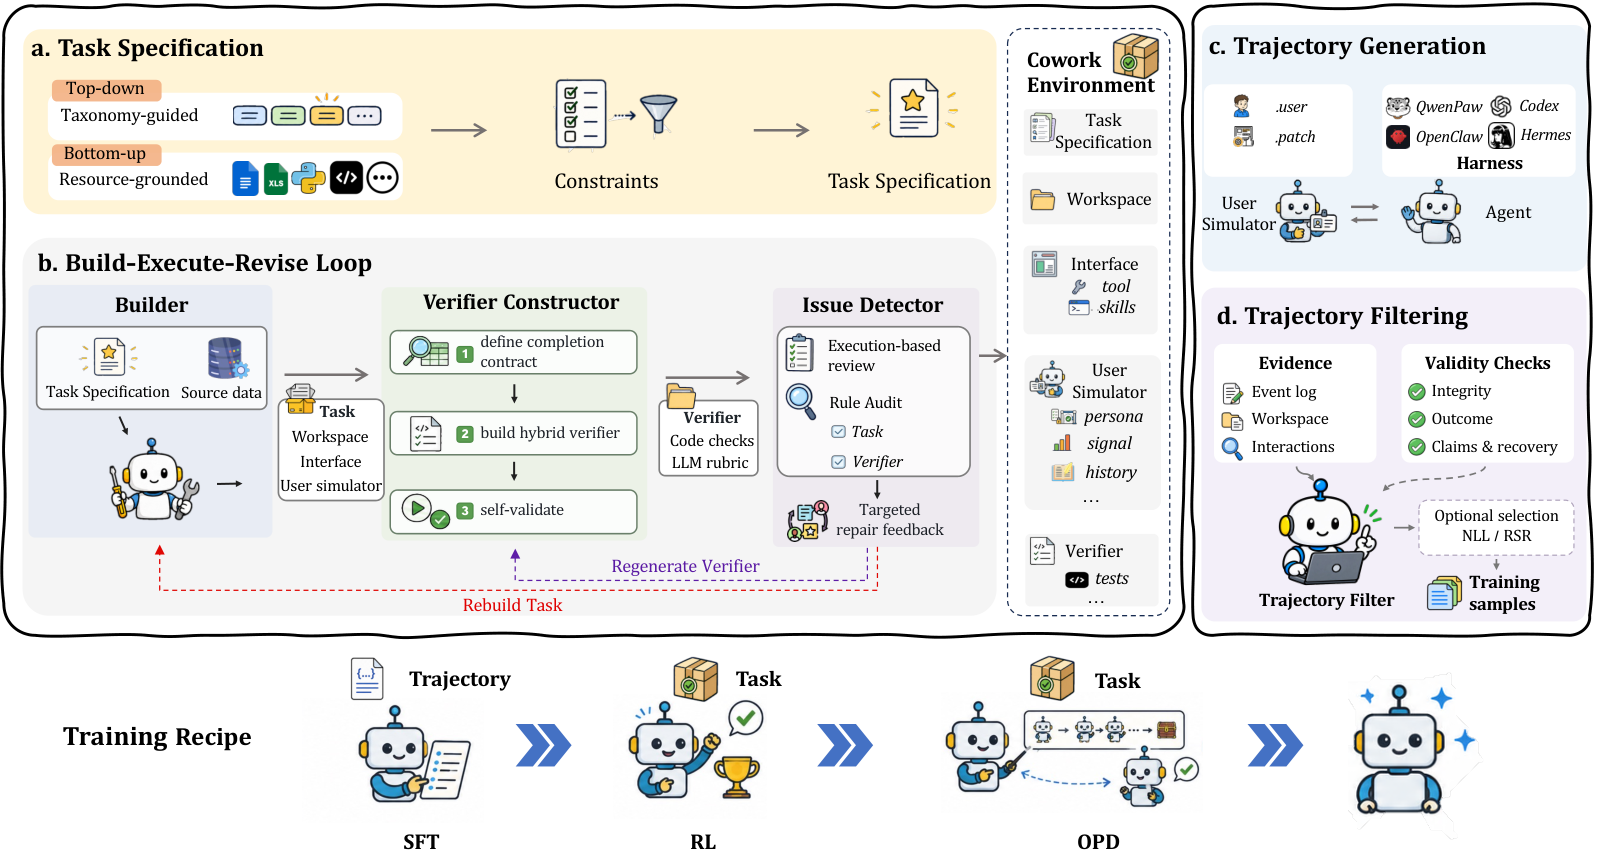
Figure 3 — Cowork 환경 합성 및 에이전트 훈련 개요
이 프레임워크를 통해 연구팀은 14개 애플리케이션 시나리오에 걸쳐 64.9K의 Cowork 환경을 합성했다 [cite: 1, Figure 1]. 이러한 합성된 환경에서 수집된 Trajectory와 Verification 신호를 활용하여 Qwen3.5-9B, Qwen3.6-27B, Qwen3.6-35B-A3B 모델을 Supervised Fine-Tuning (SFT), Reinforcement Learning (RL), On-Policy Distillation (OPD)을 통해 Post-Training했다. 실험 결과, Post-Training된 모델들은 6개 Agentic Benchmarks (Workspace-Bench, ALE, WildClawBench, PawBench, ClawEval, ClawMark)에 걸쳐 해당 Base Checkpoint 대비 평균적으로 8.7, 6.4, 4.1 points 성능 향상을 보였다 [cite: 1, Table 2]. 특히, Ours-27B 모델은 평가된 모델 중 전체 2위를 차지했으며, PawBench와 ClawEval에서 100B 이상의 총 파라미터를 가진 모델들을 능가하는 최고의 평균 점수를 달성했다 [cite: 1, Table 2]. 또한, 다중 턴 Trajectory를 훈련 세트에 추가했을 때 ClawMark에서 +3.23 points의 가장 큰 개선을 보이며 Interactive Supervision의 보완적인 이점을 입증했다 [cite: 1, Table 3]. Model-conditioned Trajectory Selection (NLL 및 RSR)은 70%의 후보 Trajectory만으로도 모든 모델 크기에서 보고된 모든 Metric을 개선하여, 단순히 유효한 Trajectory뿐만 아니라 학습 가치가 높은 Trajectory를 선별하는 것의 중요성을 보여주었다 [cite: 1, Table 5]. On-Policy Distillation (OPD)은 ClawEval에서 Base Model 대비 +4.5 points Pass@3 성능 향상을 통해, Agentic Gain을 이전하면서 일반적인 모델의 능력을 잘 보존함을 입증했다 [cite: 1, Figure 7].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실행 가능한 Cowork environment를 대규모로 합성하는 Cowork-Gym 프레임워크를 성공적으로 제안했다. 이 프레임워크는 taxonomy-guided 및 resource-grounded 태스크 생성과 build–execute–revise 루프를 결합하여 태스크, Workspace, 인터페이스, 사용자 정책 및 검증자를 포함한 완전한 환경을 구축하고 검증한다. Stateful User Simulator의 도입은 대화 및 공유 Workspace 편집을 통한 다중 턴 협업을 가능하게 하여, 에이전트가 동적으로 변화하는 상황에 적응하도록 돕는다.
이 연구는 64.9K에 달하는 방대한 양의 다양하고 현실적인 Cowork 환경과 훈련 데이터를 제공하며, 이를 통해 Post-Training된 Qwen 모델들이 다양한 Agentic Benchmarks에서 Base Checkpoint 대비 상당한 성능 향상을 달성함을 입증했다. 특히, Ours-27B 모델이 PawBench 및 ClawEval에서 최첨단 성능을 달성하며 100B+ 파라미터 모델들을 능가한 것은 합성된 데이터의 높은 훈련 가치를 명확히 보여준다. 이 연구는 실행 가능한 환경의 확장 가능한 구축이 self-evolving agents를 향한 데이터 기반 경로를 제공할 수 있음을 시사한다. Workspace와 사용자 요구 사항이 진화함에 따라 환경 풀을 지속적으로 확장함으로써, 에이전트가 변화하는 작업 환경에 적응하며 지속적으로 개선될 수 있는 가능성을 제시한다.
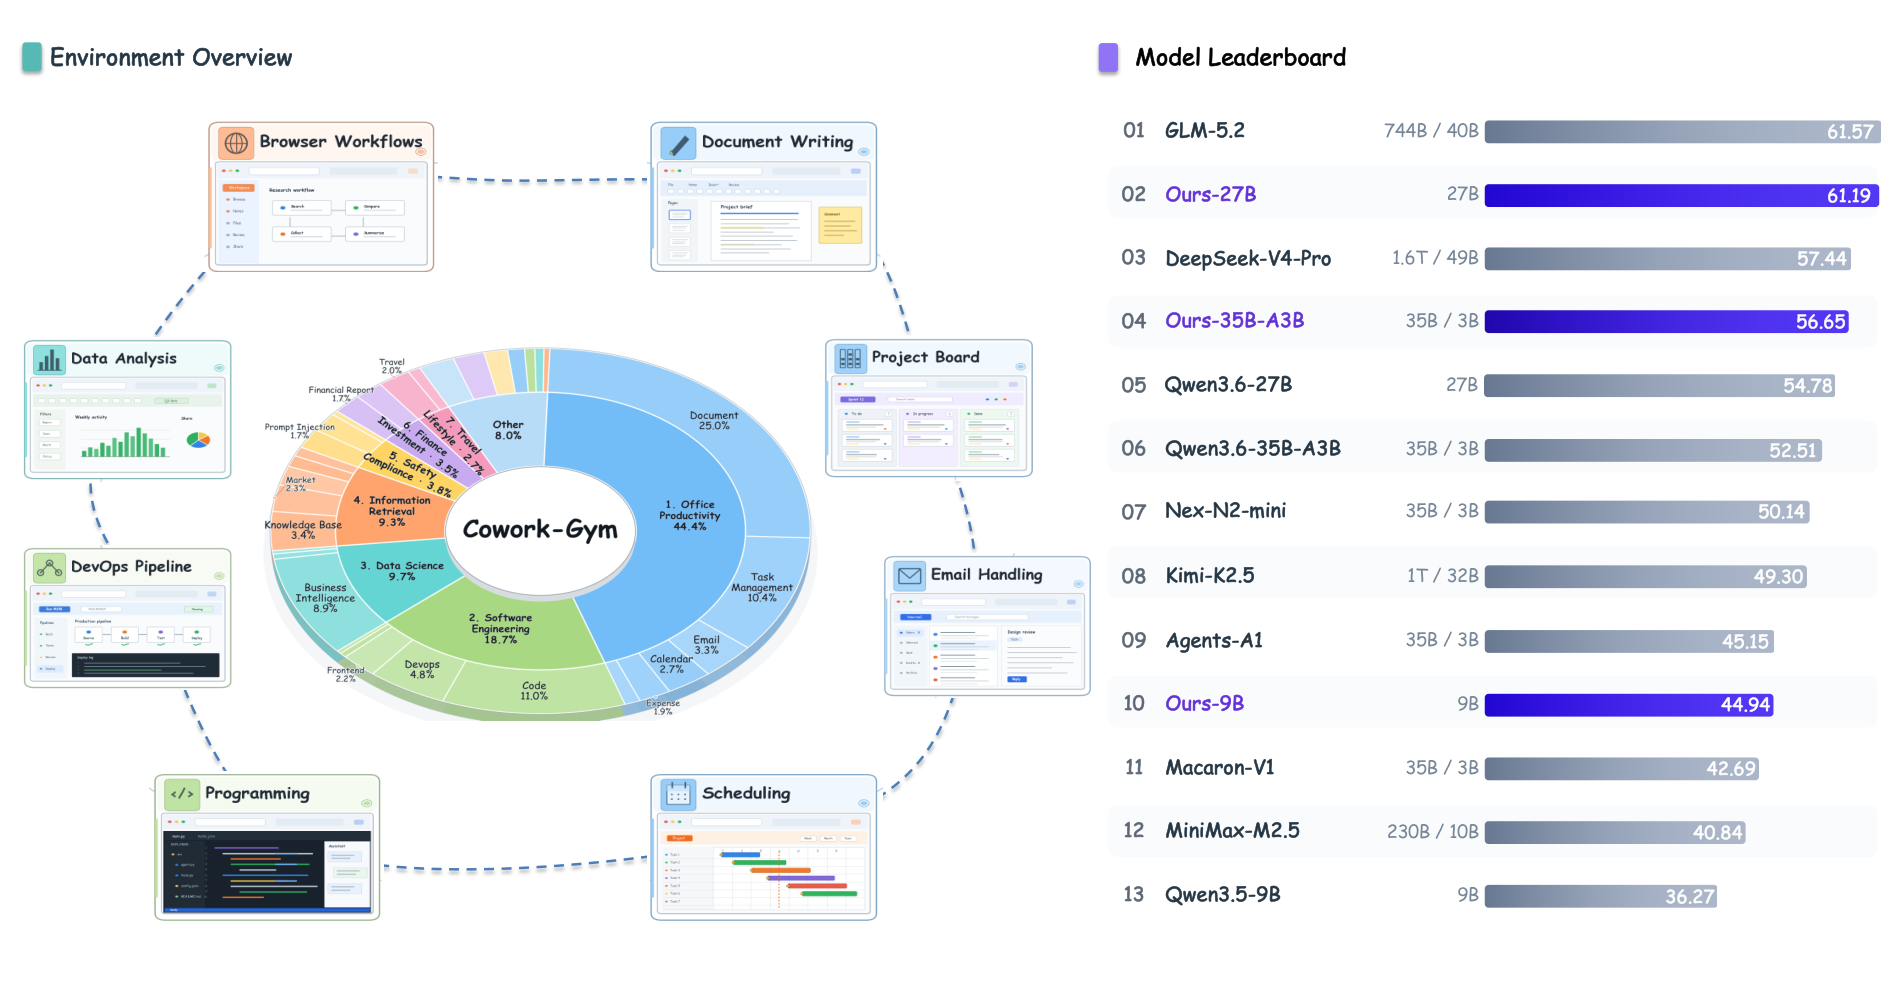
Figure 1 — 합성된 Cowork 환경의 규모와 영향
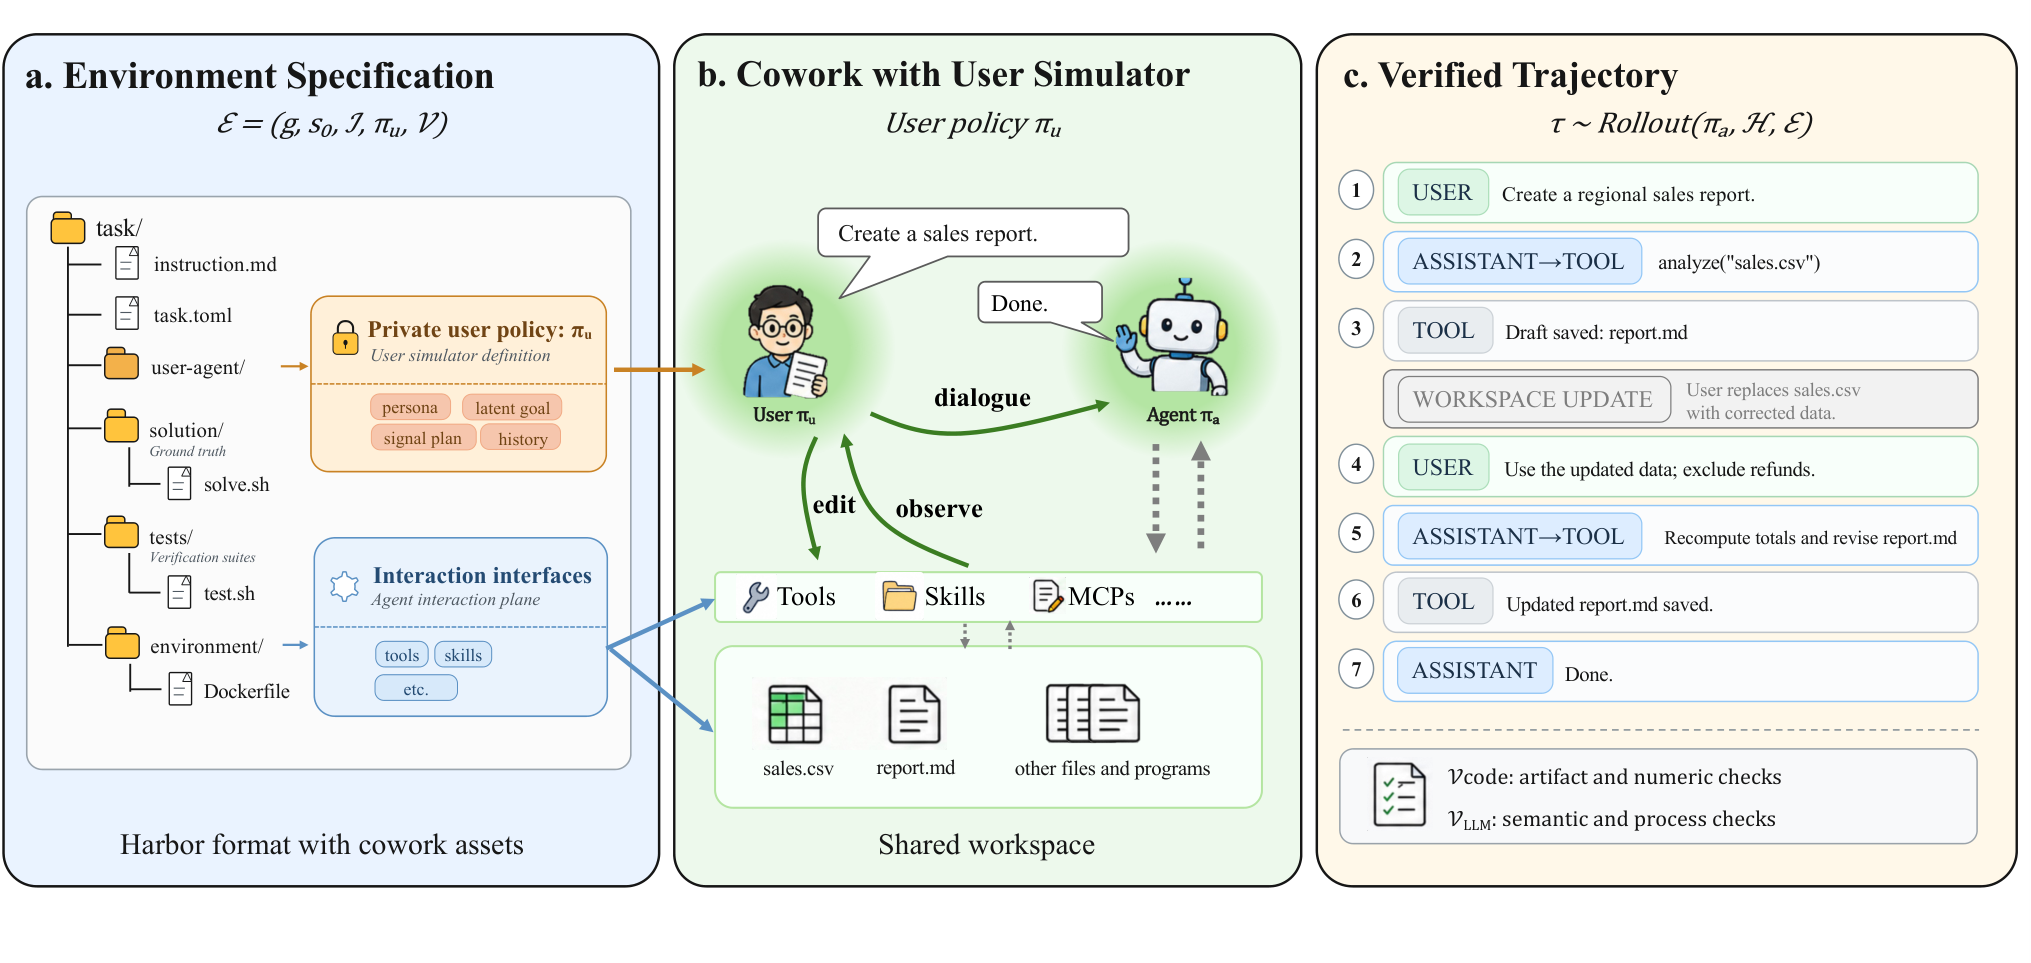
Figure 2 — Cowork 환경 패키징 및 롤아웃
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] Branching On-Policy Distillation
- [논문리뷰] An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
- [논문리뷰] Is Next-Chunk Reasoning RL Really Better than SFT? Revisiting Training Strategies under no-CoT Data
- [논문리뷰] SFT Conflicts, RL Coexists: A Theoretical and Empirical Analysis of Multi-Task Learning for LLMs
Review 의 다른글
- 이전글 [논문리뷰] CoDA: Co-Evolution of Data Engines and Action Policies
- 현재글 : [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- 다음글 [논문리뷰] Data World: Scaling Data Environments from Scratch
댓글