[논문리뷰] WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
링크: 논문 PDF로 바로 열기
저자: Hang He, Linting Wang, Guanming Liu, Bo Mao, Jinxiu Liu, Yiran Suo, Maosen Zhou, Zhiheng Xi, Guanting Dong, Zhou Shao, Rui Zheng, Jie Zhou, Chengcheng Wan, Tao Gui, Qi Zhang, Xipeng Qiu, Xuanjing Huang
1. Key Terms & Definitions (핵심 용어 및 정의)
- WorkRover: 장기적인(long-horizon) 협업 에이전트(cowork agents) 훈련을 위한 프레임워크로,
harness-driven environment synthesis,recursive environment evolution,verifier-grounded policy learning을 통합한다. - Harness:
Work Contexts,Tasks,Verifiers의 구성(construction)을 조정하고, 이들의 의존성(dependencies)을 추적하며, 실행(execution)을 관리하는 시스템이다. 이는 구성 요소들 간의 시맨틱 정렬(semantic alignment)을 보장한다. - Work Context, Task, Verifier:
Work Context는 파일, 기능, 애플리케이션 환경을 제공하고,Task는 목표, 결과물, 제약 조건을 지정하며,Verifier는 태스크 완료를 검증하는 구성 요소이다. 이 세 가지는Harness에 의해 조율된다. - Factorial Compatibility Replay (FCR): 환경 진화(environment evolution)를 지원하는 메커니즘으로, 컴포넌트 수정(component revisions)의 조합을 평가하여 결함(defects)을 수정하고, 태스크 요구사항(task requirements)과 평가 제약(evaluation constraints)을 유지하면서 가장 작은 유효한 수정(validated repair)을 선택한다.
- Verifier-to-Turn Credit Assignment (VTCA): 장기적인 학습 신호(long-horizon learning signals)를 제공하기 위해
trajectory-level GRPO advantages에finer-grained피드백을 추가하는 기법이다. 이는deterministic workspace-progress checks와tool-output,artifact dependencies를 사용하여prerequisite turns에positive-progress credit을 할당한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 long-horizon cowork agents 훈련을 위한 scalable interactive environments 구축의 한계점과 credit assignment의 어려움을 해결하고자 한다. 기존의 construction pipelines는 interactive environments의 초기 생성 후 발생하는 결함(defects)을 수정하고 work context, task specification, verifier와 같은 environment components 간의 정렬(alignment)을 유지하며 반복적으로 환경을 개선하는 데 제한적인 지원을 제공한다. 특히, agent rollouts 과정에서 missing dependencies, inconsistent task specifications, verification errors와 같은 환경적 결함이 노출될 수 있으며, 이러한 결함은 agent의 유효한 행동을 실패로 간주하거나 부정확한 결과를 보상하는 잘못된 훈련 피드백을 초래할 수 있다. 또한, long-horizon tasks에서는 terminal rewards만으로는 useful steps와 redundant actions를 구분하기 어려워 finer-grained credit assignment가 어렵다는 문제가 존재한다. [Figure 2]는 cowork agents 훈련의 주요 도전 과제와 본 논문의 recursive environment evolution 및 verifier-grounded policy learning 접근 방식을 개괄적으로 보여준다.
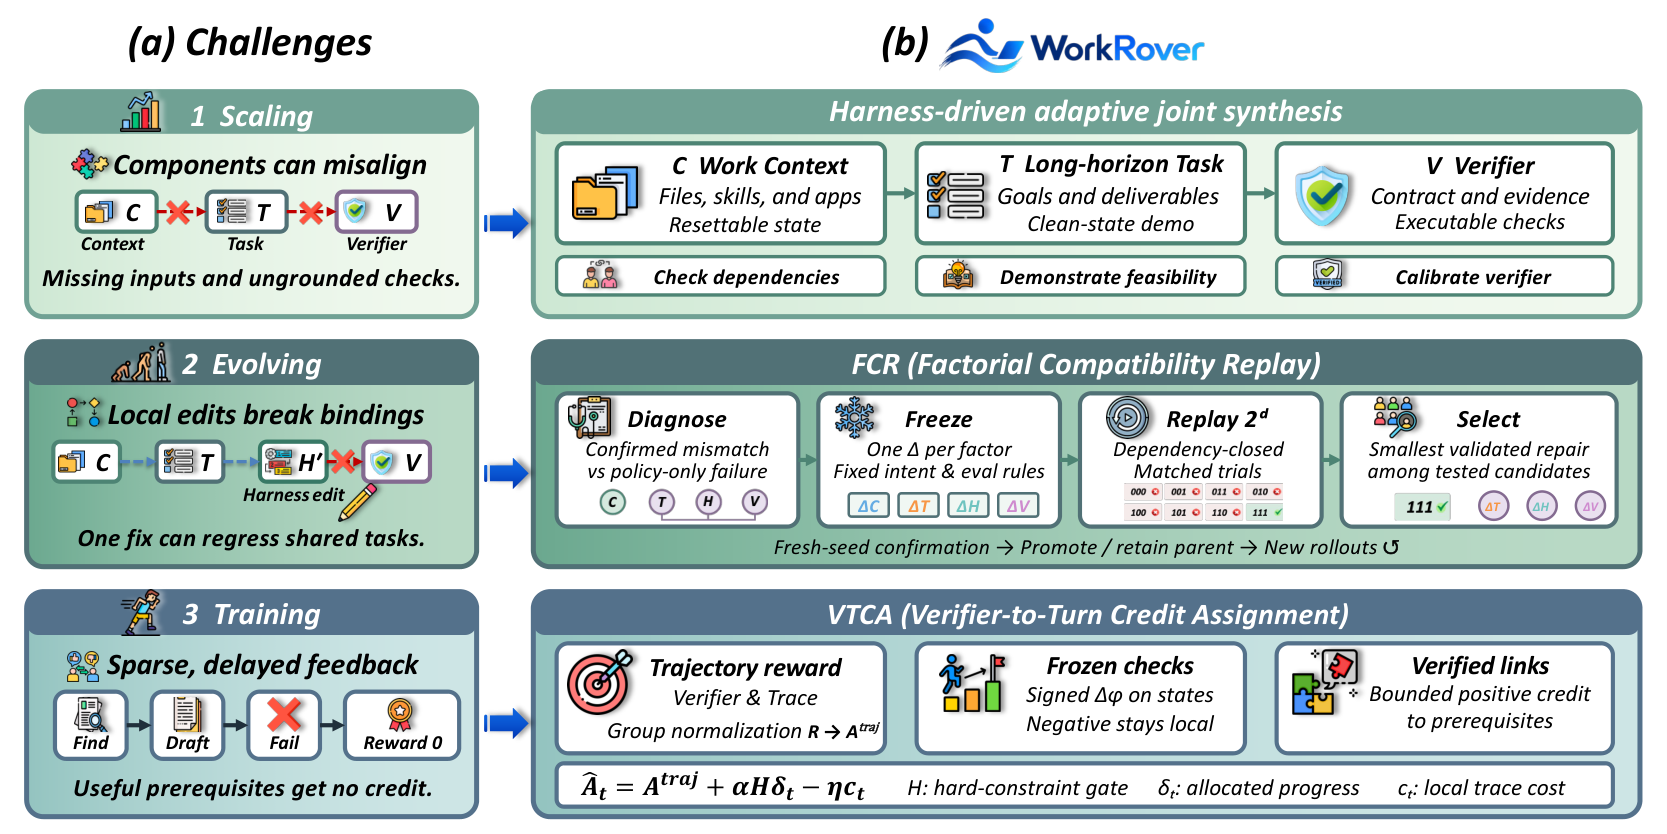
Figure 2 — 도전 과제 및 접근
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 recursive environment evolution을 통해 long-horizon cowork agents를 훈련시키는 WorkRover 프레임워크를 제안한다 [Figure 3]. WorkRover는 harness-driven environment synthesis, Factorial Compatibility Replay (FCR), Verifier-to-Turn Credit Assignment (VTCA) 세 가지 핵심 방법론을 통합한다.
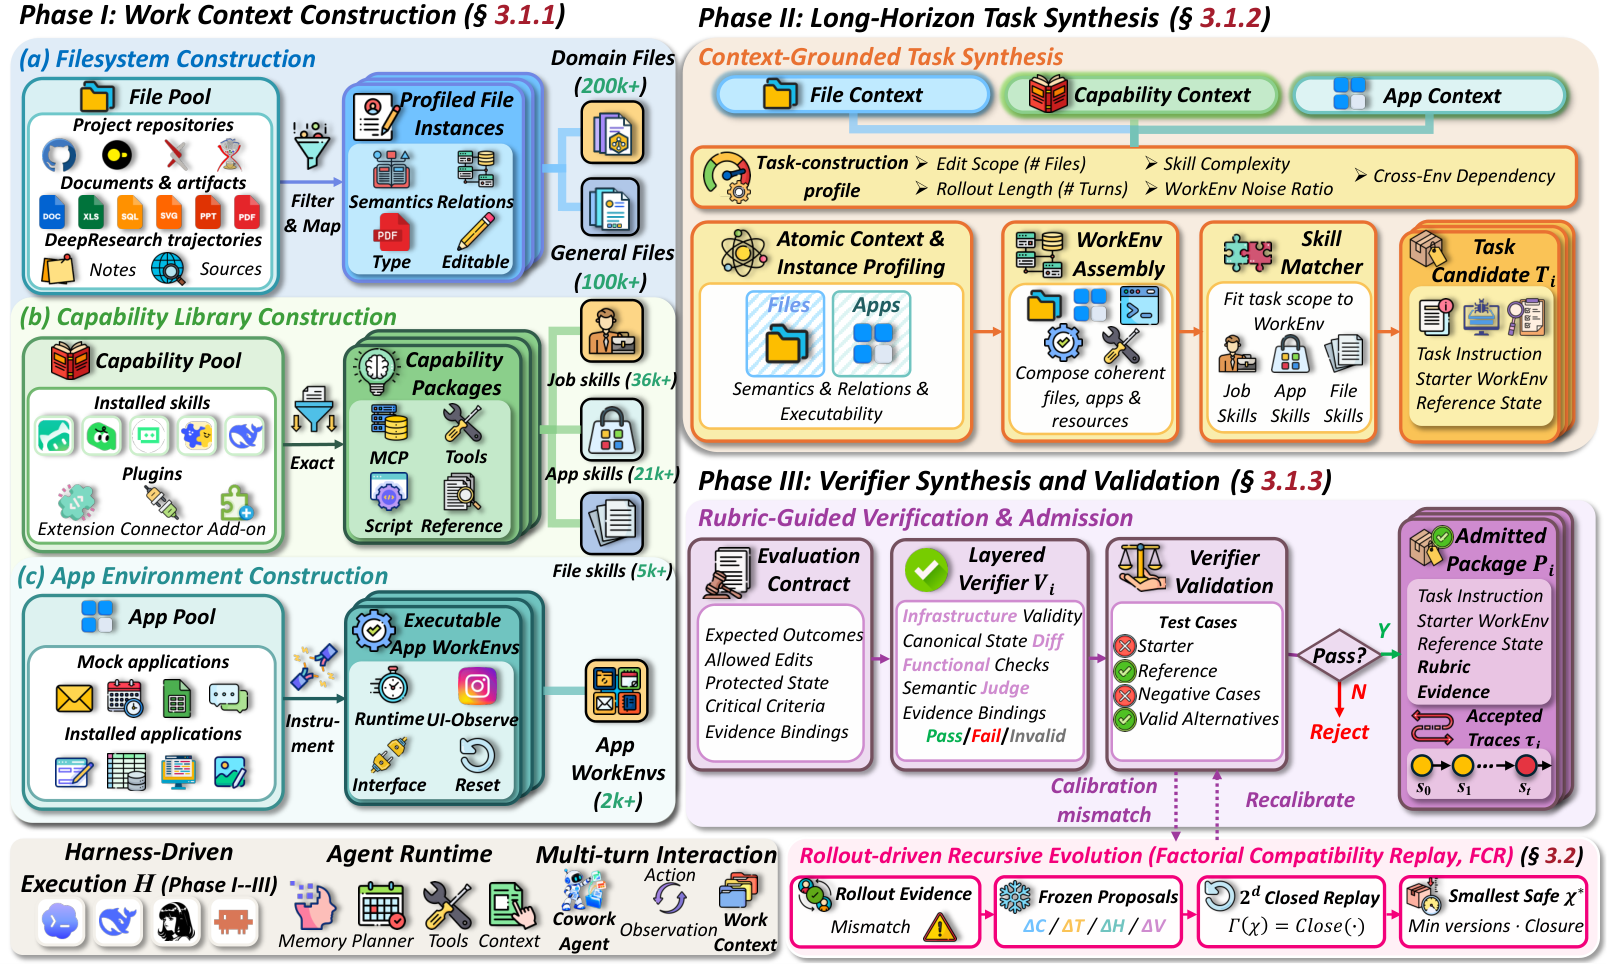
Figure 3 — 환경 구축 및 진화
첫째, Harness-Driven Environment Synthesis는 semantically aligned Work Contexts, executable Tasks, evidence-grounded Verifiers를 공동으로 구축하고 검증한다. Harness는 구성 요소의 dependencies를 추적하며, construction agents가 고정된 워크플로우 대신 workspace state 및 execution feedback에 동적으로 적응하여 construction actions를 수행하도록 한다. 이를 통해 task feasibility 및 verifier consistency를 독립적으로 검증할 수 있다.
둘째, Factorial Compatibility Replay (FCR)는 rollout feedback을 사용하여 work context, task, harness, verifier 등 component revisions의 가능한 조합을 평가한다. dependency-closed replay를 통해 compatible edits를 선택하고, 원래의 task requirements 및 evaluation constraints를 보존하면서 minimal validated repair를 식별 및 적용한다. 실험 결과, FCR은 full regeneration 방식 대비 task-package synthesis pass rate를 6.0 percentage points (49.8%에서 74.8%로) 향상시켰다. 또한, 자연 발생적 결함(naturally occurring defects)에 대한 Safe Resolution Rate (SRR)를 60.7%에서 70.3%로 증가시키고, cross-task regression을 7.0%에서 0.7%로 현저히 감소시켰다. [Figure 7]은 FCR 메커니즘이 joint edits의 필요성과 repair quality의 안정성을 어떻게 유지하는지 보여준다.
셋째, Verifier-to-Turn Credit Assignment (VTCA)는 terminal rewards에 finer-grained 학습 신호를 추가하여 long-horizon learning을 지원한다 [Figure 5]. 이는 frozen deterministic checks를 통해 workspace states의 progress와 setbacks을 측정하고, tool-output 및 artifact dependencies를 사용하여 positive-progress credit을 prerequisite turns에 할당한다. VTCA를 사용하여 Qwen3.5-35B-A3B 모델을 post-training한 결과, WorkRover-35B-A3B는 episode-only GRPO를 모든 벤치마크에서 능가했다. 특히, AutomationBench에서 5.7 percentage points, OfficeQA Pro에서 5.4 percentage points, GDPval v2에서 43 Elo의 성능 향상을 기록했다.
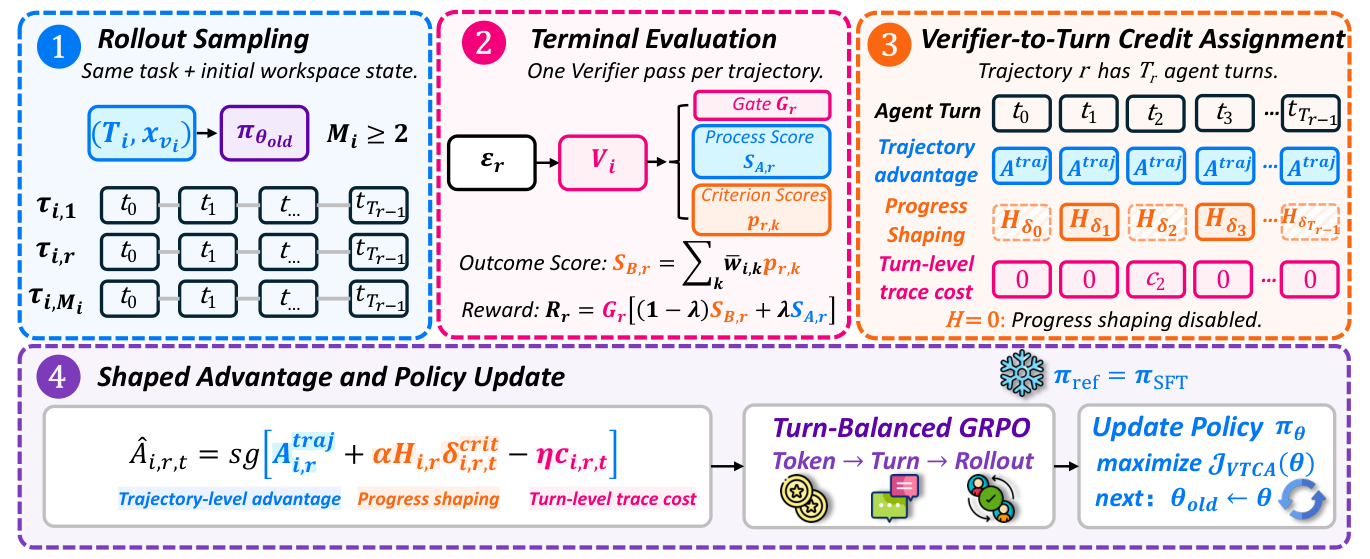
Figure 5 — VTCA 개요
종합적으로, WorkRover-35B-A3B는 기존 Qwen3.5-35B-A3B backbone 대비 JobBench에서 26.27 percentage points, OfficeQA Pro에서 29.32 percentage points, GDPval v2에서 413.25 Elo points의显著한 성능 향상을 보였다. [Table 1]은 주요 cowork-agent benchmarks에서 WorkRover-35B-A3B가 동급 및 일부 대규모 proprietary models 대비 우수한 성능을 달성했음을 보여준다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 execution feedback을 활용하여 long-horizon cowork agents와 이들을 훈련시키는 환경의 신뢰성을 동시에 개선하는 WorkRover 프레임워크의 효과를 입증한다. Harness는 work contexts, tasks, verifiers 간의 semantic alignment를 보장하며 construction 및 repair 과정에서 일관성을 유지한다. Factorial Compatibility Replay (FCR)는 task requirements를 보존하면서 inconsistent components를 효율적으로 수정하여 environment defects를 줄이고 task-package synthesis pass rate를 높인다. Verifier-to-Turn Credit Assignment (VTCA)는 verifier-grounded progress를 통해 finer-grained 학습 신호를 제공하여 agent policy learning의 효과를 극대화한다. 이러한 연구 결과는 recursive environment evolution이 reliable long-horizon cowork agent training을 위한 실용적인 기반을 제공함을 시사하며, 복잡한 실제 환경에서 robust하고 adaptive한 agent behavior 개발에 중요한 기여를 한다. 이 연구는 cowork agents 분야의 scalable training에 대한 새로운 가능성을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EdgeWise: Bringing Long-Horizon Agents to the Edge via Selective Cloud Delegation
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
- [논문리뷰] Environment Evolution for Terminal Agents
- [논문리뷰] SkillGate: Training In-Policy Skill Selection in Long-Horizon Agents
Review 의 다른글
- 이전글 [논문리뷰] VideoJev: System One Model for Video Understanding and Interaction
- 현재글 : [논문리뷰] WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
- 다음글 [논문리뷰] WorldRecon: Generative Multi-View Mesh Reconstruction for Large-Scale 3D World
댓글