[논문리뷰] VideoJev: System One Model for Video Understanding and Interaction
링크: 논문 PDF로 바로 열기
저자: Yuhan Zhu, Xiangyu Zeng, Qingyi Si, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- System One Models: 비디오 이해 및 상호작용을 구조화된 의사결정 태스크로 전환하고, autoregressive generation 없이 직접적으로 유형화된 확률적 판단(probabilistic judgments)을 생성하는 모델 패러다임입니다.
- Temporal Grounding: 자연어 쿼리를 기반으로 비디오 내에서 특정 이벤트가 발생하는 시간 간격(time intervals)을 정확하게 찾아내는 태스크입니다.
- Video QA (Question Answering): 비디오 콘텐츠에 대한 질문에 답변하는 태스크로, 주로 다지선다(multiple-choice) 형식으로 수행됩니다.
- Cached Inference: 동일한 시각적 히스토리(visual history)에 대한 연속적인 쿼리(queries)에 대해 미리 인코딩된 비디오 프리픽스(video prefix)를 재사용하여 중복 계산을 줄이는 추론 방식입니다.
- Joint Inference: 동일한 비디오에 대한 여러 쿼리를 단일 인과적 순방향 패스(causal forward pass)로 처리하여 시각적 계산을 공유하고 모든 쿼리에 대한 스코어를 동시에 생성하는 추론 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 시각 에이전트(visual agents)가 비디오 관찰(video observations)로부터 시기적절한 의사결정(timely decisions)을 내리는 데 필요한 효율성을 해결하고자 합니다. 기존 멀티모달 대규모 언어 모델(MLLMs)은 광범위한 semantic understanding과 유연한 언어 인터페이스를 제공하지만, Temporal Grounding을 위한 타임스탬프(timestamps) 또는 Video QA를 위한 답변 텍스트(answer text)와 같이 compact하고 구조화된 의사결정일지라도 일반적으로 autoregressive generation을 통해 의사결정을 표현하여 비효율적입니다. 이러한 기존 방식은 동일한 visual history에 대해 반복적인 판단(repeated judgments)이 필요할 때 각 추가적인 판단의 비용이 핵심적인 문제가 되므로, 효율적인 직접 예측(efficient direct prediction)과 MLLM의 semantic flexibility를 통합하는 새로운 접근 방식이 요구됩니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 direct candidate scoring과 reusable visual computation이라는 두 가지 원칙을 기반으로 하는 비디오 System One Models의 한 종류인 VideoJev를 제안합니다. VideoJev는 사전 학습된 MLLM을 활용하여 autoregressive answer decoding을 temporal intervals 및 textual options에 대한 스코어를 부여하는 shared head로 대체합니다 [Figure 2, cite: 1]. 이 스코어는 이벤트 스팬(event spans) 또는 답변 선택(answer choices)을 산출하여 Temporal Grounding과 multiple-choice Video QA 태스크를 통합합니다.
VideoJev의 핵심 방법론은 다음과 같습니다. 먼저, 기존 MLLM의 final MLP를 제거하고 language-model output head를 candidate scorer로 대체합니다. temporal grounding의 경우, sigmoid 스코어를 사용하여 쿼리된 이벤트의 interval membership을 예측하고 이를 연속적인 스팬(contiguous span)으로 구성하며, multi-label binary cross-entropy (L_BCE) 및 soft Intersection-over-Union (L_IoU) 손실로 학습합니다. multiple-choice Video QA의 경우, softmax를 사용하여 textual options의 확률을 정규화하고 cross-entropy (L_CE) 손실로 학습하며, position bias를 줄이기 위해 훈련 시 answer-independent permutation을 적용합니다. 또한, Cached inference와 Joint inference의 두 가지 inference modes를 통해 시각적 계산을 재사용하여 효율성을 극대화합니다 [Figure 2, Figure 3, cite: 1]. 훈련은 two-stage training 레시피를 따르며, 첫 번째 단계에서는 scorer를 fixed pretrained features에 맞춰 정렬하고, 두 번째 단계에서는 language backbone과 aligned head를 함께 fine-tune합니다.
실험 결과, VideoJev는 Temporal Grounding 벤치마크에서 뛰어난 성능과 inference efficiency를 보였습니다. VideoJev-4B는 Qwen3.5-4B backbone 대비 평균 mIoU를 6.7 포인트 향상시켰으며, VideoJev-35B-A3B는 Qwen3.6-35B-A3B backbone 대비 평균 mIoU를 10.8 포인트 향상시켰습니다. inference speedups는 2.8-3.1배에 달했습니다. Video QA 벤치마크에서는 두 모델 모두 Thinking mode의 backbone과 비견할 만한 성능을 유지하면서 inference speedups가 100배를 초과했습니다. 특히, ablations 연구를 통해 동일한 훈련 데이터 및 스케줄에서 autoregressive fine-tuning 대비 평균 grounding mIoU 1.3 포인트, 평균 QA score 1.9 포인트 향상을 달성하여 architectural benefits를 입증했습니다. 또한 Joint inference가 Cached inference보다 평균 grounding/QA scores를 각각 0.8/0.5 포인트(4B 모델) 및 0.3/0.7 포인트(35B-A3B 모델) 향상시키는 것으로 나타났습니다. Joint training 또한 모든 벤치마크에서 성능을 향상시키며, mean grounding mIoU는 0.7 포인트, mean QA score는 1.3 포인트 증가했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 direct candidate scoring을 통해 Temporal Grounding과 multiple-choice Video QA를 통합하는 VideoJev 모델 패밀리를 제안합니다. Cached inference와 Joint inference를 활용한 reusable visual computation은 반복적인 판단(repeated judgments)에서 높은 inference efficiency를 가능하게 합니다. VideoJev는 다양한 벤치마크에서 강력한 prediction quality와 inference efficiency를 보여주었으며, 특히 ablations 연구는 이러한 성능 향상이 단순히 훈련 데이터 증가를 넘어선 architectural design의 이점을 포함하며, 두 태스크의 joint learning이 상호 이점을 제공함을 확인했습니다. 궁극적으로 VideoJev는 구조화된 판단을 복잡하고 open-ended workflows로 구성하는 visual agents를 위한 강력한 기반을 제공하여, 향후 general-purpose visual decisions 및 streaming visual interaction 분야에 큰 시사점을 줍니다.
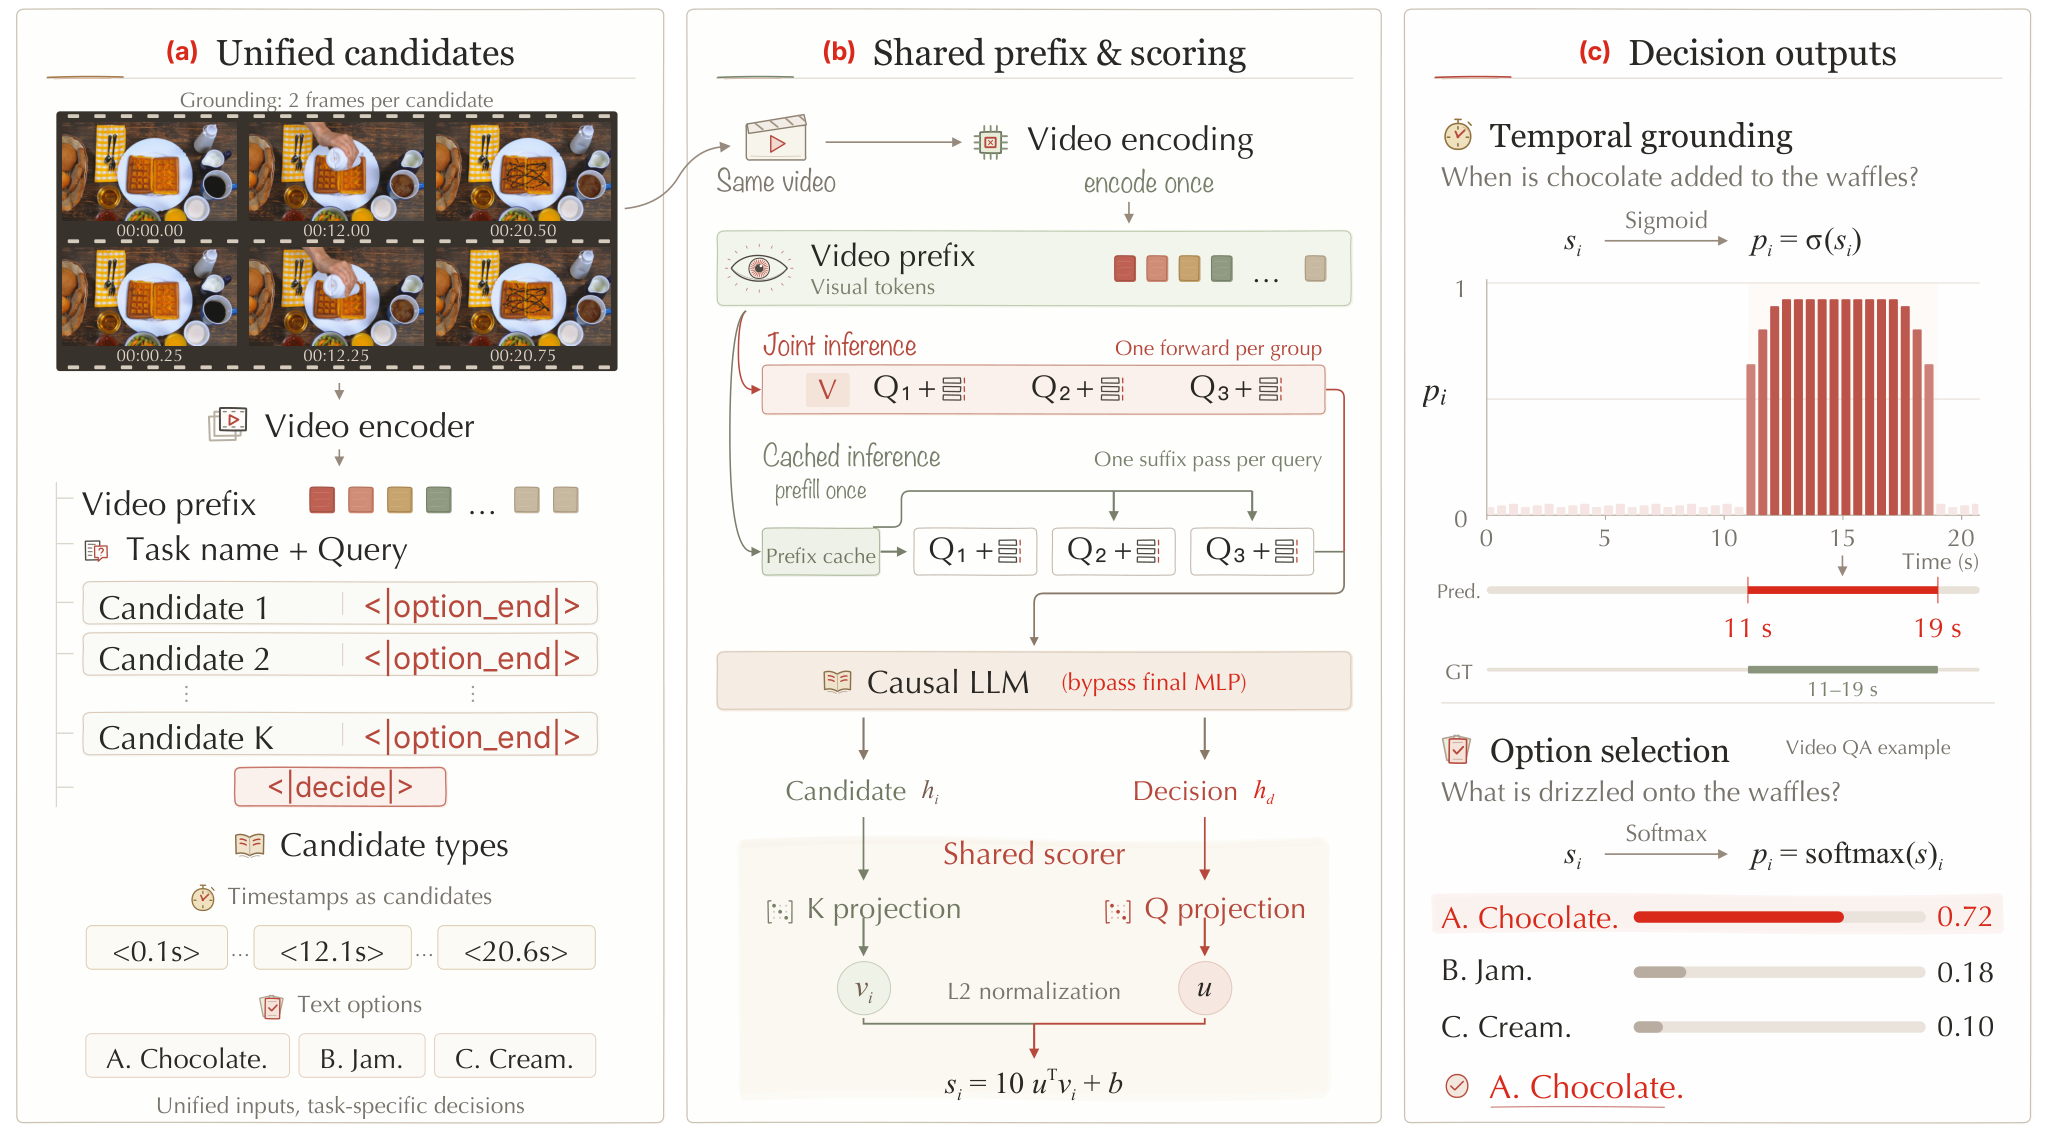
Figure 2 — 제안 모델 아키텍처 및 추론 모드
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VideoAuto-R1: Video Auto Reasoning via Thinking Once, Answering Twice
- [논문리뷰] VideoSSR: Video Self-Supervised Reinforcement Learning
- [논문리뷰] OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
- [논문리뷰] TimeLens2: Generalist Video Temporal Grounding with Multimodal LLMs
- [논문리뷰] Watch, Remember, Reason: Human-View Video Understanding with MLLMs
Review 의 다른글
- 이전글 [논문리뷰] Vela: User Behavior as Supervision Sparks LLM Intelligence
- 현재글 : [논문리뷰] VideoJev: System One Model for Video Understanding and Interaction
- 다음글 [논문리뷰] WorkRover: Scaling Long-Horizon Cowork Agent Training Via Recursive Environment Evolution
댓글