[논문리뷰] Vela: User Behavior as Supervision Sparks LLM Intelligence
링크: 논문 PDF로 바로 열기
저자: Yang Xiao, Yusong Sun, Haoyi Wu, Wenyang Hui, Weiqiang Hang, Luqing Wang, Zejian Wang, Zirui Tu, Jingsheng Mao, Shaobo Hu, Yang Luo, Jiale Guo, Jin Zhang, Yudan Liu, Zhaokai Luo, Ren Huan, Yao Hu, Chengyue Jiang, Wenjie Li, Chuan Mu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Vela: 실제 사용자 행동 데이터를 LLM 학습을 위한 trainable task와 trajectory로 변환하여 "user behavior as supervision" 패러다임을 구현하는 프레임워크입니다.
- User Behavior as Supervision: 사용자 행동 기록(sequence of actions)을 LLM의 학습 신호(supervisory signal)로 활용하여 사용자 관련 intelligence를 향상시키는 패러다임입니다.
- VelaBench: Vela 프레임워크 내에서 정의된 91개의 task template에서 파생된 982개의 held-out evaluation task로 구성된 in-domain 벤치마크로, 사용자 관련 성능을 평가합니다.
- Predictive Questions: Vela의 task family 중 하나로, LLM이 가시적 행동 이력(H<t)을 기반으로 미래 사용자 행동을 예측하며, 숨겨진 미래 행동(H>t)에서 파생된 ground-truth answer와 비교하여 점수가 매겨집니다.
- Rubric Questions: Vela의 task family 중 하나로, LLM이 가시적 행동 이력(H<t)을 기반으로 사용자 속성이나 관심사를 요약하거나 관찰된 행동을 설명하며, task-specific rubric에 따라 점수가 매겨집니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
대규모 언어 모델(LLM)은 개인 비서 및 추천 시스템과 같은 실제 애플리케이션에 점점 더 많이 배포되고 있지만, "user dimension of LLM intelligence" 측면에서 한계를 보입니다. 기존 LLM은 주로 static text나 synthetic data로 학습되어 사용자 행동이 시간 흐름에 따라 어떻게 진화하는지 포착하지 못합니다. 이러한 한계로 인해 모델은 평균 사용자 프로필로 편향되거나, 긴 이력에 대한 정확도가 떨어지며, 개인화 능력이 부족한 문제가 발생합니다. 따라서 사용자 관련 LLM intelligence를 향상시키기 위해서는 실제 사용자 행동 데이터를 직접적인 supervisory signal로 활용하는 새로운 접근 방식이 필요합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 "user behavior as supervision" 패러다임을 구현하기 위해 실제 사용자 행동 데이터를 trainable task 및 trajectory로 변환하는 프레임워크인 Vela를 제안합니다. Vela는 100,000명의 익명화된 사용자 행동 기록에서 91개의 real-world task template을 사용하여 100,000개의 composite task를 생성합니다. 이 task들은 Predictive와 Rubric 두 가지 family로 나뉘며, [Figure 2]는 Vela 프레임워크의 개요를 보여줍니다. Qwen3.6-35B-A3B 모델을 사용하여 difficulty-based filtering을 통해 약 75,000개의 task를 선별하고, 학습 trajectories를 생성하여 Vela-Instruct 및 Vela-RFT training corpora를 구축합니다. 이 데이터로 Fine-tuning한 Vela-35B-A3B 모델은 베이스 모델인 Qwen3.6-35B-A3B 대비 사용자 관련 task에서 최대 11.5점 향상된 성능을 보였으며, [Table 1]에서 상세한 벤치마크 결과를 확인할 수 있습니다. 특히 in-domain 벤치마크인 VelaBench에서는 63.0점을 기록하여 베이스 모델보다 11.5점 높은 성능을 달성했습니다. 사용자 관련 OOD 벤치마크에서는 평균 6.2점 향상되었고, AdRecommendation에서는 11.2점의 가장 큰 폭의 개선을 보였습니다. 또한, general OOD 벤치마크에서도 평균 4점 향상되는 것을 확인했습니다. 데이터 스케일링 실험 결과는 [Figure 5]에 제시되어 있으며, 더 많은 사용자 행동 데이터를 학습할수록 LLM intelligence가 지속적으로 향상됨을 보여주었습니다. Fine-tuning 후 Reinforcement learning (RL)을 적용했을 때, Vela-35B-A3B로 초기화된 RL 모델은 베이스 모델로 초기화된 RL 모델보다 사용자 관련 task에서 최대 7.7점 더 높은 성능을 기록했습니다 [Figure 6].
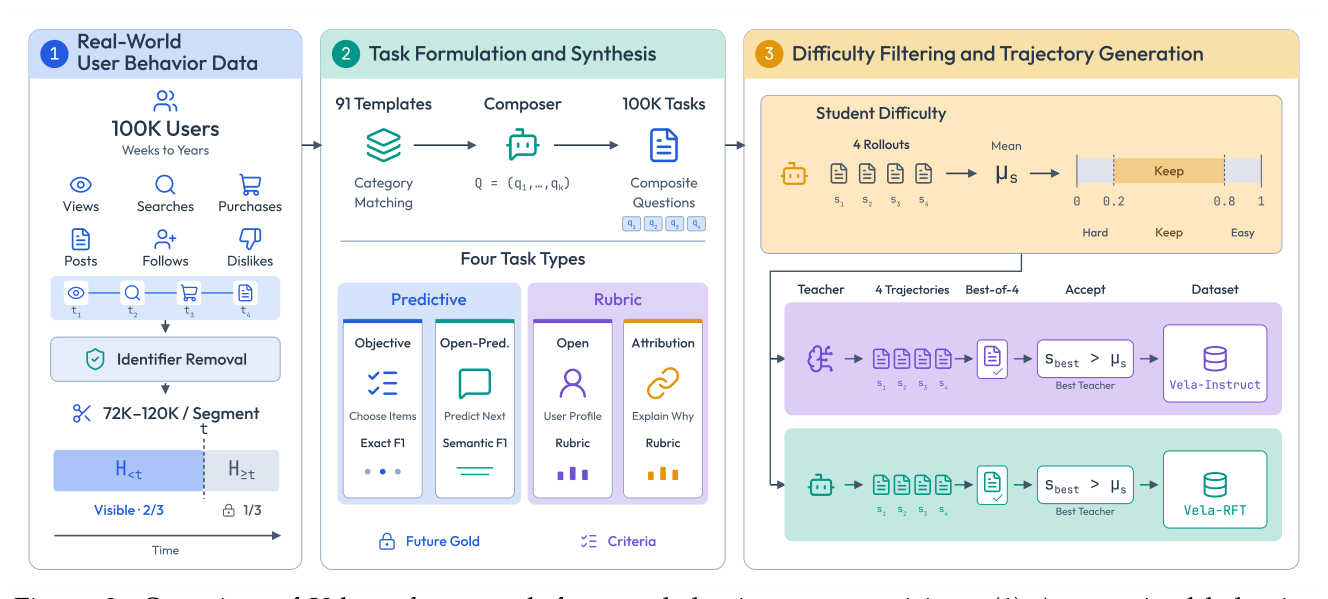
Figure 2 — Vela 프레임워크의 전체적인 구조와 데이터 처리, task 생성, 필터링 과정을 설명하는 핵심 다이어그램
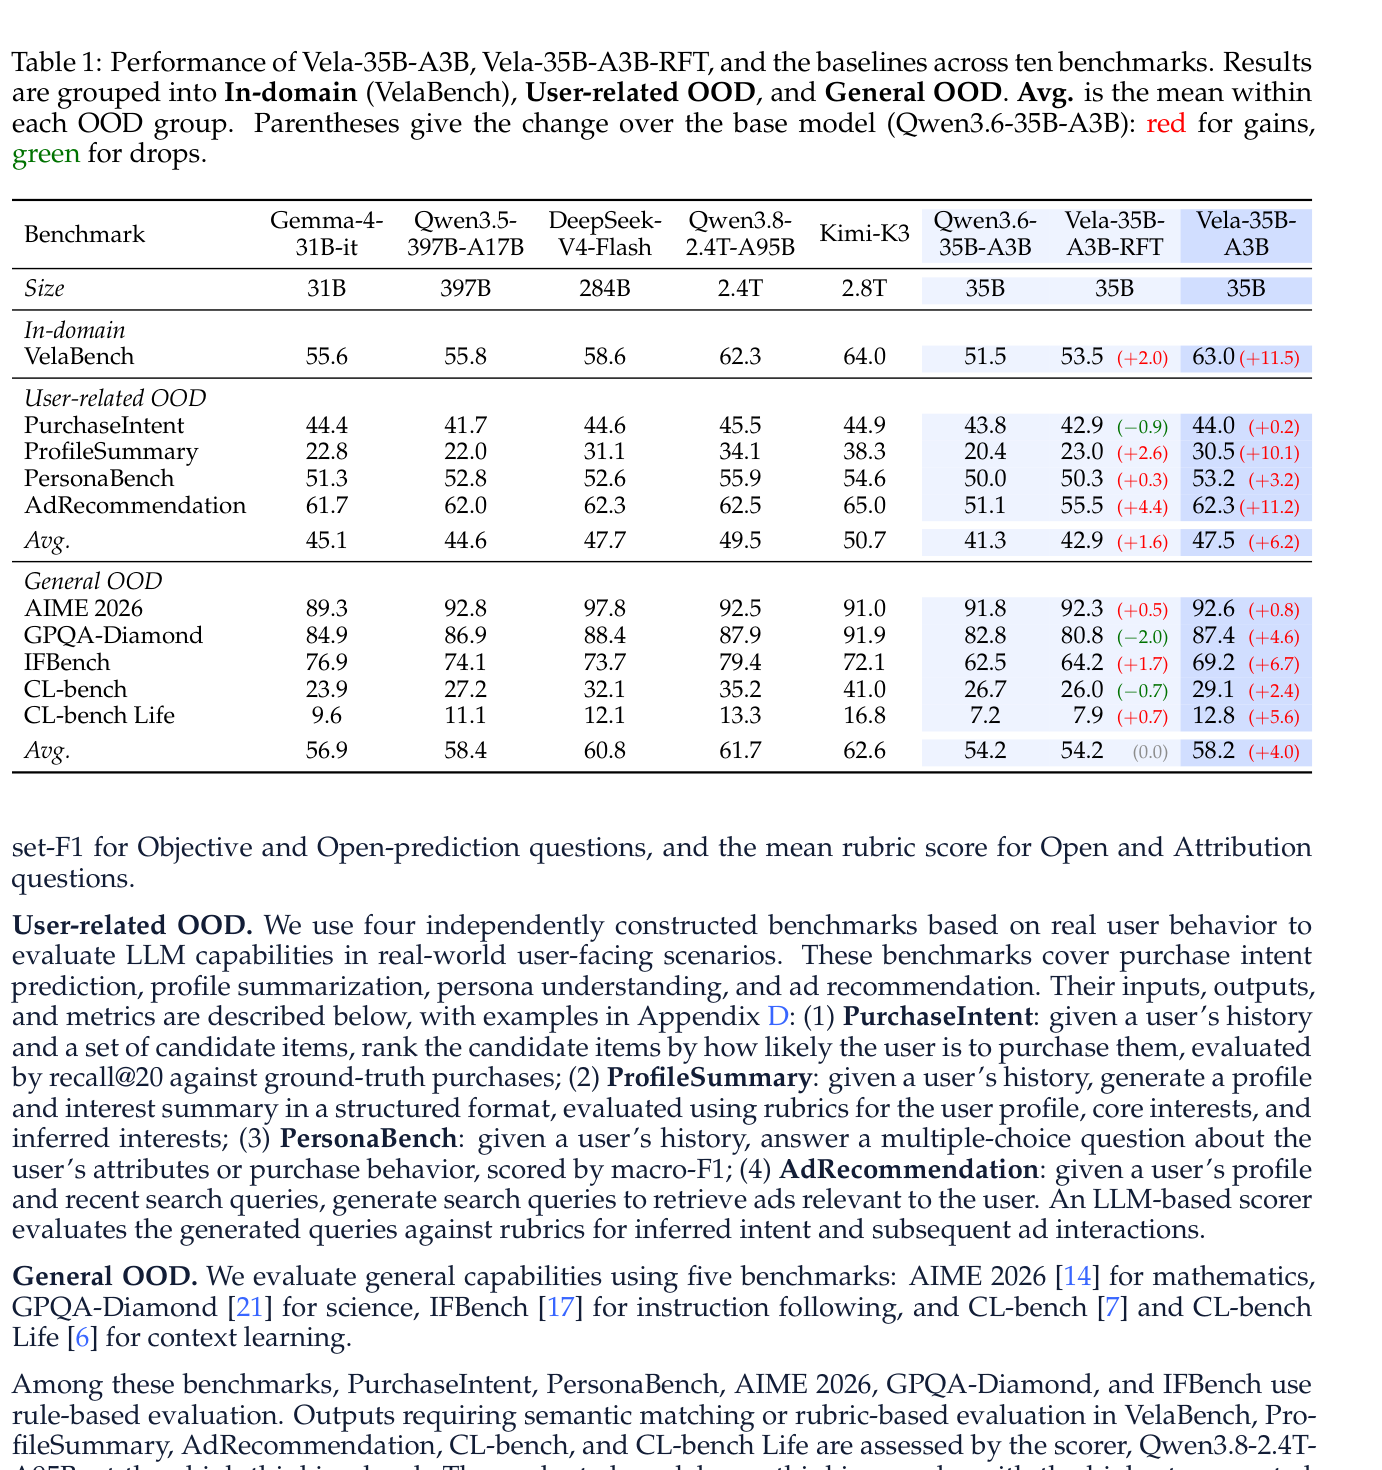
Table 1 — Vela 모델과 다양한 baseline 모델들의 in-domain, user-related OOD, general OOD 벤치마크에 대한 정량적 성능 비교표
4. Conclusion & Impact (결론 및 시사점)
본 연구는 실제 사용자 행동을 supervision으로 활용하는 것이 LLM의 사용자 관련 기능뿐만 아니라 전반적인 intelligence를 향상시키는 데 매우 효과적임을 입증했습니다. Vela 프레임워크는 실제 사용자 행동 이력을 LLM 학습에 활용할 수 있는 효과적인 task와 trajectory로 성공적으로 변환합니다. 이러한 결과는 real-world 사용자 행동이 LLM 학습을 위한 확장 가능하고 강력한 supervision 소스임을 확립하며, 사용자 중심의 AI 시스템 개발과 LLM의 광범위한 역량 강화에 중요한 시사점을 제공합니다.
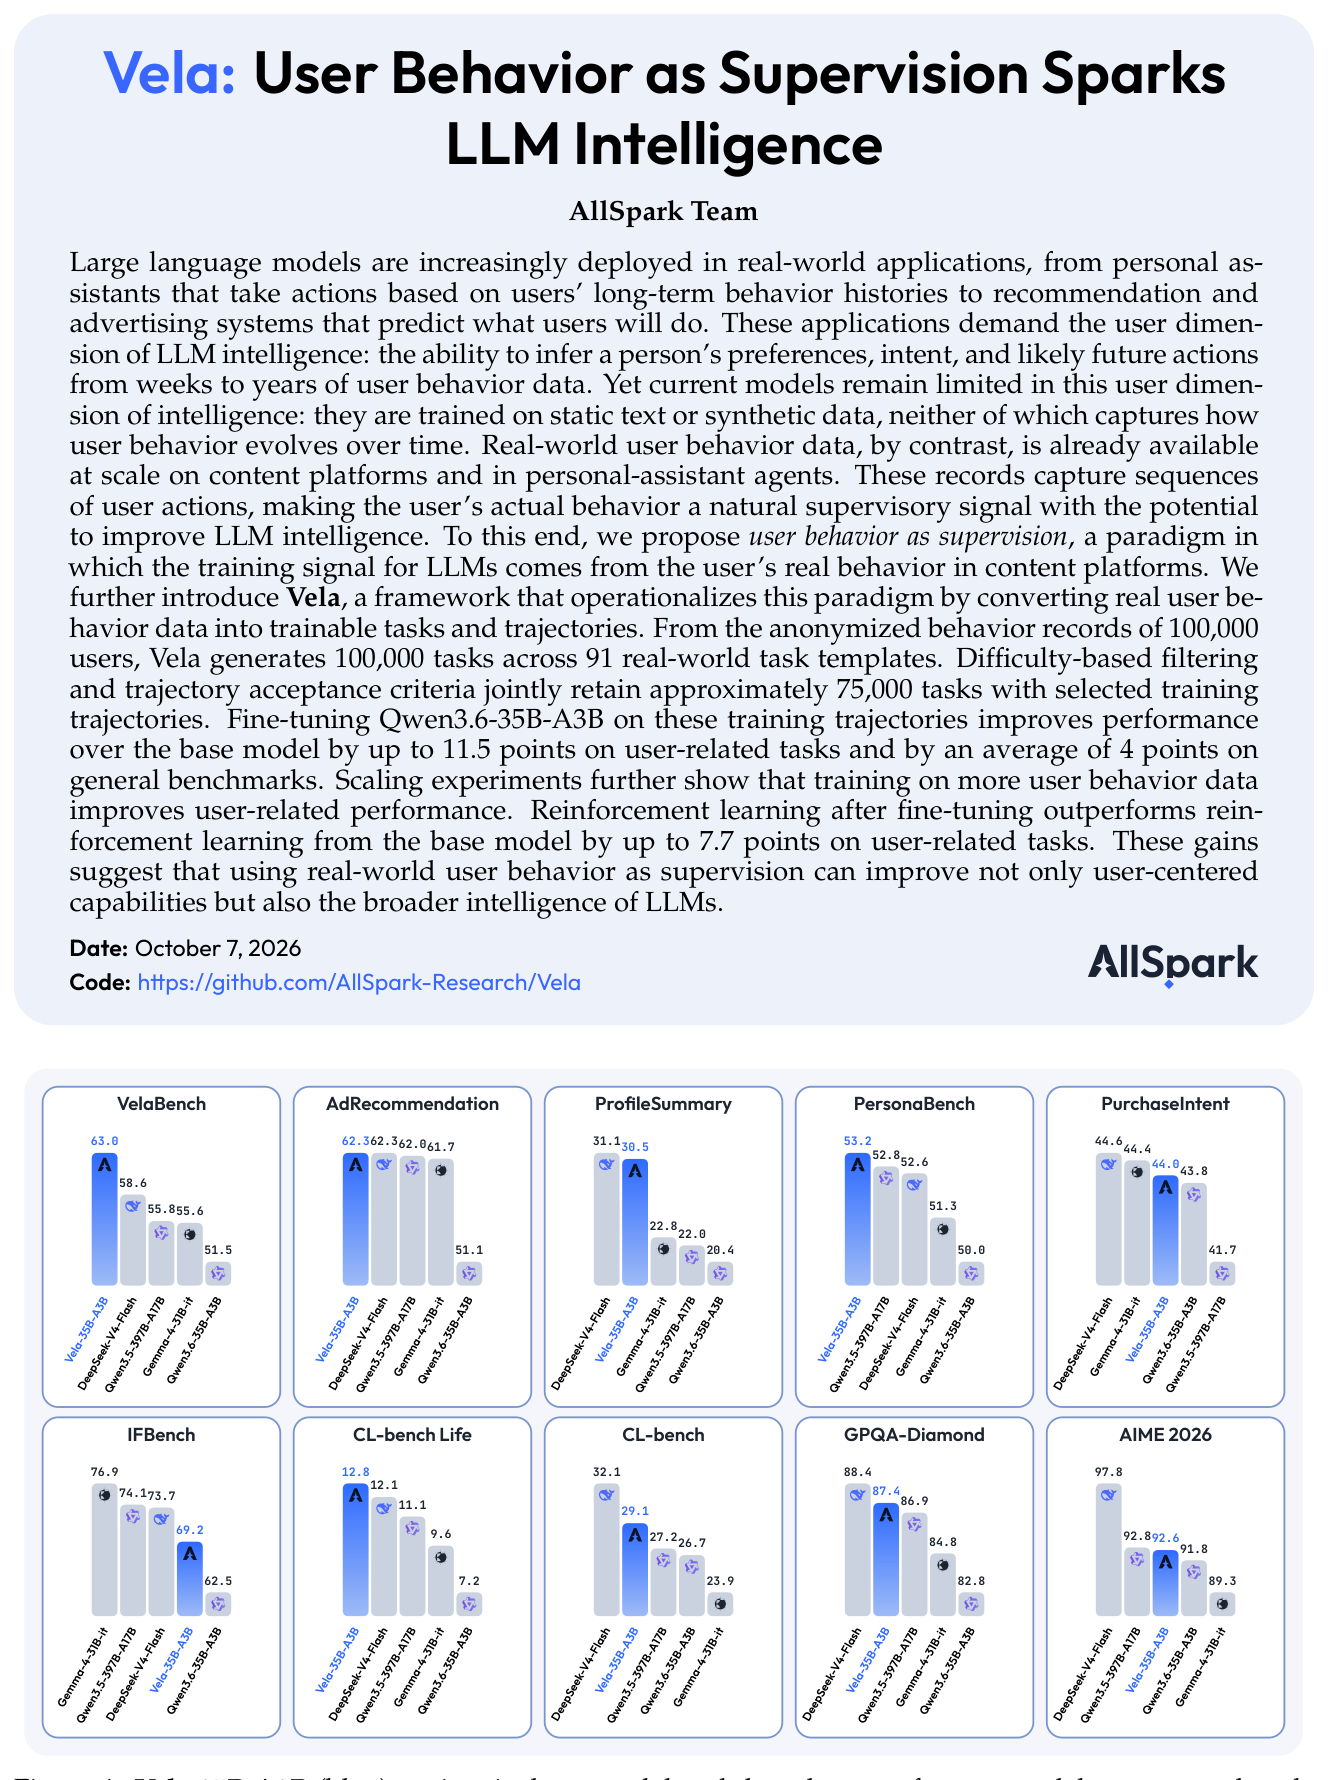
Figure 1 — Vela 모델과 다른 LLM들의 벤치마크 성능 비교 결과를 시각적으로 요약
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rubric-Based Benchmarking and Reinforcement Learning for Advancing LLM Instruction Following
- [논문리뷰] Q-Learning with Scalar Adjoint Matching
- [논문리뷰] Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
- [논문리뷰] A Zeroth-Order Paradigm for LLM Preference Alignment
- [논문리뷰] It Takes Two to Match: Co-Evolving Generative Retriever with Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
- 현재글 : [논문리뷰] Vela: User Behavior as Supervision Sparks LLM Intelligence
- 다음글 [논문리뷰] VideoJev: System One Model for Video Understanding and Interaction
댓글