[논문리뷰] Data World: Scaling Data Environments from Scratch
링크: 논문 PDF로 바로 열기
저자: Zhanli Li, Zeyuan Xu, Chaoxu Pang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Data World: 본 논문에서 제안하는 프레임워크로, 데이터 에이전트 훈련을 위한 환경, 태스크 및 루브릭을 명시적 메커니즘을 통해 합성하는 다중 에이전트 엔진입니다.
- DataWorld-Bench: Data World 엔진에서 파생된 벤치마크로, 50개의 held-out world와 16개 도메인에서 추출된 100개의 태스크로 구성되어 에이전트의 계산 및 인사이트 발견 능력을 평가합니다.
- Computation-Insight Gap: 데이터 처리 및 계산의 정확성과 분석적 인사이트 발견 능력 간의 성능 차이를 나타내는 지표로, 강력한 계산 능력이 자동으로 타겟 분석적 결론으로 이어지지 않을 수 있음을 시사합니다.
- RL-zero training: 기존 모델의 궤적 증류(trajectory distillation) 없이 합성된 태스크와 루브릭 보상만을 사용하여 모델을 훈련하는 Reinforcement Learning 접근 방식입니다.
- World Contract: Data World 내에서 Dependency Skeleton을 구체화하는 구조화된 계약으로, 세계의 엔티티, 타임라인, 생성 메커니즘, 전역 불변량(global invariants), 관측 시스템 및 재계산 가능한 현상(recomputable phenomena)을 정의합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 데이터 에이전트 훈련 스케일링에 있어 환경 큐레이션 비용, 프라이버시 및 지적 재산권 제약, 그리고 개방형 분석 결과 검증의 어려움이라는 핵심 문제를 해결하고자 합니다. 기존 데이터 에이전트 훈련 환경은 실제 데이터 또는 기존 파일 탐색에 의존하기 때문에, 환경 다양성 및 접근성 확보가 어렵고, underlying generative process가 불분명하여 유효한 findings를 검증하기 어렵습니다. 예를 들어, 데이터 큐레이터나 mining 모델이 기존 파일을 탐색하여 태스크와 루브릭을 작성할 때, 데이터 복잡성으로 인해 중요한 설명을 놓치거나 underlying 메커니즘이 모호해질 수 있습니다. [Figure 1]은 기존 탐색 기반 합성 방식이 유효한 findings를 놓치거나 매칭 기준이 부족할 수 있음을 보여주며, 이는 데이터 에이전트가 목표 findings와 정렬된 루브릭 기준을 가지기 어렵게 만듭니다. 따라서 저자들은 파일 자체를 생성하기 전에 파일 뒤에 있는 "세계"를 명시함으로써, 이러한 한계점을 극복하고 확장 가능한 데이터 환경과 검증 가능한 supervision을 제공하는 새로운 접근 방식의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 메커니즘 우선(mechanism-first) 원칙을 기반으로 데이터 환경, 태스크, 루브릭을 합성하는 다중 에이전트 엔진인 Data World를 제안합니다. 제안된 프레임워크는 [Figure 2]에 나타난 바와 같이, Dependency Skeleton G를 구조화된 World Contract C로 구체화하고, 이를 기반으로 계층별 에이전트가 Canonical State X를 생성한 후, Observation Map O를 적용하여 analyst-visible한 데이터 환경 E를 산출합니다. 이후 독립적인 Auditor는 명시된 관계, 전역 불변량 및 타겟 현상의 recoverability를 검증하여, 생성된 기록이 태스크와 루브릭의 기반이 되도록 합니다. 이 엔진은 DataWorld-Bench라는 벤치마크를 도출하는데, 이는 50개의 held-out world에서 엄선된 100개의 테스트 태스크와 16개 도메인을 포함하며, RL-zero training을 위한 1,037개의 disjoint world에서 2,135개의 훈련 태스크를 추가로 생성합니다.
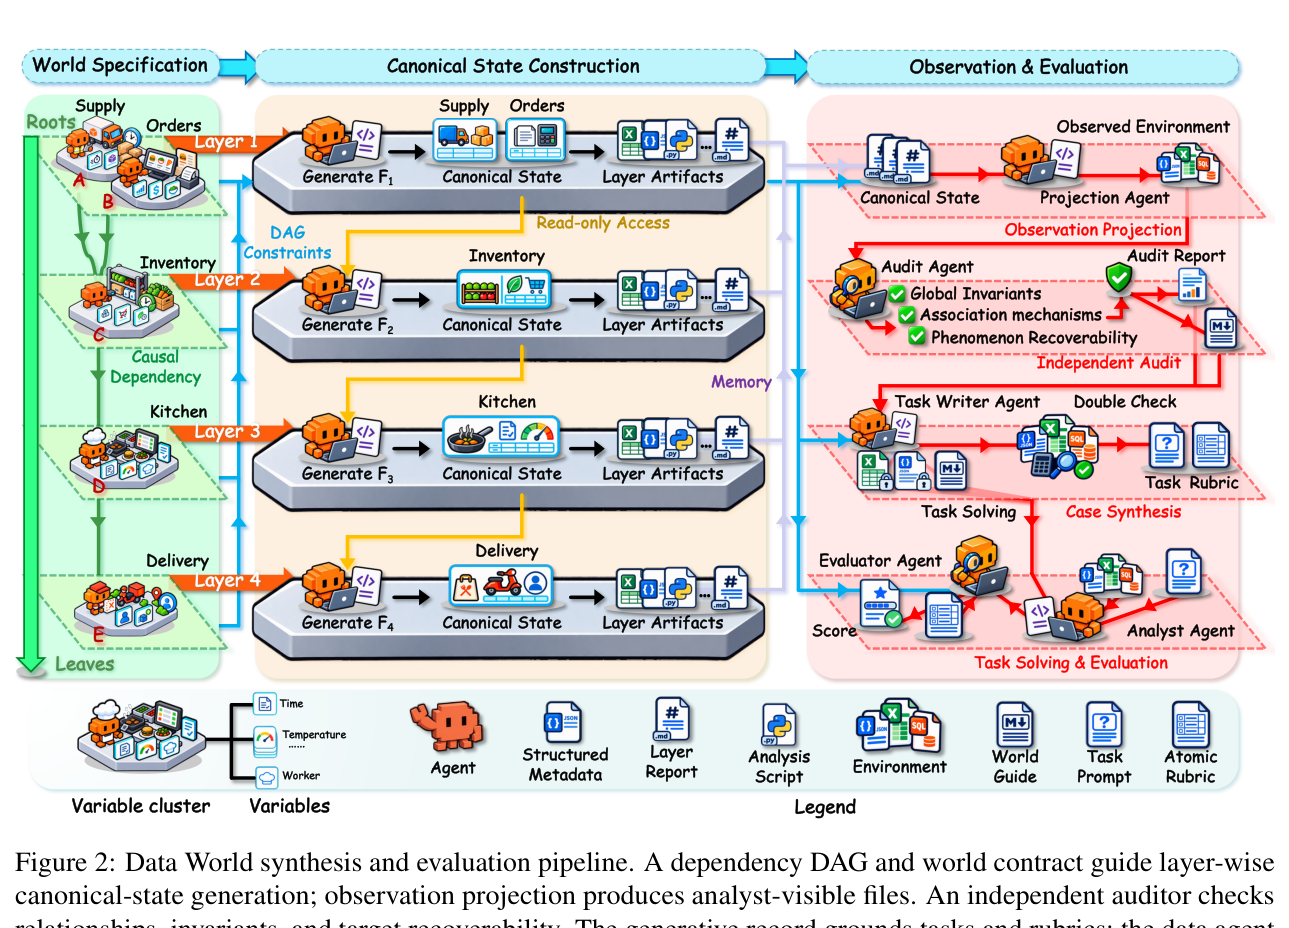
Figure 2 — Data World의 다중 에이전트 기반 합성 및 평가 파이프라인의 전체 아키텍처를 보여주는 핵심 다이어그램
주요 실험 결과에 따르면, DataWorld-Bench는 Frontier 에이전트들에게 여전히 도전적인 벤치마크로 나타났습니다. [Table 1]에서 GPT-6-Astra는 전체 점수 74.43점으로 가장 우수했으며, Qwen-3.8-Max-0902는 인사이트 발견에서 67.95점으로 가장 높은 점수를 기록했습니다. 모든 모델에서 4.87점에서 21.35점에 이르는 일관된 Computation-Insight Gap이 관찰되었는데, 이는 강력한 데이터 처리 능력이 자동으로 타겟 분석적 결론으로 이어지지 않음을 시사합니다. 또한, 합성된 태스크에 대한 RL-zero training은 상당한 성능 향상을 가져왔습니다. 특히, Qwen3.6-35B-A3B 기반으로 훈련된 DataWorld-35B-A3B는 held-out world의 DataWorld-Bench에서 베이스라인 대비 7.06점 향상되었으며, DAComp에서 14.28점, DABstep-Hard에서 20.90점, JobBench에서 12.13점 향상되어 외부 벤치마크에서도 우수한 일반화 성능을 입증했습니다. [Figure 4]는 RL 훈련 단계에 따라 모든 벤치마크에서 점수가 꾸준히 상승하는 궤적을 명확히 보여주며, 합성된 태스크와 메커니즘 기반 보상 결합의 훈련 가치를 강조합니다.
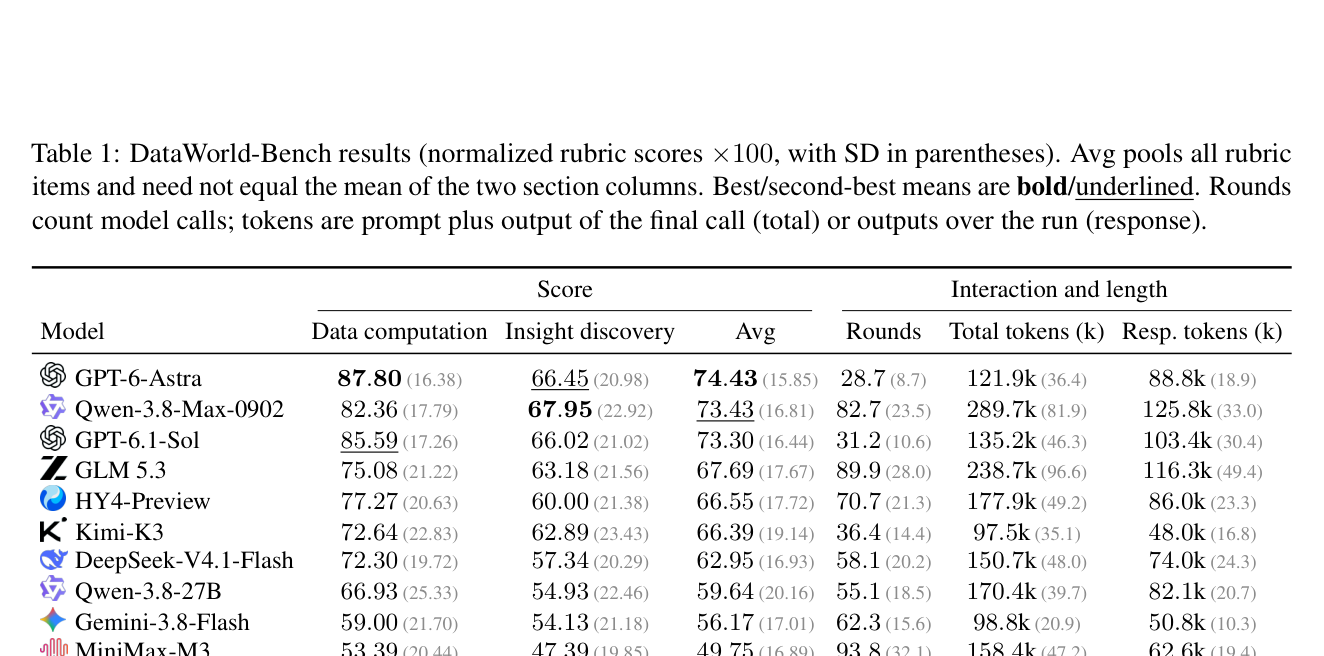
Table 1 — DataWorld-Bench 벤치마크에서 Frontier 모델 성능 및 computation-insight gap을 보여주는 핵심 정량적 결과 테이블
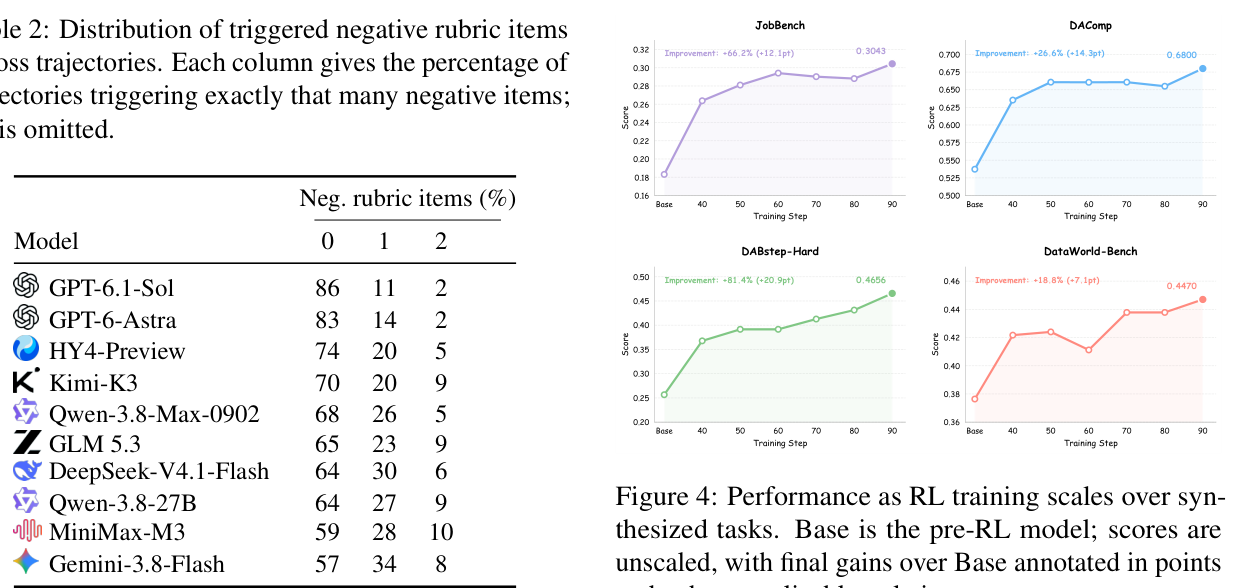
Figure 4 — 합성된 태스크를 활용한 RL 훈련의 유용성을 보여주며, 훈련 단계별 성능 향상을 나타내는 그래프
4. Conclusion & Impact (결론 및 시사점)
본 논문은 데이터 에이전트를 위한 확장 가능하고 검증 가능한 supervision을 제공하기 위해 메커니즘 중심의 Data World 프레임워크를 제안합니다. Data World는 canonical truth와 analyst-visible한 파일들을 분리하여, 에이전트가 오직 관측을 통해서만 findings를 recover하도록 요구하며, 이를 통해 알려진 메커니즘에 기반한 supervision을 제공합니다. 이 연구는 Computation-Insight Gap을 측정하는 DataWorld-Bench와 RL-zero training을 위한 world-disjoint 데이터셋을 제공합니다. 이는 실제 환경에서 학습 비용과 데이터 제약 없이 다양하고 복잡한 데이터 분석 시나리오를 효과적으로 시뮬레이션할 수 있는 기반을 마련하며, 데이터 분석을 넘어 다양한 직업군에서의 파일 기반 전문적 추론 능력 향상에도 기여할 수 있는 중요한 시사점을 가집니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Echoverse: Deep, Evolving Environments for Training Computer-Use Agents at Scale
- [논문리뷰] Agent World Model: Infinity Synthetic Environments for Agentic Reinforcement Learning
- [논문리뷰] DeepAnalyze: Agentic Large Language Models for Autonomous Data Science
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
Review 의 다른글
- 이전글 [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- 현재글 : [논문리뷰] Data World: Scaling Data Environments from Scratch
- 다음글 [논문리뷰] DeltaStreamer: Towards Human-Like Agentic Streaming Video Understanding
댓글