[논문리뷰] SoloQ: Calibration-Free Quantization for Diffusion Language Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Donghyun Lee, Arkapravo Ghosh, Varun Manjunath, Bumjoon Kyle Rhee, Hyunho Kook, Shiting Xiao, Youngeun Kim, Priyadarshini Panda
1. Key Terms & Definitions (핵심 용어 및 정의)
- dLLMs (Diffusion Large Language Models): 기존 autoregressive 모델의 왼쪽-오른쪽 디코딩 방식 대신, 반복적인 masked denoising을 통해 토큰을 생성하는 모델 구조입니다.
- K-RPBH (Kronecker-extended Randomized Permuted Block-Hadamard): 입력 데이터의 차원을 재구성하여 가우시안 분포와 유사한 형태로 변환하는 저비용의 구조적 회전(rotation) 기법입니다.
- SoloQ-C (Distribution-matched Codebooks): SoloQ가 제안하는 calibration-free 양자화 방식으로, 회전된 공간의 분포에 최적화된 코드북을 사용하여 성능을 유지합니다.
- SoloQ-N (Hardware-native NVFP4): 가중치와 활성화 값을 NVFP4 데이터 포맷으로 양자화하여 하드웨어 가속을 극대화하는 방식입니다.
- Commit-time KV-Cache Quantization: block-diffusion 모델에서 기존의 메모리 집약적인 KV-cache를 블록이 확정(commit)되는 시점에만 양자화하여 압축하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 dLLMs의 대규모 모델 사이즈와 추론 비용 문제를 해결하기 위해 calibration-free 기반의 효율적인 Post-Training Quantization(PTQ)을 제안한다. 기존 dLLM PTQ 방식들은 매 denoising step마다 변화하는 활성화 분포를 추적하기 위해 calibration 데이터에 의존하는데, 이는 특정 데이터셋에 대한 과적합을 초래하여 모델의 일반화 성능을 저해한다 [Figure 1]. 또한, block-diffusion 모델은 메모리 집약적인 KV-cache를 유지하므로 가중치뿐만 아니라 KV-cache를 포함한 포괄적인 양자화 전략이 필수적이다. 기존 연구들에서 지적된 calibration 의존성과 하드웨어 효율성 부족 문제를 해결하기 위해, 데이터 분포 변화에 강건한 데이터 독립적 접근 방식이 요구된다.
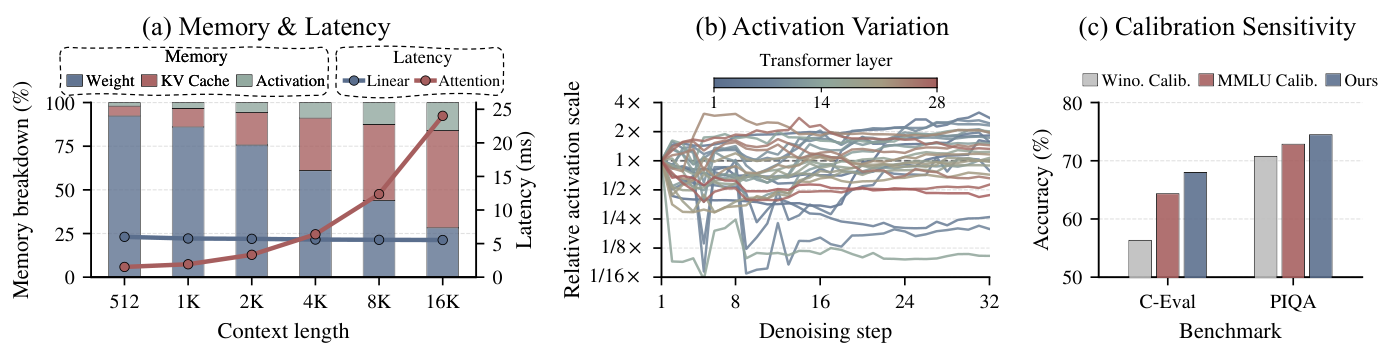
Figure 1 — dLLM 추론 비용과 PTQ 한계
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 데이터 의존성을 배제하기 위해 회전을 통해 활성화 값을 예측 가능한 가우시안 분포로 변환하는 K-RPBH 기법을 제안한다 [Figure 2]. K-RPBH는 글로벌 혼합(cross-block mixing)을 추가하여 기존 RPBH 방식의 잔여 블록 에너지 불균형 문제를 해결하고, 분포 매칭 성능을 비약적으로 높였다 [Figure 3]. 이를 기반으로 SoloQ-C와 SoloQ-N을 통해 W4A4 조건에서도 우수한 정확도를 유지하면서도, scale-only bias correction을 적용하여 별도의 오버헤드 없이 양자화로 인한 크기 왜곡을 보정한다. 실험 결과, SoloQ-N은 LLaDA 및 Nemotron-Labs-Diffusion 등의 다양한 모델에서 최고 수준의 정확도를 달성하였으며, 특히 W4A4KV4 설정에서 Fast-dLLM v2와 같은 모델의 성능을 안정적으로 보존하였다 [Table 1], [Table 2]. 정량적 지표 측면에서 SoloQ-N은 BF16 baseline 대비 최대 2.61x의 peak memory 절감과 2.24x의 End-to-End 추론 속도 향상을 입증하였다 [Figure 4].
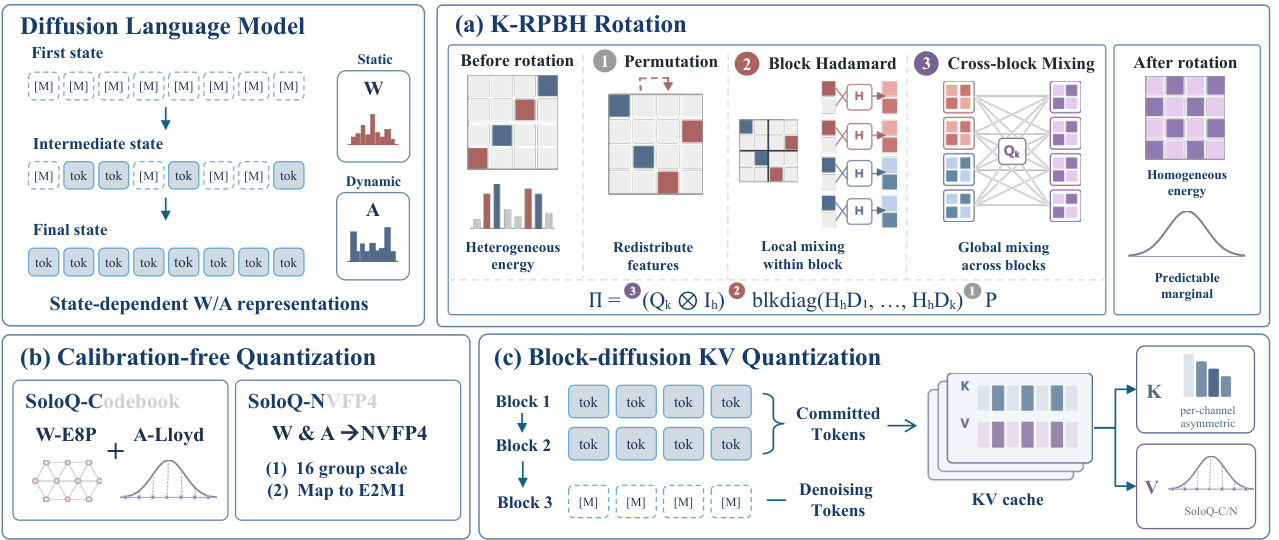
Figure 2 — SoloQ 전체 프레임워크
4. Conclusion & Impact (결론 및 시사점)
본 연구는 calibration 데이터 없이도 diffusion 언어 모델을 고효율로 양자화할 수 있는 SoloQ 프레임워크를 성공적으로 구축하였다. 제안된 K-RPBH rotation과 commit-time KV-cache 양자화 기법은 모델의 성능 저하를 최소화하면서도 하드웨어 가속을 효과적으로 이끌어냈다. 이 연구는 diffusion 기반 생성 모델의 실제 배포(deployment)를 위한 필수적인 기반 기술을 제공하며, 향후 대규모 언어 모델의 추론 효율성을 극대화하는 연구 분야에 중요한 토대가 될 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] 6Bit-Diffusion: Inference-Time Mixed-Precision Quantization for Video Diffusion Models
- [논문리뷰] STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
- [논문리뷰] Softmax Reparameterization for Output-Head Quantization
- [논문리뷰] Retention-Constrained Post-Training Quantization of Cellpose-SAM for Stem Cell Microscopy
- [논문리뷰] Why Gated DeltaNet Survives 4-Bit Quantization: NVFP4 W4A4 for the Recurrent Half of a Hybrid 27B LLM
Review 의 다른글
- 이전글 [논문리뷰] SoftwareGym: Scaling Computer-Use Agent Training with Diverse Synthesized Software Environments
- 현재글 : [논문리뷰] SoloQ: Calibration-Free Quantization for Diffusion Language Models
- 다음글 [논문리뷰] Stateless Language Agents: Scaling Long-Horizon Automated Research
댓글