[논문리뷰] Learning More by Training Less: Uncertainty-Guided Progressive Contraction for Efficient Reasoning Post-Training
링크: 논문 PDF로 바로 열기
저자: Suorong Yang, Jiaxin Wang, Jiaming Su, Chentao Yue, Furao Shen, Peng Ye, Soujanya Poria
1. Key Terms & Definitions (핵심 용어 및 정의)
- Progressive Contraction: LLM의 Reasoning Post-Training 효율성을 극대화하기 위해, 학습에 가장 가치 있는 Reasoning Trajectory에 Supervision과 Optimization을 점진적으로 집중시키는 프레임워크입니다.
- Uncertainty-Profiled Reasoning Supervision: Teacher Model이 생성한 Chain-of-Thought (CoT)를 단일 경로로 취급하는 대신, Intermediate Reasoning State 주변에 Monte Carlo Reasoning Trees (MCRTs)를 구축하여 Process-Level Uncertainty를 노출하고 학습에 더 유용한 Supervision을 구성하는 방법입니다.
- Monte Carlo Reasoning Trees (MCRTs): Teacher Model의 Intermediate State에서 여러 Continuation을 Sampling하여 Correct-Answer Reachability 및 Branch-Outcome Uncertainty를 추정함으로써, Reasoning Process의 Local Stability를 정량화하는 기법입니다.
- Learner-Aware Data Routing: Teacher-informed Pool 내에서 Student Model의 Current Learning State에 따라 Optimization을 동적으로 Routing하여, 학습 진행에 가장 필요한 Trajectory에 집중시키는 두 번째 Supervision Contraction 단계입니다.
- Chain-of-Thought (CoT): 복잡한 추론 작업을 수행하기 위해 Large Language Models가 문제를 해결하는 중간 단계를 순차적으로 생성하는 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Large Language Models (LLMs)는 복잡한 Reasoning 분야에서 상당한 발전을 이루었지만, Reasoning Post-Training 시 방대한 Corpus를 사용하면 성능 향상에 비례하지 않는 막대한 Training Cost가 발생합니다. 기존 연구들은 더 효과적인 Reasoning Supervision을 구축하거나, Correctness, Difficulty, Quality를 기반으로 고정된 Corpus를 필터링 또는 Routing하는 방향으로 진행되었으나, 극단적인 Optimization Efficiency를 달성하기에는 한계가 명확합니다. 본 논문은 Reasoning의 본질적인 비균일성, 즉 해결책이 소수의 Intermediate State("Reasoning Forks")에 달려있다는 점에 주목하며, 이러한 Fork에서 발생할 수 있는 Process-Level Uncertainty가 학습에 중요한 정보를 내포하고 있다고 봅니다. 심지어 Highly Confident하거나 Correct한 CoT 내에서도 상당한 Process-Level Uncertainty가 숨겨져 있을 수 있으며, 이는 Terminal Confidence나 Correctness가 불안정한 Intermediate Reasoning을 가릴 수 있음을 시사합니다. [Figure 1] 기존의 접근 방식들이 이러한 Process Uncertainty를 충분히 활용하지 못하여 효율적인 학습에 도달하지 못하는 문제를 해결하고자, 저자들은 학습 가치가 높은 Reasoning Trajectory에 Optimization을 집중하는 새로운 프레임워크의 필요성을 제기합니다.
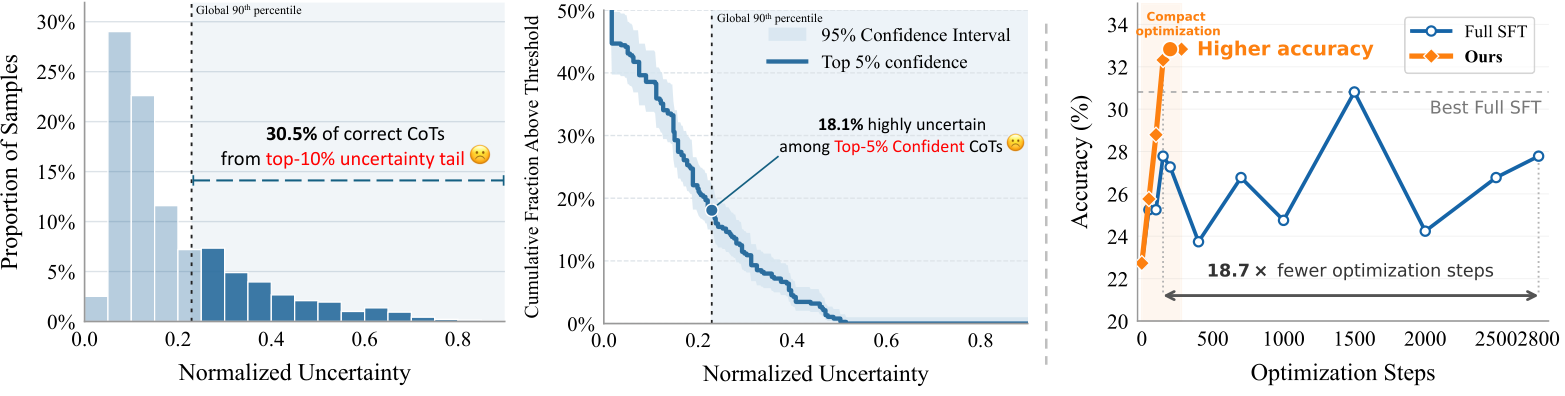
Figure 1 — CoT의 숨겨진 불안정성 및 제안 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Uncertainty-Guided Progressive Contraction 프레임워크를 제안하며, 이는 Teacher Model (T)에서 Student Model (Sθ)로의 Reasoning Distillation 효율성을 높이기 위해 Supervision을 점진적으로 축소하는 두 단계로 구성됩니다. 첫 번째 단계인 Teacher-side Uncertainty Contraction에서는 각 CoT를 Backbone Trajectory로 간주하고, Intermediate State 주변에 Monte Carlo Reasoning Trees (MCRTs)를 구축하여 Process-Level Uncertainty를 특성화합니다. 이를 통해 각 Trajectory에 Teacher-side Uncertainty Score (q_i^T)가 할당되며, 가장 높은 Process Uncertainty를 가진 Trajectory들이 Teacher-informed Candidate Pool (𝒫ρ)로 선택됩니다. 이 과정은 오직 Observable Teacher Behavior에만 의존하며, Student-agnostic하여 여러 Learner에 재사용될 수 있다는 장점이 있습니다. 두 번째 단계인 Learner-aware Optimization Contraction에서는 𝒫ρ 내에서 Student의 Evolving Training State에 따라 Optimization을 동적으로 Routing합니다. 구체적으로, 단일 Probing Epoch을 통해 각 Trajectory에 대한 Length-Normalized Response Loss (ℓi)를 계산하고, 현재 Student에게 덜 학습된 Trajectory (즉, ℓi가 큰 Trajectory)를 Active Training Set (ℋM)으로 선택하여 이후 SFT Optimization을 집중합니다. 이 두 단계를 통해 Training Data Exposure와 Optimization Budget을 대폭 줄일 수 있습니다.
실험 결과, 이 방법론은 다양한 Reasoning Benchmark와 LLM Families에서 뛰어난 효율성을 보였습니다. 특히, Qwen3.5-4B 및 Qwen3.5-9B Student Model에 대해 Full-data SFT 대비 0.22% ~ 1.91%의 Optimization Budget만을 사용하여, Training Exposure를 450배 이상 줄이면서도 Reasoning Performance를 유지하거나 향상시켰습니다. [Table 1] 예를 들어, Qwen3.5-4B Student의 경우 ρ=1% 설정에서 Full SFT 대비 800배 이상의 Wall-clock Acceleration을 달성하며 대부분의 벤치마크에서 Full-set SFT와 동등하거나 더 우수한 성능을 보였습니다. Cross-Family Generalization 실험에서도 Qwen3-8B Teacher를 사용하여 Gemma-4-E4B-IT, LLaMA-3.2-3B-Instruct, Mistral-7B-Instruct Student 모두에서 전체 Reasoning Performance를 유지 또는 향상시키면서 Full-SFT Optimization Budget의 약 0.45%만을 사용했습니다. [Figure 2] Weak-to-Strong Reasoning Transfer 능력도 입증되어, Qwen3-1.7B와 같은 Weak Teacher가 더 강력한 Qwen3.5-4B 및 Qwen3-14B Student의 성능을 최대 14.4%까지 향상시켰습니다. [Table 2] 또한, Black-Box Distillation 실험에서는 DeepSeek-V4-Pro 및 Kimi-K2.6와 같은 Closed-Source Teacher에 대해서도 Vanilla Distillation 대비 최대 13.4%의 성능 향상을 보였습니다. [Figure 3] 최종적으로, 9B Student Model이 30B에서 671B 파라미터를 가진 훨씬 큰 Reasoning Model들과 대등하거나 더 우수한 성능을 달성하여, 단순히 효율성뿐만 아니라 Reasoning Capability 자체를 향상시킬 수 있음을 보여주었습니다. [Table 3]
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Uncertainty-Guided Progressive Contraction 프레임워크를 통해 Reasoning Supervision의 학습 가치를 식별하고 집중시켜, Reasoning Post-Training의 효율성을 저하시키지 않으면서도 성능을 대폭 향상시키는 방법을 제안합니다. 이 방법론은 Training Budget을 0.22%까지 줄이면서도 Reasoning Performance를 유지하거나 개선하며, 다양한 벤치마크와 LLM 아키텍처, Teacher Regime에 걸쳐 강력한 Generalization 능력을 보여주었습니다. 특히, Teacher-side Uncertainty Profiling이 행동 기반으로 이루어져 Black-Box Teacher에도 적용 가능하며, Weak-to-Strong Transfer까지 지원하는 실용적인 이점을 가집니다. 이 연구는 효과적인 Reasoning Supervision이 단순히 데이터의 규모뿐만 아니라, 학습 가치를 어떻게 식별하고 Training 과정에서 어떻게 할당하는지에 달려있음을 강조합니다. 궁극적으로, 이 프레임워크는 제한된 컴퓨팅 자원 하에서 강력한 Reasoning Model을 개발하고, 미래 연구가 Reasoning Data의 Scale을 늘리는 것에서 벗어나 더 효율적이고 접근 가능한 Post-Training 방식으로 전환하는 데 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Is Next-Chunk Reasoning RL Really Better than SFT? Revisiting Training Strategies under no-CoT Data
- [논문리뷰] Universal Textual Teaching for LLMs
- [논문리뷰] Foundations of Large Language Models
- [논문리뷰] The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models
- [논문리뷰] On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
Review 의 다른글
- 이전글 [논문리뷰] Initialization Improves LLM-Driven Discovery
- 현재글 : [논문리뷰] Learning More by Training Less: Uncertainty-Guided Progressive Contraction for Efficient Reasoning Post-Training
- 다음글 [논문리뷰] Multi-Stream Attention Residuals
댓글