[논문리뷰] Multics: Generative Multi-Player World Model with Hierarchical Communication
링크: 논문 PDF로 바로 열기
저자: Kaiyi Huang, Wangbo Yu, Yukun Huang, Jiwen Yu, Kunhao Liu, Donglin Yang, Wenbo Hu, Ying Shan, Xihui Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Multi-player World Model: 여러 플레이어의 관점에서 공유 환경을 시뮬레이션하고, 각 플레이어의 Action, Camera Trajectory, Text Prompt에 Conditioning하여 Video를 생성하는 모델입니다.
- Hierarchical Communication: Player, Group, Global Level에 걸쳐 정보 교환을 구조화하는 통신 메커니즘으로, Self-Attention 내 Group Token과 Global Token을 활용합니다.
- Group Tokens: Hierarchical Communication 구조 내의 중간 Group-level Representation으로, 지역적으로 관련된 플레이어 정보를 Aggregation하는 역할을 합니다.
- Dynamic Grouping: 최근 Camera Trajectory를 기반으로 관련 플레이어들을 Adaptive하게 그룹화하여 불필요한 통신을 제한하는 Budget-constrained 전략입니다.
- Cross-player Consistency: 여러 플레이어의 Overlapping View 간에 생성된 Observation이 일관성을 유지하고, Player-specific Action 및 Camera Control을 충실히 따르는 속성입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Robust한 Multi-player Video Generation을 달성하면서 플레이어 수가 증가함에 따라 효율적으로 Scalability를 확보하는 핵심 문제를 다룹니다. 기존 연구들은 다음 두 가지 주요 한계에 직면해 있습니다. 첫째, Fully-connected Communication 방식(예: Solaris)은 플레이어 수가 증가할수록 Quadratic한 Attention Cost를 발생시켜 확장성에 어려움이 있습니다. 둘째, Centralized Communication 방식(예: γ-World)은 공유된 Global Representation에 의존함으로써, 관련 없는 이벤트 간의 간섭(Interference)으로 인해 Cross-player Consistency와 Player-specific Controllability가 저하될 수 있습니다. 이러한 문제들은 Structured local 및 global communication의 필요성을 강조하며, 제한된 통신 Budget 내에서 효율적으로 정보를 교환하는 새로운 접근 방식의 개발을 요구합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Multi-player Video Generation을 위한 새로운 프레임워크인 Multics를 제안하며, 이는 Player, Group, Global Level에 걸쳐 정보 교환을 구조화하는 Hierarchical Communication을 핵심으로 합니다 [Figure 2, cite: 1]. Multics는 Group-level Representation인 Group Tokens를 Self-Attention에 도입하여 지역적으로 관련된 플레이어 정보를 Aggregation하고, 이를 Global Tokens와 연결하여 Cross-group Communication을 가능하게 합니다 [Figure 2, cite: 1]. 이러한 Topology는 관련 없는 Local Event 간의 직접적인 정보 혼합을 제한합니다. Group Token Parameter는 Group Slot 간에 공유되어, 동일한 Communication Module이 새로운 Group-specific Parameter 없이 다양한 수의 플레이어를 수용할 수 있도록 합니다. 또한, 최근 Camera Trajectory를 기반으로 하는 Budget-constrained Dynamic Grouping 전략을 제안하여, 관련 플레이어들을 Adaptive하게 그룹화하고 불필요한 통신을 최소화합니다.
실험 결과, Multics는 4-player 및 6-player 환경에서 State-of-the-art 성능을 달성했습니다. 4-player 설정에서 Multics는 GeoKPM 54.17%, FID 26.39, FVD 162.3을 기록하여 Solaris (GeoKPM 48.51%, FID 28.41, FVD 171.9) 및 γ-World (GeoKPM 49.42%, FID 29.36, FVD 200.5)를 능가했습니다 [Table 1, cite: 1]. 또한, Multics는 4-player 학습 모델을 Retraining 없이 6-, 8-, 10-player Inference에 적용했을 때도 강력한 Generalization Ability를 보였습니다 [Figure 4, Table 1, cite: 1]. 특히 10-player Inference에서 Multics는 GeoKPM 51.54%, FVD 121.9로 Solaris (GeoKPM 47.82%, FVD 139.0) 및 γ-World (GeoKPM 49.12%, FVD 154.9)보다 우수한 성능을 나타냈습니다 [Table 1, cite: 1]. Computational Efficiency 측면에서도, Multics는 10명의 플레이어 환경에서 Fully-connected Communication 대비 9.6 TFLOPs vs. 69.1 TFLOPs로 Self-Attention 연산량을 크게 줄였습니다. Ablation Study는 Hierarchical Communication과 Dynamic Grouping의 효과를 검증하며, 특히 Dynamic Grouping이 Fixed Grouping이나 Random Grouping 대비 Consistency와 Controllability를 개선함을 보여주었습니다. Qualitative Result는 Multics가 Overlapping View 간의 Cross-player Consistency, Player-specific Controllability, Interference Robustness에서 우수함을 시각적으로 입증합니다 [Figure 3, cite: 1].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Player, Group, Global Level의 Hierarchical Communication을 통해 Multi-player Video Generation의 Robustness 및 Scalability 문제를 성공적으로 해결하는 Multics 프레임워크를 제안합니다. Group Token, Shared Group-token Parameter, Budget-constrained Dynamic Grouping은 기존 Fully-connected 및 Centralized Communication 방식의 한계점을 극복하며 효율적이고 효과적인 정보 교환을 가능하게 합니다. 이 연구는 State-of-the-art 성능, Retraining 없는 확장된 Player Count에 대한 Generalization 능력, 그리고 개선된 Computational Efficiency를 통해 Multi-player World Modeling 분야에 중요한 기여를 합니다. Multics는 Interactive Simulation, Game Entertainment, Multi-agent System과 같이 복잡하고 조정된 상호작용이 필요한 분야에서 새로운 응용 가능성을 제시하는 견고한 기반을 제공합니다.
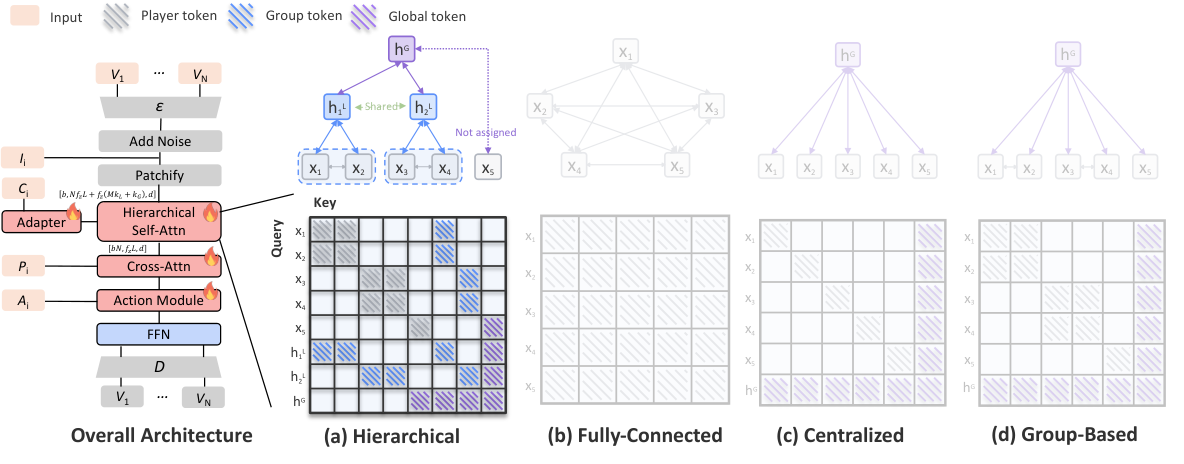
Figure 2 — 제안 모델의 개요 및 통신 비교
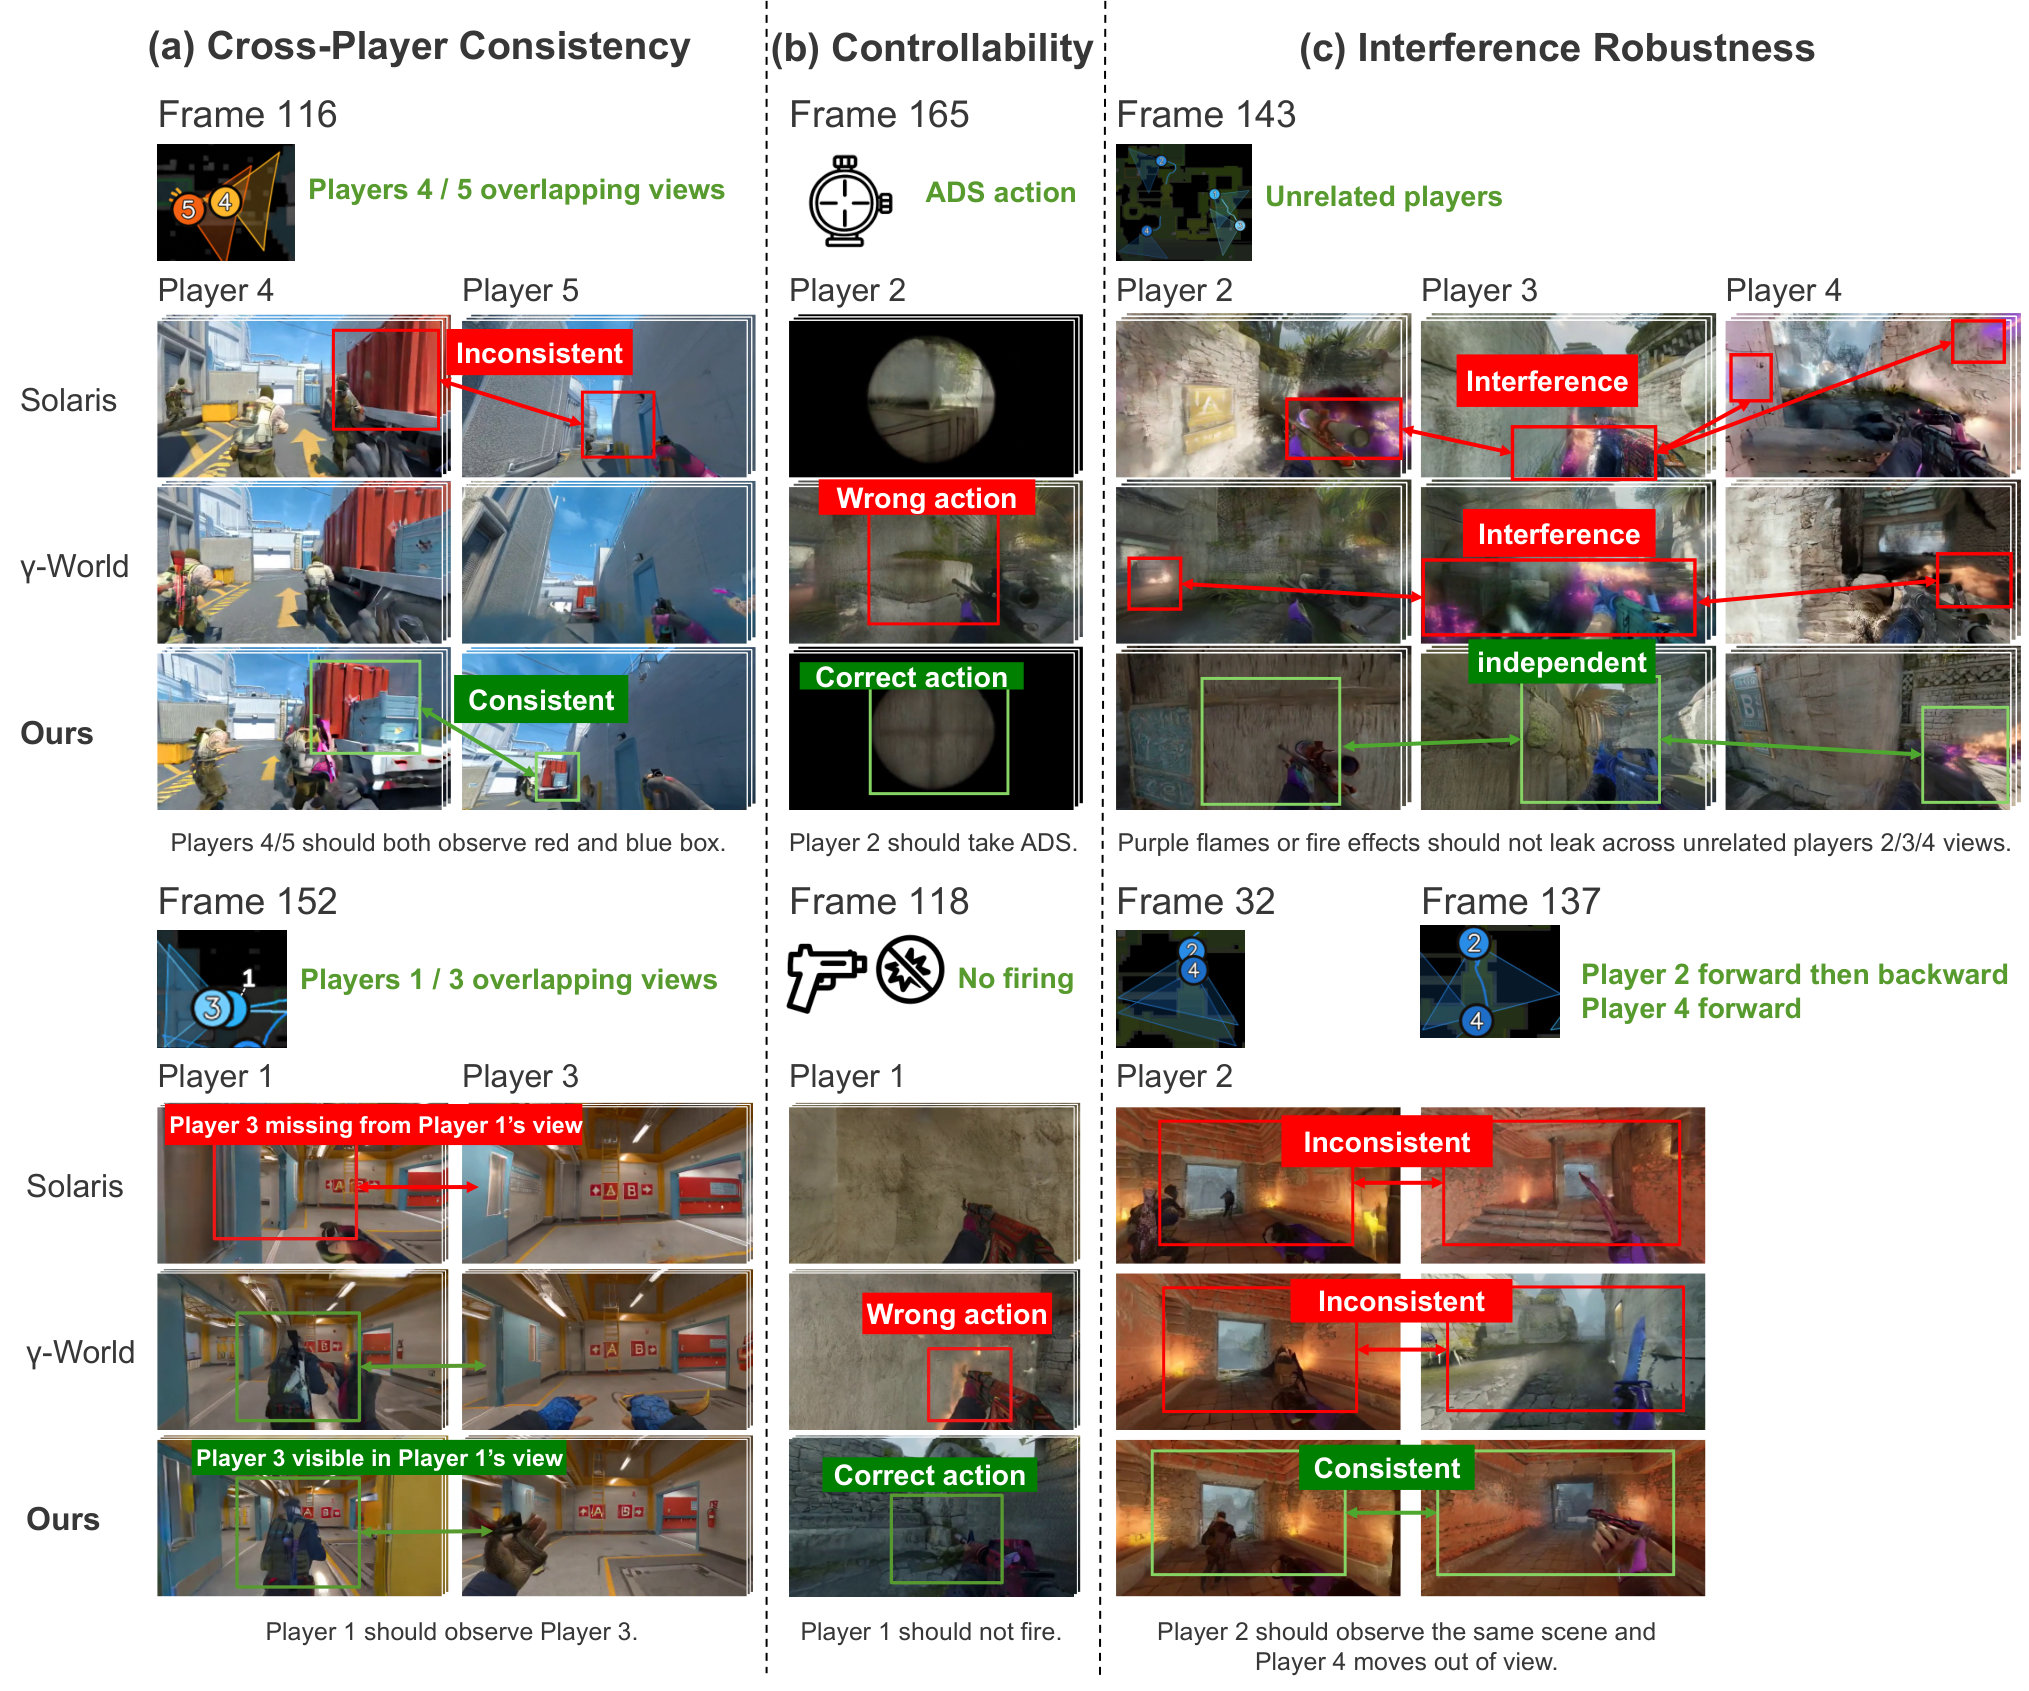
Figure 3 — 4/6인 플레이어 정성적 비교
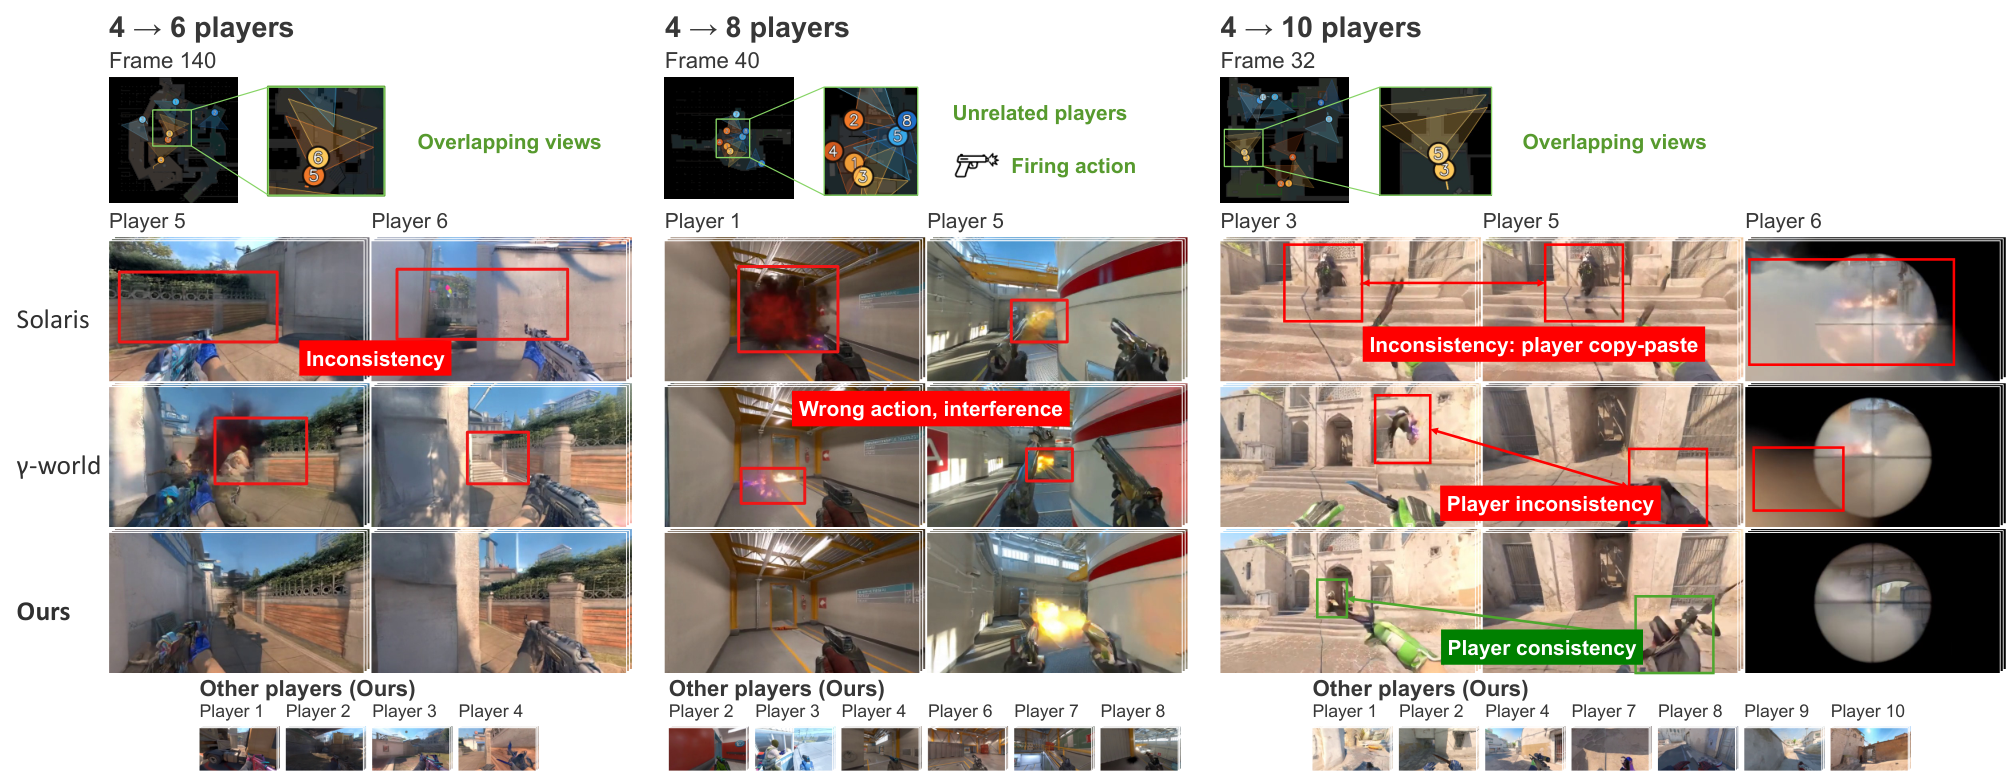
Figure 4 — 다수 플레이어 일반화 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
- [논문리뷰] VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
- [논문리뷰] SoftwareGym: Scaling Computer-Use Agent Training with Diverse Synthesized Software Environments
- [논문리뷰] CARD: Cluster-level Adaptation with Reward-guided Decoding for Personalized Text Generation
- [논문리뷰] Rufus-Air: An Open LLM Post-Training Recipe
Review 의 다른글
- 이전글 [논문리뷰] Learning How to Remember: Memory Modality Selection for GUI Agents
- 현재글 : [논문리뷰] Multics: Generative Multi-Player World Model with Hierarchical Communication
- 다음글 [논문리뷰] Open-o3-Video-v2: Seek, Ground, and Reason with Verifiable Spatio-Temporal Evidence
댓글