[논문리뷰] World-in-Context: Interactive Video World Modeling with In-Context Conditioning
링크: 논문 PDF로 바로 열기
저자: Harold Haodong Chen, Rui Peng, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Interactive Video World Models: 사용자 제어 입력(예: 행동, 카메라 움직임)에 반응하여 동적인 시각 환경을 생성하는 모델을 지칭합니다.
- In-Context Conditioning (ICC): View, action, camera 등 다양한 상호작용 제어 신호를 명시적인 토큰으로 통합하고, 이를 시각적 Latent와 함께 공유된 Self-Attention Space에 직접 Prepend하는 패러다임입니다.
- View Modes (Free, Fpp, Tpp): 상호작용 환경에서 사용되는 세 가지 고유한 시점(Viewing Perspective)으로, Free(자유로운 카메라 로밍), First-person perspective (Fpp), Third-person perspective (Tpp)를 의미합니다.
- Interaction-Transport RoPE (IT-RoPE): 실행 시퀀스를 따라 누적된 Pairwise Control Transition을 Temporal Attention에 직접 통합하여 Temporal Continuity를 보존하는 Positional Encoding 기법입니다.
- WBench: 상호작용 비디오 세계 모델의 평가를 위해 널리 채택된 종합적인 Multi-Turn Benchmark입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
현재 Interactive Video World Model은 Viewing Perspective, Character Action 및 Camera Motion에 대한 조율된 제어에 어려움을 겪고 있습니다. 기존 방법론들은 View Mode를 텍스트 캡션에 암시적으로 남겨두거나, Character Action과 Camera Motion을 혼동하는 경향이 있습니다. 또한, 제어 신호가 단편적인 아키텍처 경로(예: 개별 AdaLN 모듈)를 통해 주입되어, 상호의존성을 간접적으로만 포착하고 풍부한 상호작용에 대한 확장성을 저해하는 한계를 보입니다 [Figure 2]. 따라서 다차원적인 상호작용과 그 Cross-Dependency를 효과적으로 처리하기 위한 통합적이고 확장 가능한 새로운 접근 방식이 필요합니다.
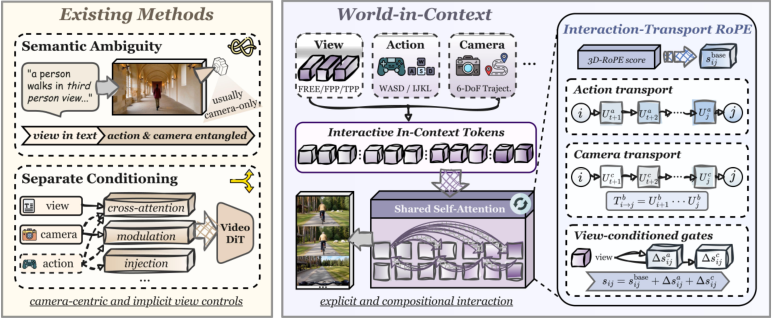
Figure 2 — 제안 모델의 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 In-Context Conditioning (ICC) 패러다임을 기반으로 하는 World-in-Context 프레임워크를 제안하며, View, Action, Camera Control 등 다양한 상호작용 신호를 명시적인 토큰으로 통합합니다. 이러한 토큰들은 시각적 Latent와 함께 공유된 Self-Attention Space에 직접 Prepend되어 Cross-Condition Dependency를 Native하게 포착할 수 있습니다 [Figure 2]. 구체적으로, World-in-Context는 Free, Fpp, Tpp와 같은 명시적인 View Token을 도입하여 Viewing Regime 간의 Motion Semantics를 구분하고, In-Video View Switching을 자연스럽게 가능하게 합니다. 또한, Discrete Action과 Continuous Camera Trajectory를 decoupled condition으로 Joint하게 모델링하여, Action이 Local Responsiveness를, Camera가 Global Trajectory Stability를 담당하는 상호보완적인 역할을 밝혀냈습니다. Temporal Continuity를 보존하기 위해, World-in-Context는 누적된 Control Transition을 Temporal Attention에 통합하는 Interaction-Transport RoPE (IT-RoPE)를 추가로 도입하여 동일한 End-point를 가지만 실행 시퀀스가 다른 Trajectory를 구별하도록 합니다.
실험 결과, World-in-Context-5B는 WBench에서 81.5%의 Navigation Performance를 달성하여 22B EchoWM의 81.6%와 유사한 성능을 보였습니다 [Table 1]. 특히, Fpp↔Tpp Perspective-Switching에서 93.8%의 성공률을 기록하여 기존 5B Baseline (18.8%)을 크게 능가했습니다 [Figure 3, Table 1]. 명시적인 View Modeling은 Fpp (뚜렷한 주기적 진동)와 Free (더 부드러운 궤적) Motion Dynamics를 명확히 구분하여, 텍스트 기반 Condition과 비교했을 때 View Switching 성공률을 크게 향상시켰습니다 (초기 모델 기준 37.5% vs. 6.25%) [Figure 3, Figure 4]. Joint Action-Camera Training은 Local Responsiveness와 Global Stability를 조화롭게 결합하여 90.6%의 Rotation Accuracy와 90.8%의 Geometric Consistency를 달성했습니다 [Figure 5]. IT-RoPE는 Navigation 성능을 80.5%에서 81.2%로, Interaction 점수를 86.2%에서 86.8%로 향상시켰습니다. 또한, ICC는 Data Efficiency 측면에서도 우수하여, 50K+250 클립만으로 75.0%의 Switching Rate를 달성, 두 배의 데이터를 사용한 Additive Injection보다 뛰어난 성능을 보였습니다.
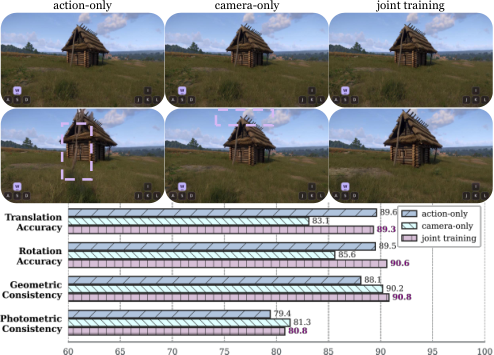
Figure 5 — Action-Camera 제어 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구에서 제시된 World-in-Context는 In-Context Conditioning (ICC)을 통해 다차원적인 상호작용 제어 신호를 효과적으로 통합하고, IT-RoPE로 Temporal Coherence를 강화하는 비디오 세계 모델링 프레임워크입니다. 이 연구는 명시적인 View Mode Modeling이 상충하는 Motion Dynamics를 분리하고 Emergent View Switching을 가능하게 하며, Action 및 Camera 신호가 Local Responsiveness와 Global Stability에서 상호보완적인 역할을 한다는 점을 밝혀냈습니다. World-in-Context는 WBench 벤치마크에서 경쟁력 있는 Navigation 성능을 달성하고, 특히 Perspective Switching에서 뛰어난 능력을 입증하여 더 크거나 유사한 Baseline 모델들을 능가하는 동시에 Data Efficiency 이점을 보였습니다. 이는 다중 조건 상호작용을 확장 가능한 Context Modeling 문제로 재구성하며, 학술 연구 및 산업 응용 분야에서 미래 Interactive World Simulation을 위한 통합적이고 확장 가능한 Interface를 제공하는 데 중요한 시사점을 가집니다.
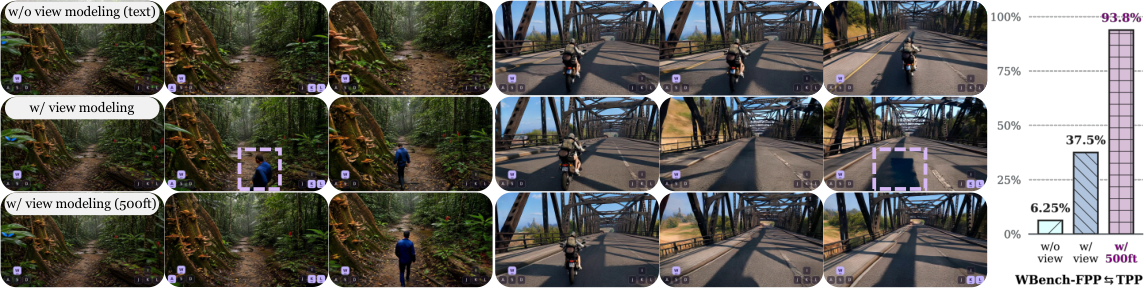
Figure 3 — Emergent View Switching 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
- [논문리뷰] AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video
- [논문리뷰] MetaView: Monocular Novel View Synthesis with Scale-Aware Implicit Geometry Priors
- [논문리뷰] minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models
- [논문리뷰] DynaVid: Learning to Generate Highly Dynamic Videos using Synthetic Motion Data
Review 의 다른글
- 이전글 [논문리뷰] Work Agents: Systems, Capabilities, and Optimization
- 현재글 : [논문리뷰] World-in-Context: Interactive Video World Modeling with In-Context Conditioning
- 다음글 [논문리뷰] WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
댓글