[논문리뷰] Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
링크: 논문 PDF로 바로 열기
저자: Wenbo Hu, Shraman Pramanick, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Long-Horizon Agent: 자율적으로 오랜 시간(수 시간~수 일)에 걸쳐 경제적으로 가치 있는 복잡한 태스크를 수행할 수 있는 AI 에이전트.
- TEV-GYM:
latent-world-first synthesis접근 방식으로 구축된, 검증 가능하고 dense한 progressive reward를 제공하는 최초의 long-horizon 에이전트 학습 데이터셋. - Latent-World-First Synthesis: 태스크 도메인, 워크플로우, 각 단계별 예상 상태에 대한 완전하고 정확한 hidden specification("latent world")을 먼저 구성한 후, 이를 에이전트가 직면하는 환경으로 점진적으로 렌더링하여 태스크를 생성하는 방법론.
- Progress-Potential Reward Shaping (PPRS):
latent world에서 파생된 progress metric을 dense한 per-step reward로 변환하여 학습 효율성을 높이고 기존에는 해결하기 어려웠던 태스크를 학습 가능하게 하는 reward shaping 기법. - ALE-CM: Agents' Last Exam 벤치마크의 Computing and Math sciences 도메인으로, 본 연구의 주요 학습 및 평가 대상 중 하나.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Long-horizon agent는 자동화된 발견(automated discovery) 및 recursive self-improvement (RSI)에 필수적이지만, 현재 open-source LLM agent는 long-horizon 태스크에서 어려움을 겪고 있습니다. 주요 문제점은 long-horizon 태스크를 위한 충분한 학습 데이터의 부족과 sparse reward 문제입니다. 기존 agentic training corpora는 규모는 크지만 대부분 short- 또는 mid-horizon 태스크에 초점을 맞추고 있으며, 단위 테스트 기반의 terminal pass/fail signal이나 테스트 통과 비율과 같은 sparse reward를 제공합니다. 반면, 진정한 long-horizon 태스크는 인간이 직접 작성한 벤치마크(수십~수백 개의 인스턴스)로만 존재하며, 보상 또한 sparse하게 태스크 완료 시점에만 주어집니다. [Table 1]은 TEV-GYM이 기존 corpora 대비 훨씬 긴 Agent time과 낮은 P@1을 보이는 것으로 long-horizon 태스크의 난이도와 sparse reward의 한계를 보여줍니다. 이러한 sparse reward는 특히 long-tail samples에서 학습을 어렵게 하고, Group-Relative Policy Optimization (GRPO)과 같은 RL 기법에서 모든 롤아웃이 실패할 경우 gradient에 기여하지 못하여 학습이 제대로 이루어지지 않는 문제를 야기합니다.
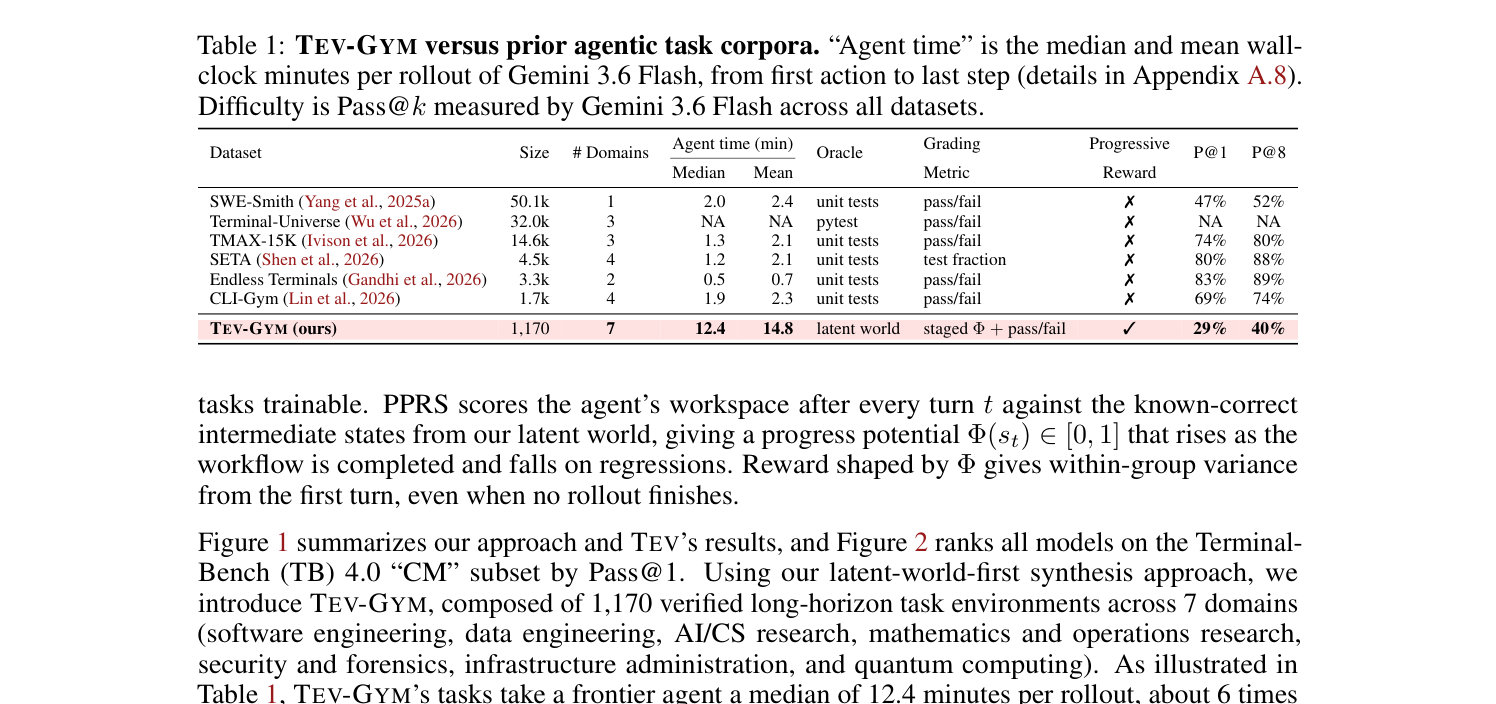
Table 1 — TEV-GYM 데이터셋이 기존 agentic task corpora와 비교하여 규모, 도메인 수, Agent time, Progressive Reward 지원 여부, 난이도(Pass@k) 등에서 어떤 특징을 가지는지 명확히 보여주는 비교 테이블
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 long-horizon agent 학습을 위한 latent-world-first synthesis 방법론과 Progress-Potential Reward Shaping (PPRS)이라는 dense reward 기법을 제안합니다. latent-world-first synthesis는 태스크의 hidden ground truth를 명확하게 정의하는 latent world를 먼저 구축하고, 이를 통해 태스크 도메인, 워크플로우, 각 단계별 예상 상태를 완전하고 정확하게 지정한 다음, controllable corruption을 적용하여 에이전트가 직면하는 환경을 점진적으로 렌더링합니다. [Figure 1]의 우측 패널은 이 data synthesis 접근 방식을 시각화합니다. 이 과정에서 latent world는 모든 올바른 중간 상태를 측정할 수 있는 progress metric을 제공하며, 이 metric은 PPRS를 통해 dense한 per-step reward Φ(s_t)로 변환됩니다. PPRS는 GRPO에서 sparse reward로 인한 학습 문제를 해결하며, 롤아웃이 완료되지 않아도 모든 turn에서 progress potential에 따른 reward를 제공하여 within-group variance를 확보합니다.
실험 결과, TEV-GYM 데이터셋으로 PPRS를 사용하여 학습된 TEV-27B 모델은 ALE-CM 벤치마크에서 Qwen3.8-27B 대비 Pass@5에서 65% 향상된 0.28을 달성하며 GPT-6 Astra 및 Claude Opus 5와 동등한 성능을 보였습니다. [Figure 1] 좌측 패널은 TEV-27B가 Qwen base 모델 대비 ALE-CM에서 Pass@5가 +65% 향상되었음을 보여줍니다. 또한, TEV-27B는 ALE-CM 관련 데이터로만 학습되었음에도 불구하고 Terminal-Bench (TB) 3.0-CM 및 4.0-CM 서브셋으로 zero-shot generalization하여 Pass@1에서 56% 및 150%의 상당한 성능 향상을 보였으며, GLM 5.2 및 Gemini 3.7 Flash를 능가했습니다. mid-horizon TB 2.1에서는 TEV-27B가 Pass@1 0.794를 달성하여 Claude Opus 4.8 수준의 성능을 보였습니다. [Figure 2]는 TB 4.0-CM에서 GLM-5.3-Flash에 PPRS를 적용하여 학습된 TEV-320B가 GLM-5.3-Flash base 대비 Pass@1에서 +28% 향상되어 다른 모델들을 상회함을 보여줍니다.
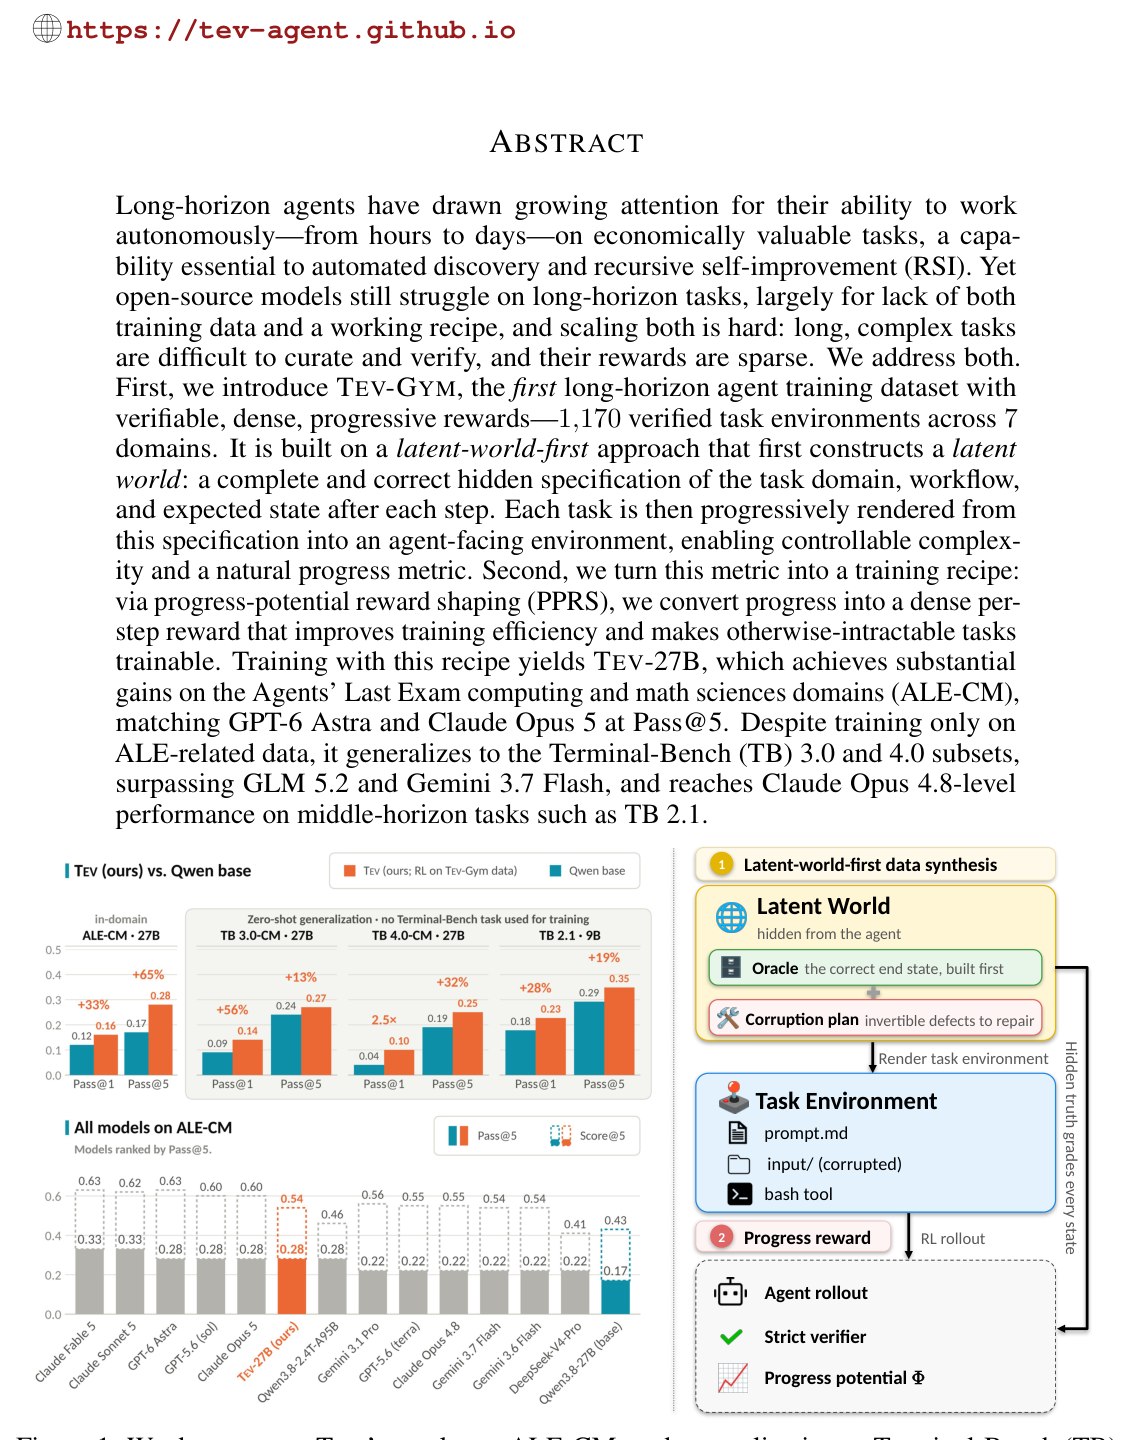
Figure 1 — 제안하는 방법론(Latent-World-First Data Synthesis)과 TEV-27B의 핵심 성능 결과(ALE-CM, TB generalization)를 한눈에 보여주는 전체 요약 그림
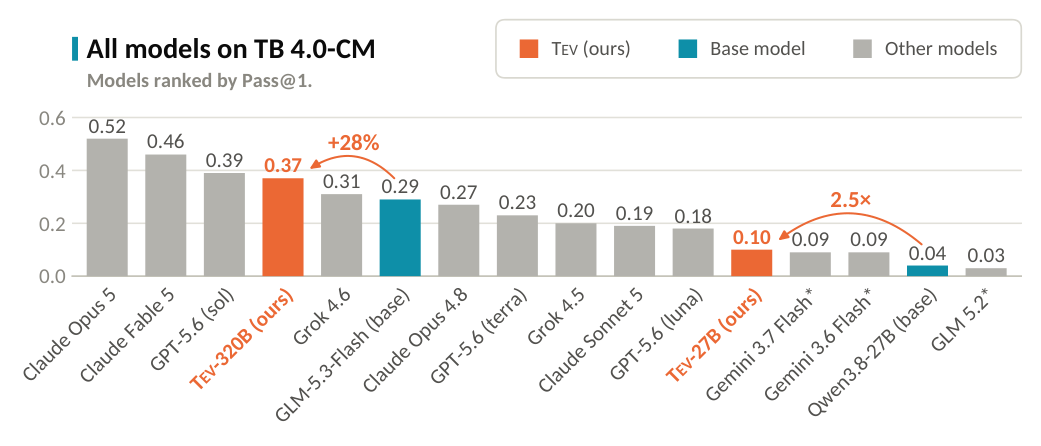
Figure 2 — Terminal-Bench 4.0 "CM" 서브셋에서 TEV 모델(TEV-320B, TEV-27B)이 다른 최신 모델들에 비해 Pass@1 성능에서 우수함을 보여주는 핵심 비교 그래프
4. Conclusion & Impact (결론 및 시사점)
본 논문은 long-horizon agent 학습의 핵심 과제인 학습 데이터 부족과 sparse reward 문제를 해결하기 위해 latent-world-first synthesis 접근 방식과 Progress-Potential Reward Shaping (PPRS) 기법을 성공적으로 도입했습니다. TEV-GYM이라는 대규모의 검증 가능한 long-horizon 학습 데이터셋을 구축하고, 이를 활용한 TEV-27B 모델이 ALE-CM에서 최신 frontier API models과 동등한 성능을 달성하며 다른 Terminal-Bench 태스크에서도 뛰어난 zero-shot generalization 능력을 입증했습니다. 이 연구는 agentic RL 커뮤니티에 검증 가능하고 dense한 progressive rewards를 제공하는 long-horizon 환경을 확장할 수 있는 실용적인 방법론과 데이터셋을 제공합니다. 이는 automated discovery 및 recursive self-improvement (RSI)와 같은 long-horizon AI의 궁극적인 목표에 한 걸음 더 나아가게 하며, human step labels이나 language-model judges 없이도 reproducible RL을 위한 전문적인 워크플로우를 가능하게 하는 중요한 시사점을 가집니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ScaleEnv: Scaling Environment Synthesis from Scratch for Generalist Interactive Tool-Use Agent Training
- [논문리뷰] Spark: Strategic Policy-Aware Exploration via Dynamic Branching for Long-Horizon Agentic Learning
- [논문리뷰] IterResearch: Rethinking Long-Horizon Agents via Markovian State Reconstruction
- [논문리뷰] Search Self-play: Pushing the Frontier of Agent Capability without Supervision
- [논문리뷰] EdgeWise: Bringing Long-Horizon Agents to the Edge via Selective Cloud Delegation
Review 의 다른글
- 이전글 [논문리뷰] TPPO: Tracking-Value PPO For Language Model Reasoning
- 현재글 : [논문리뷰] Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
- 다음글 [논문리뷰] UltraBERT: Beyond the Limit of BERT Pre-Training
댓글