[논문리뷰] APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
링크: 논문 PDF로 바로 열기
APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
저자: Sirui Zhang, Fangyun Wei, Dong Chen, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- APT (Agentic Post-Training): Text-to-Image (T2I) 모델의 post-training을 위한 fully automated framework로, 모델의 evolving capability profile에 따라 adaptive하게 post-train하는 시스템입니다.
- Recursive Self-Improvement (RSI): 업데이트된 모델의 evaluation 결과가 다음 학습 라운드의 training tasks를 결정하는 데 사용되는 개념으로, APT의 핵심적인 feedback loop 메커니즘을 형성합니다.
- Evaluation Set Generation Agent: high-level evaluation scope를 prompt–evaluation rubric pair로 구성된 structured evaluation suite로 변환하는 역할을 하는 에이전트입니다.
- Diagnosis Agent: 현재 모델을 instance 및 category level에서 평가하고, 체계적인 강점과 failure modes를 요약하는 에이전트입니다.
- RL Data Generation Agent: Diagnosis Agent의 진단 결과를 바탕으로, underperforming capabilities에 우선순위를 두어 adaptive한 prompt distribution으로 Reinforcement Learning (RL) training data를 생성하는 에이전트입니다.
- Prompt–Evaluation Rubric Pair: 이미지 생성 프롬프트와 해당 프롬프트에 대한 평가 기준(rubrics)이 짝을 이룬 형태로, 모델 진단 및 reward 계산에 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 Text-to-Image (T2I) 모델의 post-training pipeline이 수동으로 구성된 training data와 고정된 training distribution에 의존하여 확장성과 효율성이 떨어진다는 핵심 문제를 해결하고자 합니다. 기존 workflow는 모델의 약점을 수동으로 파악하고, 그에 맞는 training data를 수집하거나 합성하며, 경험적 관찰을 기반으로 data distribution을 반복적으로 조정하는 방식입니다. 이러한 수동적인 접근 방식은 모델, 벤치마크, 사용자 요구사항이 다양해짐에 따라 labor-intensive하며 scale하기 어렵다는 한계가 있습니다. 더욱 근본적으로, 저자들은 post-training이 model-adaptive해야 한다고 주장합니다. 즉, 각 base model은 고유한 capability 및 failure distribution을 가지므로, 한 모델에 효과적인 post-training dataset이 다른 모델에는 최적이 아닐 수 있습니다. 따라서 현재 모델이 어떤 부분에서 underperform하는지 식별하고, 이에 따라 training examples를 샘플링하며, 모델이 개선됨에 따라 sampling distribution을 지속적으로 adaptive하게 조정하는 새로운 접근 방식이 필요합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 APT (Agentic Post-Training)를 제안하며, 이는 T2I 모델의 post-training을 fully automated, evaluation-driven adaptive loop로 전환하는 프레임워크입니다 [cite: 1, Figure 1]. APT는 세 가지 협력 에이전트로 구성됩니다: Evaluation Set Generation Agent, Diagnosis Agent, RL Data Generation Agent. Evaluation Set Generation Agent는 사용자 요구사항으로부터 prompt–evaluation rubric pair로 구성된 evaluation set을 생성합니다 [cite: 1, Figure 1]. Diagnosis Agent는 현재 모델을 이 evaluation set에 대해 평가하여 모델의 강점과 failure modes를 식별합니다 [cite: 1, Figure 1]. 마지막으로, RL Data Generation Agent는 이 진단 결과를 바탕으로 underperforming capabilities에 우선순위를 두는 adaptive prompt distribution으로 Reinforcement Learning (RL) data를 생성합니다 [cite: 1, Figure 1]. 이 feedback loop를 통해 모델의 행동이 다음 training tasks를 형성하며, training distribution은 모델의 evolving capability profile에 맞춰 지속적으로 변화합니다.
실험 결과, APT는 네 가지 Text-to-Image 모델 (Lens, SD3.5-Medium, FLUX.1 [Dev], LongCat-Image)에 걸쳐 기존의 handcrafted RL training set 대비 일관되게 높은 평균 성능을 달성했습니다 [cite: 1, Table 1]. 예를 들어, Lens 모델의 경우, Base Model은 평균 57.06점이었으나, Handcrafted RL Set을 적용했을 때는 68.61점으로 개선되었고, APT를 적용했을 때는 71.26점으로 가장 높은 성능을 보였습니다 [cite: 1, Table 1]. 특히, APT는 benchmark-agnostic 및 architecture-agnostic한 특성을 보여, 단일 APT run으로 여러 벤치마크에서 일관된 개선을 이루었으며, Diffusion-based 모델뿐만 아니라 autoregressive 모델인 Janus-Pro에서도 효과적임을 입증했습니다 [cite: 1, Table 1, Table 5]. 또한, APT가 모델별 training distribution을 효과적으로 포착한다는 사실이 입증되었는데, 한 모델에서 생성된 RL data를 다른 모델에 transfer하여 학습시키는 것이, 해당 target 모델을 위해 adaptive하게 data를 생성하는 것보다 일관되게 성능이 떨어졌습니다 [cite: 1, Table 2]. 이는 효과적인 post-training distribution이 model-specific하며 모델과 함께 evolution해야 한다는 가설을 뒷받침합니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 T2I 모델의 adaptive post-training을 위한 fully automated framework인 APT를 성공적으로 제시했습니다. APT는 evaluation set generation, model diagnosis, 그리고 RL data generation을 유기적으로 결합하여, 각 모델의 evolving capabilities에 맞춰 training distribution을 지속적으로 adaptive하게 조정합니다. 이 연구는 기존의 수동적이고 고정된 post-training 방식의 한계를 극복하고, handcrafted RL data 기반의 접근 방식보다 우수한 평균 성능을 달성함으로써 자동화된 post-training의 실용적인 방향을 제시합니다. 특히, model-specific training data의 중요성과 iterative feedback loop의 가치를 입증한 것은 해당 분야에 큰 시사점을 제공합니다. APT는 T2I 생성 분야에서 recursive self-improvement를 향한 중요한 단계이며, 학계 및 산업계 전반에 걸쳐 더욱 효율적이고 자동화된 모델 개선 프로세스의 가능성을 열었습니다.
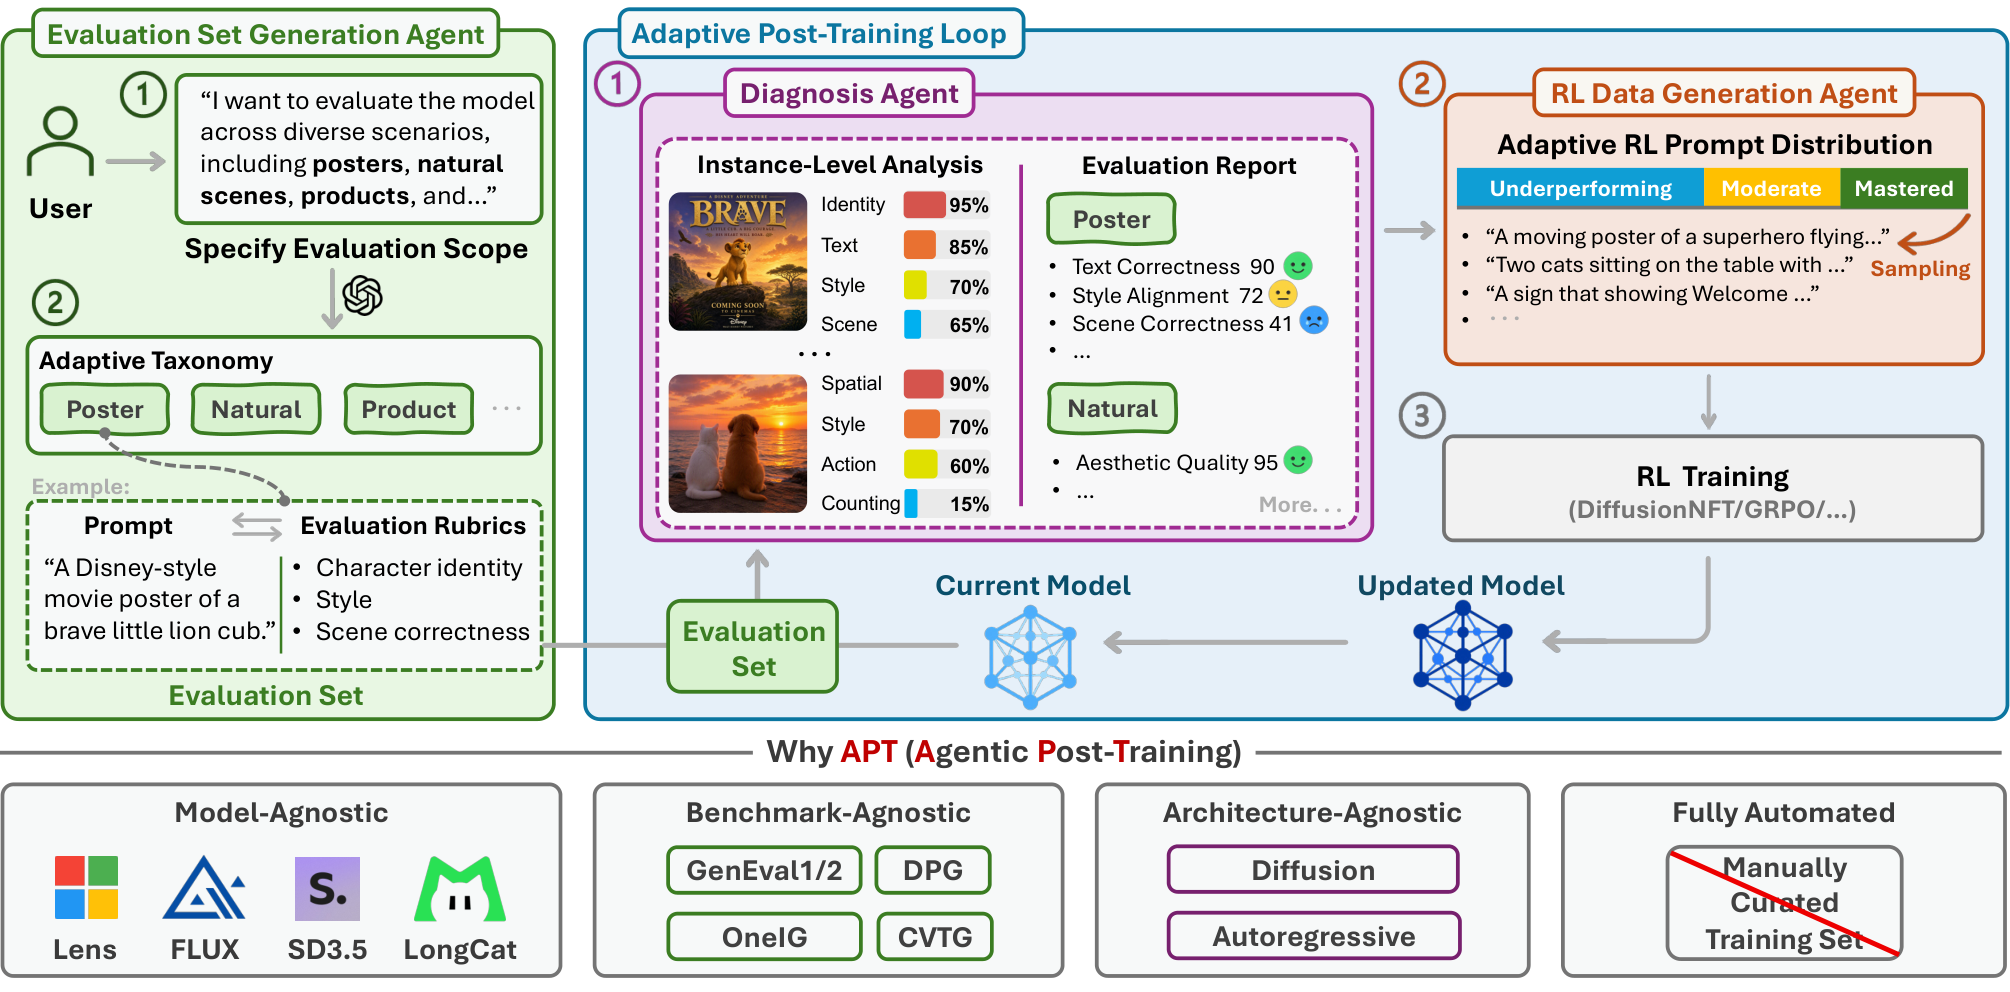
Figure 1 — APT 프레임워크 개요
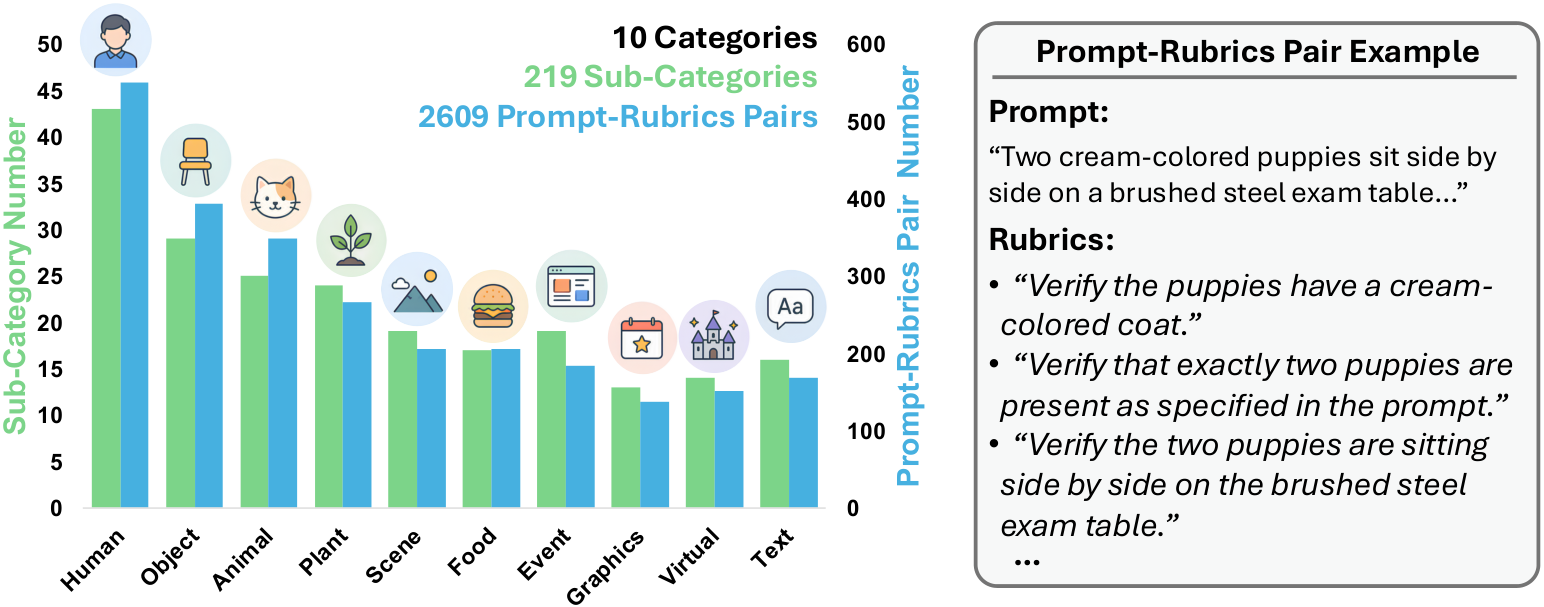
Figure 2 — Evaluation Set 통계 및 예시
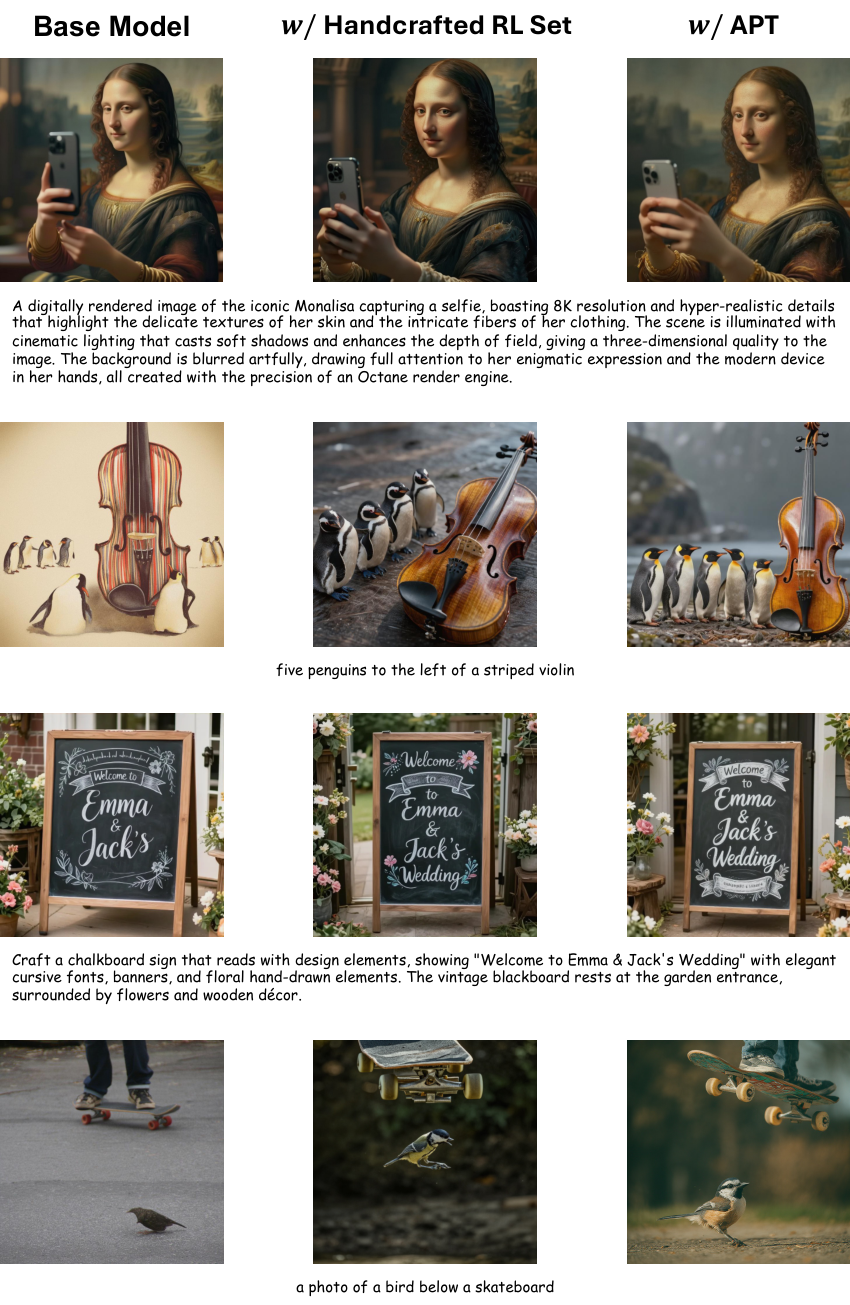
Figure 3 — Lens 모델의 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
- [논문리뷰] Decompose Radicals, Then Reward: Fine-Grained Inspection for Accurate Chinese Text Rendering
- [논문리뷰] NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness
- [논문리뷰] Read It Back: Pretrained MLLMs Are Zero-Shot Reward Models for Text-to-Image Generation
- [논문리뷰] Unlocking Complex Visual Generation via Closed-Loop Verified Reasoning
Review 의 다른글
- 이전글 [논문리뷰] X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
- 현재글 : [논문리뷰] APT: Feedback-Driven Agentic Post-Training for Text-to-Image Generation
- 다음글 [논문리뷰] Acting Through Registers
댓글