[논문리뷰] Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Guoming Ling, Yupei Lin, Zhongzhan Huang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Benchmark Compression: 전체 평가(Full-benchmark) 결과를 저비용의 부분 평가(Partial evaluation)로 근사하여 평가 비용을 절감하는 기법.
- Static Benchmark Compression: 평가 시작 전 미리 고정된 Subset을 결정하여 평가하는 방식으로,
Content-Based,Historical-Response,Target-Conditioned방식으로 분류됨. - Adaptive Evaluation: 평가 진행 중 발생하는 결과에 따라 다음에 평가할 항목(Item)을 선택하거나 평가 종료 시점을 결정하는 동적 평가 방식.
- Cross-Benchmark Compression: 개별 벤치마크 내에서의 중복뿐만 아니라, 여러 벤치마크 간의 중복성을 활용하여 전체 평가 비용을 공동으로 절감하는 기법.
- Model-by-Item Response Matrix: 여러 모델의 항목별 성능을 기록한 행렬로, 평가 효율화 및 항목별 난이도/변별력 분석의 기반 데이터로 사용됨.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 LLM의 비약적인 발전과 더불어 벤치마크 수가 급증함에 따라 발생하는 평가 비용의 비효율성 문제를 다룬다 [Figure 1]. 대다수의 기존 벤치마크는 상당한 중복성을 포함하고 있어, 전체 항목의 20% 미만으로도 충분히 모델의 성능을 유추할 수 있음이 확인되었다. 그러나 이러한 효율화 방법론들이 서로 다른 정보와 가정, 검증 방식을 사용함에 따라 연구 간 비교가 어렵고 실무적 지침이 부재한 상황이다. 따라서 저자들은 119개의 연구를 체계적으로 분류하고, 평가 비용 절감과 결과의 신뢰성 사이의 균형을 유지하기 위한 통합적인 프레임워크를 제안하고자 한다 [Figure 2].
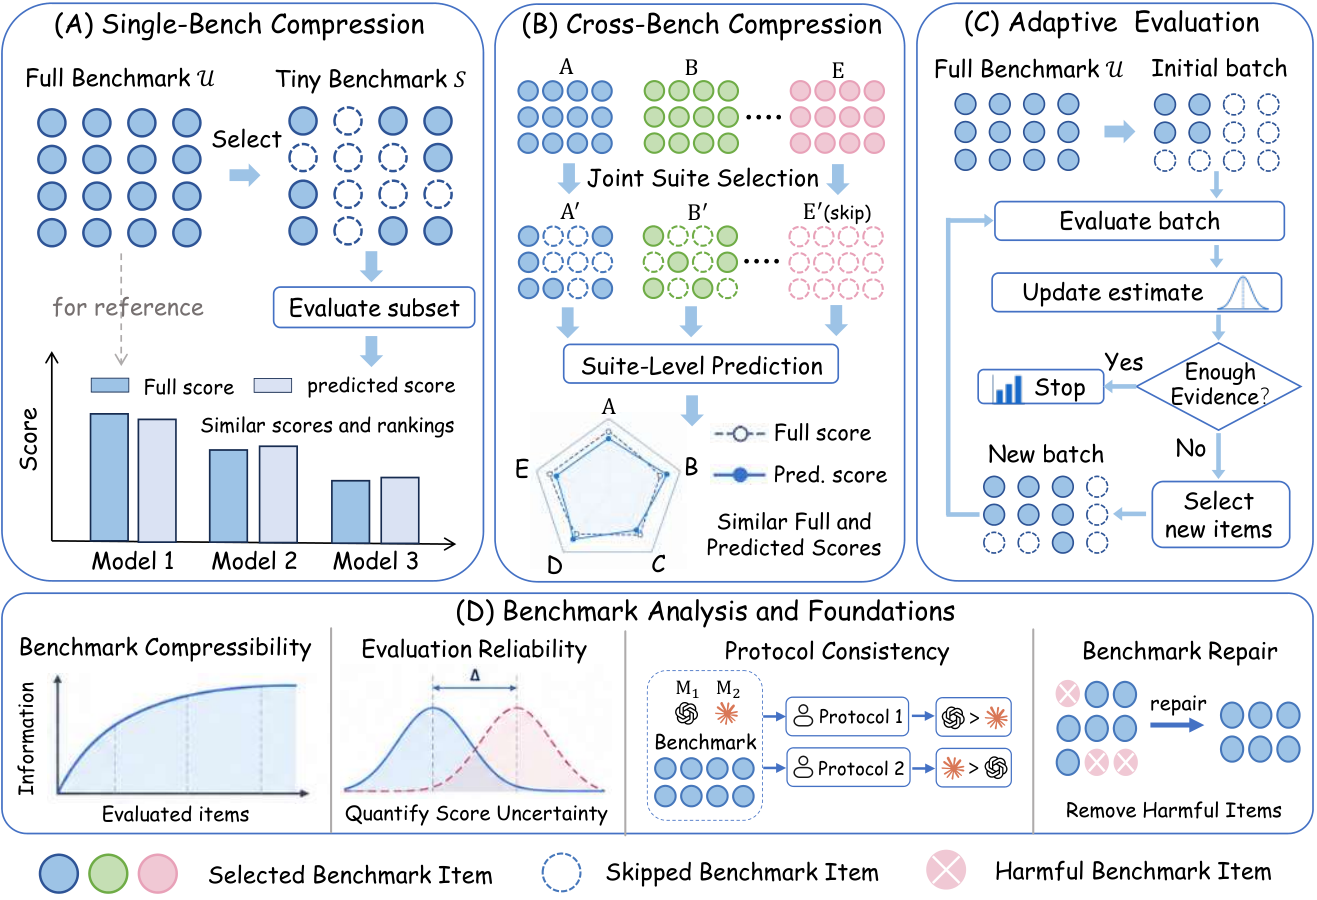
Figure 1 — 연구 프레임워크 구조
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 벤치마크 압축 기법을 크게 Static 방식과 Adaptive 방식으로 분류하는 새로운 Taxonomy를 제안한다 [Figure 3]. Static 압축은 평가 전 Subset을 고정하며, 벤치마크 데이터 자체를 활용하는 Content-Based, 과거 모델의 성능을 이용하는 Historical-Response, 현재 모델의 저비용 신호를 활용하는 Target-Conditioned 방식으로 나뉜다 [Table 1]. 반면 Adaptive Evaluation은 Adaptive Item Selection을 통해 매 단계마다 최적의 항목을 선택하거나, Sequential Decision and Stopping을 통해 특정 정밀도 도달 시 평가를 조기 종료함으로써 불필요한 연산을 방지한다 [Table 2]. 주요 실험 결과 분석에 따르면, Adaptive 방식은 정보 효율성은 높으나 평가의 직렬화(Serialization)로 인한 Latency 증가 문제가 존재한다. 반면 Static 방식은 병렬 처리에 유리하지만, 모델의 성능 변화에 따른 분포 이동(Distribution Shift) 시 예측 정확도가 저하될 수 있다. 저자들은 이들 기법이 단순 벤치마크 수치 재현을 넘어, 항목의 변별력 분석이나 벤치마크 자체의 품질 개선(Benchmark Repair)에도 기여할 수 있음을 강조한다.
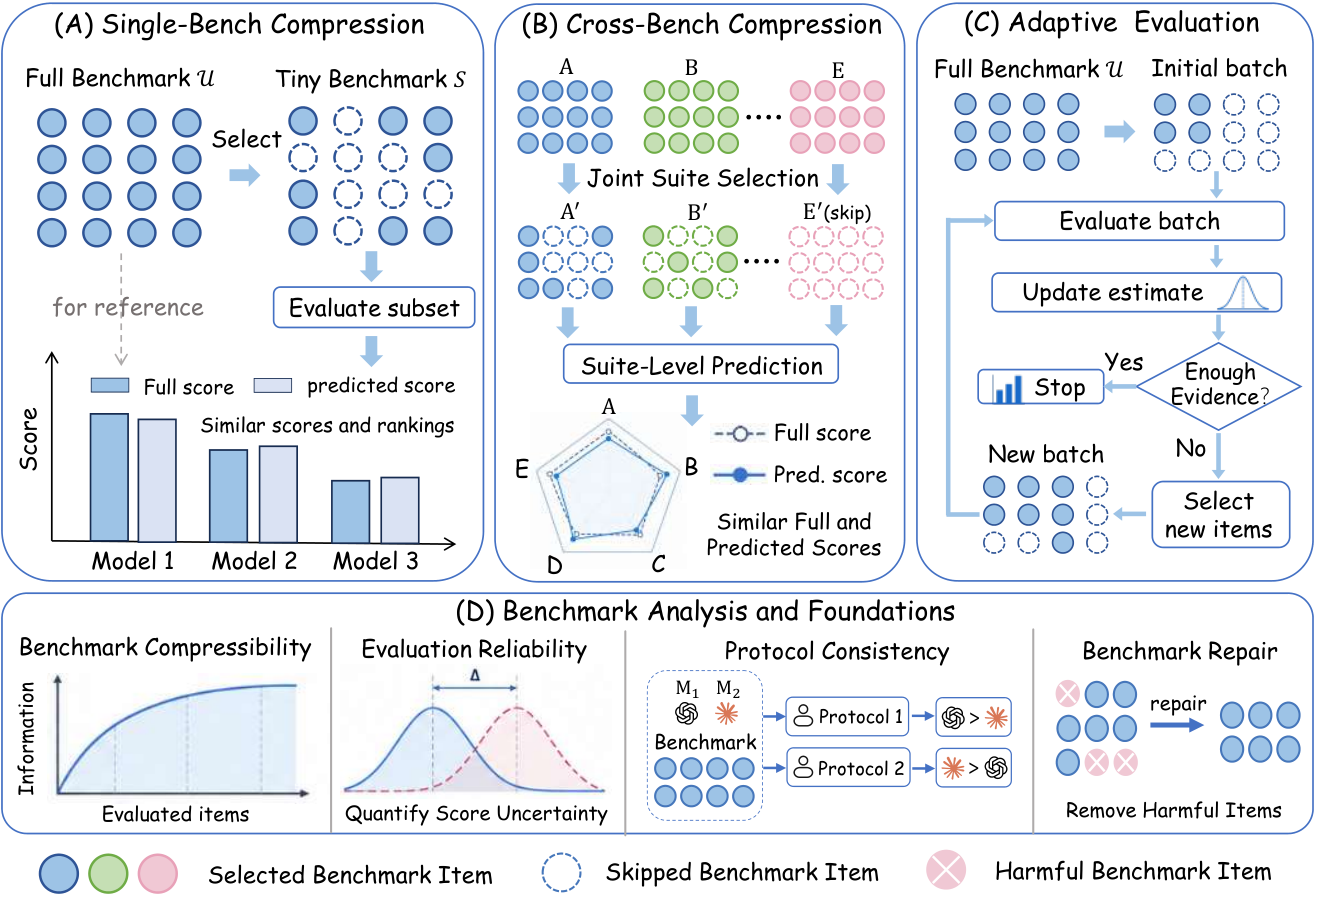
Figure 3 — 압축 연구 분류 체계
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 LLM 평가의 효율성을 극대화하기 위한 벤치마크 압축 연구의 첫 체계적 Survey로서, 연구자들에게 기법 선택을 위한 명확한 기준과 로드맵을 제공한다. 연구 결과, 압축 기법은 평가 비용을 절감하는 동시에 신뢰성 있는 성능 추정이 가능함을 입증하였다. 향후 연구 방향으로는 모델과 데이터의 진화에 따른 일반화(Generalization) 성능 확보와, 실시간 업데이트가 반영된 최신 벤치마크 평가 프레임워크 구축이 핵심이 될 것이다. 본 조사는 학계 및 산업계에서 LLM 평가 파이프라인을 최적화하고 평가의 신뢰도를 높이는 데 중요한 기술적 토대가 될 것으로 기대된다.
Part 2: 중요 Figure 정보

Figure 1 — 벤치마크 압축 연구의 구조
Figure 3 — 벤치마크 압축의 분류 체계

Figure 4 — 단일 벤치마크 압축 예시
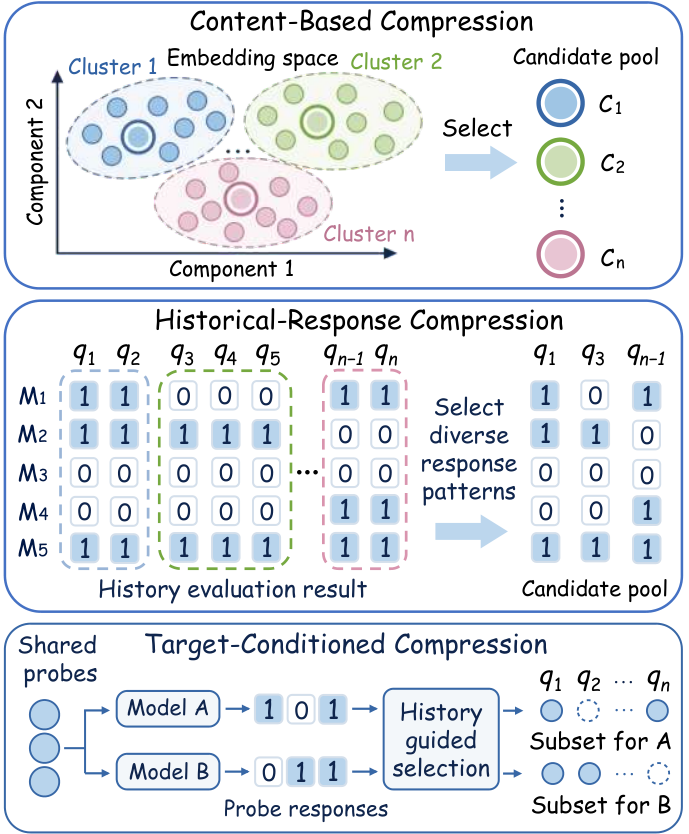
Figure 4 — 단일 벤치마크 압축 기법
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
- [논문리뷰] VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
- [논문리뷰] AMLworld-Compact: Importance-Weighted Downsampling for Cost-Effective LLM Evaluation and Error Diagnosis
- [논문리뷰] Minimal Witness Reinforcement Learning
- [논문리뷰] Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
Review 의 다른글
- 이전글 [논문리뷰] Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
- 현재글 : [논문리뷰] Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
- 다음글 [논문리뷰] Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
댓글