[논문리뷰] Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
링크: 논문 PDF로 바로 열기
저자: Shi-Yu Tian, Yong Liu, Ximan Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- On-Policy Distillation (OPD): 학생 모델의 현재 정책에 의해 생성된 Trajectory에 대해 강력한 Teacher가 Token-level의 Dense Supervision을 제공하여, 학생 모델의 Learning을 Guidance하는 방법론입니다.
- Multi-Teacher On-Policy Distillation (MOPD): 여러 Specialized Teacher의 Complementary Capabilities를 단일 학생 모델에 통합하기 위해 Domain-specific Data를 해당 Teacher에 Routing하여 Distillation하는 OPD의 확장된 형태입니다.
- Gradient Conflict: MOPD 환경에서 서로 다른 Domain에서 발생한 Supervision이 Shared Parameter에 대해 최적화 과정에서 Interfering Update Direction을 유발하여 발생하는 문제로, Performance Degradation의 주된 원인이 됩니다.
- Cross-Teacher Guarding (Road MOPD): 본 논문에서 제안하는 방법론으로, Non-routed Teacher를 Auxiliary Cross-domain Critic으로 활용하여 Gradient Conflict를 Anticipate하고 Mitigate하며, Token-level Credit Assignment 및 Gradient Update Coordination을 통해 Multi-teacher Supervision을 조정합니다.
- Credit Assignment: Language Model이 생성한 Response의 성공 또는 실패를 특정 Generation Decision에 할당하는 과정으로, Reinforcement Learning에서 중요한 Challenges 중 하나입니다.
- Preventive Gradient Projection: Road MOPD의 Gradient-level 접근 방식으로, Auxiliary Gradient를 사용하여 Target-domain Update의 Conflicting Component를 Suppress하고 Target-gradient Norm Retention Constraint 하에 Projection Strength를 Adaptive하게 조절합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Multi-teacher On-policy Distillation (MOPD) 과정에서 발생하는 업데이트 비호환성(Update Incompatibility) 문제를 해결하고자 합니다. 기존 MOPD 방법론들은 Domain-routed Supervision을 통해 Domain-specific Data를 Specialized Teacher에게 할당하지만, 모든 Domain의 업데이트가 Shared Parameter에 작용하기 때문에, Teacher 간의 Response Style 및 Domain Expertise가 크게 다를 경우 Persistent Gradient Conflict 및 Capability Degradation이 발생할 수 있습니다. 특히, 단일 Domain에서 효과적인 Supervision이라도 Joint Optimization 시 Interfering Update Direction을 유발하여 Multi-domain Capability Integration을 제한합니다. [Figure 1]의 왼쪽 패널은 Vanilla MOPD에서 Domain-routed Supervision이 Shared Parameters에 Conflicting Updates를 발생시킬 수 있음을 보여줍니다. 예를 들어, Math 및 Code Domain의 Joint Training은 상대적으로 Gradient Conflict가 적고 성능 개선을 보였으나, Medical Domain과 Math 또는 Code를 Joint Training하는 경우 높은 비율의 Conflicting Gradients가 발생하며 Medical Performance가 Single-domain OPD Baseline보다 떨어지는 현상이 관찰되었습니다. 이러한 기존 연구의 한계점은 Domain Routing만으로는 Shared Parameters를 통한 Capability Transfer를 효과적으로 Coordinate하기에 불충분함을 시사합니다.
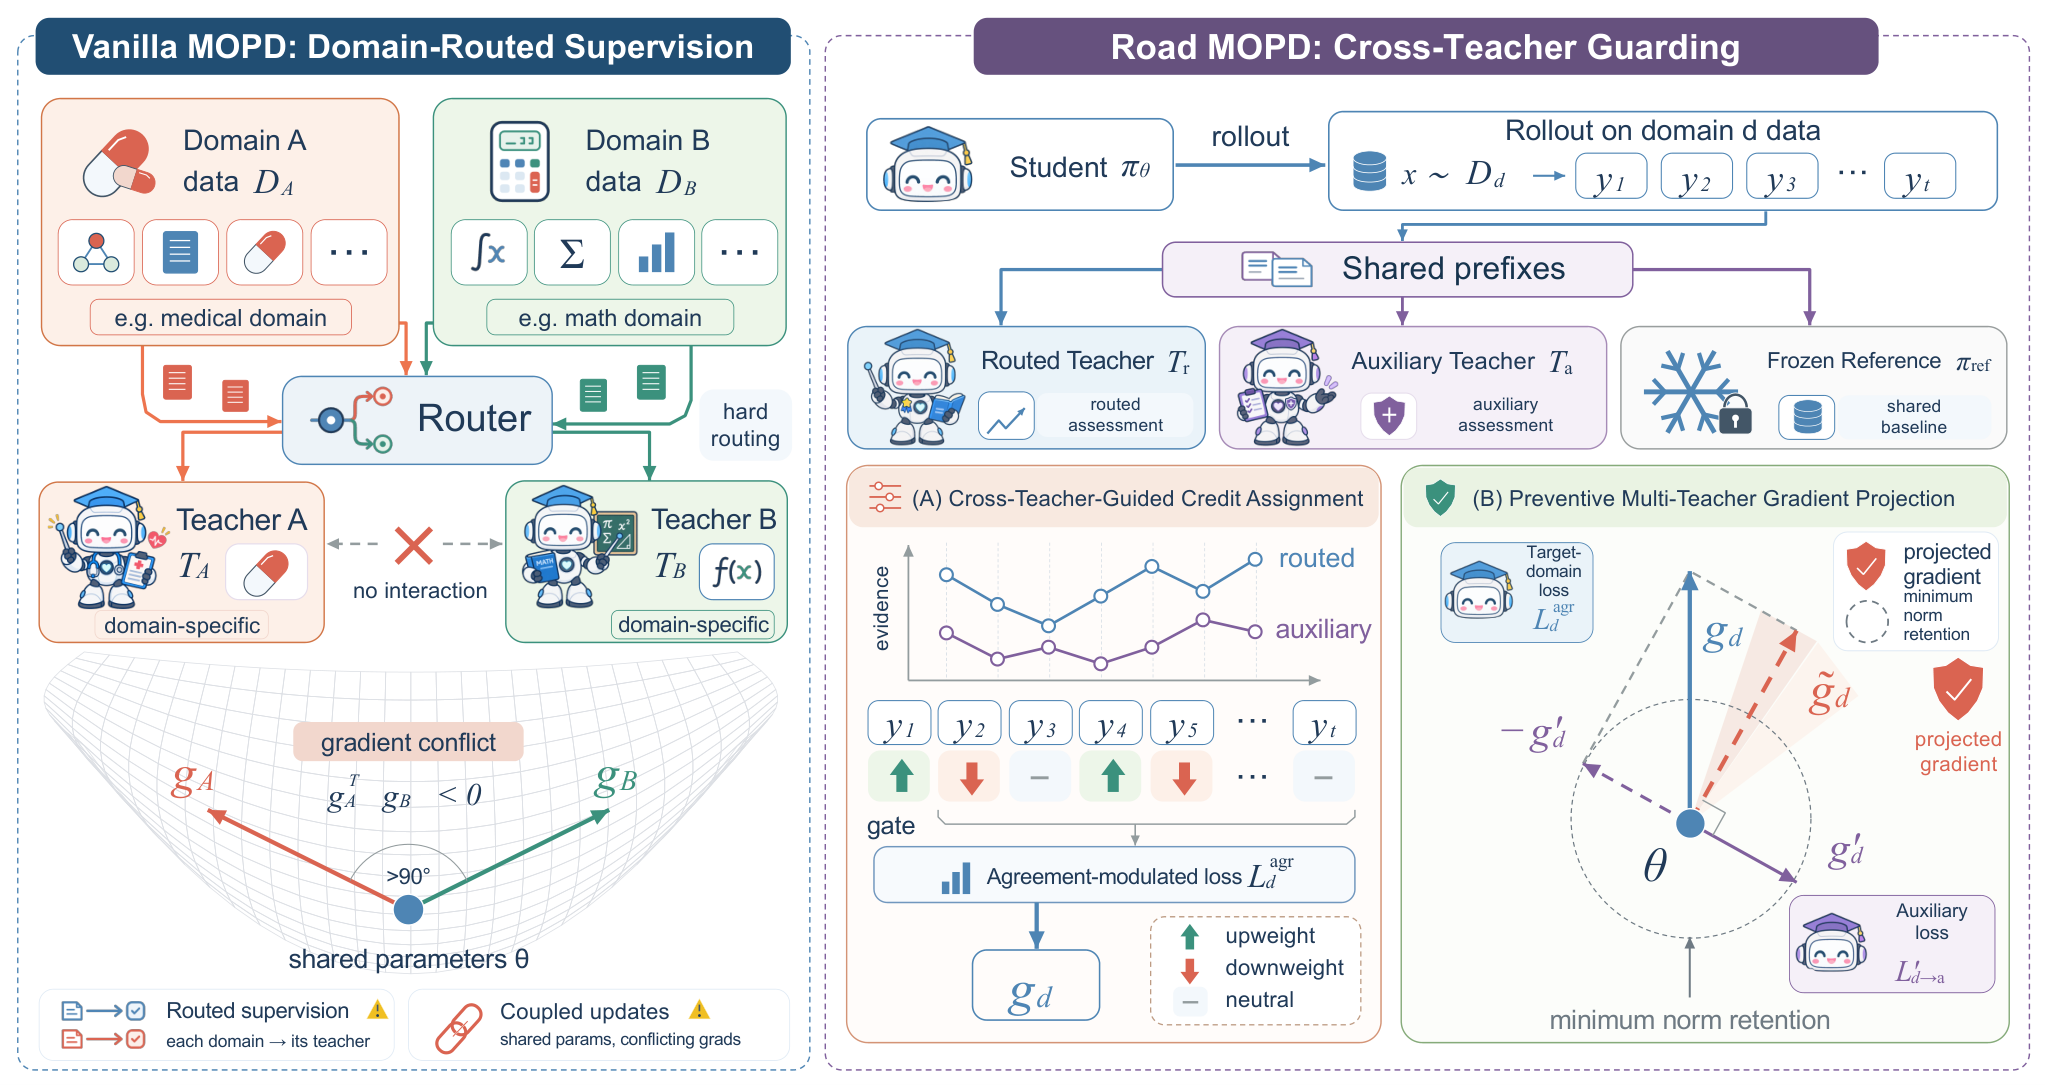
Figure 1 — Vanilla MOPD와 Road MOPD 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 기존 MOPD의 한계를 극복하기 위해 Cross-Teacher Guarding for MOPD (Road MOPD)를 제안합니다. Road MOPD는 Non-routed Teacher를 동일한 Student-generated Trajectory에 대한 Auxiliary Cross-domain Critic으로 활용하며, Token-level Credit Assignment와 Gradient Update Coordination을 통해 Multi-teacher Supervision을 조정합니다. [Figure 1]의 오른쪽 패널은 Road MOPD의 전반적인 메커니즘을 보여줍니다.
구체적으로, Road MOPD는 다음 두 가지 핵심 구성 요소를 포함합니다.
- Cross-Teacher-Guided Credit Assignment: Routed Teacher와 Auxiliary Teacher의 Token-level Agreement를 측정하여 Relative Reward에 대한 Token-wise Coefficient(
λt)를 조정합니다. Teachers가 동일한 Correction Direction을 선호할 때 Supervision을 강화하고, 서로 상충하는 Signal일 경우 해당 Token에 대한 Reward를 Attenuate합니다. Agreement Score (st)는 Routed Teacher와 Auxiliary Teacher가 Shared Frozen Reference Model 대비 Log-probability 선호도(Preference)를 비교하여 계산됩니다. [Figure 2]의 오른쪽 패널은 Token-level Credit Assignment가 어떻게 Opposing Correction을 Attenuate하고 Aligned Correction을 Amplify하는지 시각적으로 보여줍니다. - Preventive Multi-Teacher Gradient Projection: Agreement-modulated Loss로부터 Target-domain Gradient(
gd)를 계산한 후, 동일한 Trajectory에 대한 Auxiliary Teacher의 Feedback을 활용하여 Auxiliary Gradient(g'd)를 구성합니다. Local Conflict가 발생할 경우, Target-gradient Norm Retention Floor (m)를 준수하면서 Conflict를 최소화하는 방향으로 Partial Projection(~gd)을 수행합니다. 이는 기존의 Post-hoc Gradient Surgery 방식과 달리 Auxiliary Teacher의 Feedback을 활용하여 Target-domain Update에 대한 Gradient Constraint를 사전에 적용하는 Preventive한 접근 방식입니다.
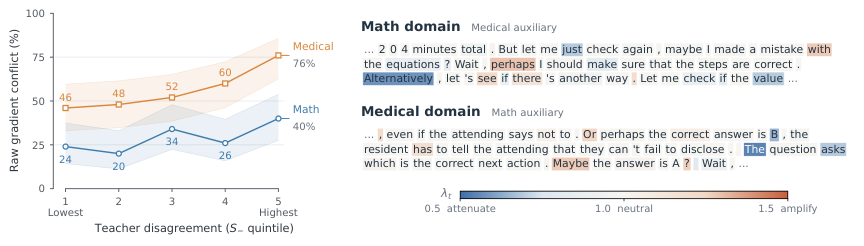
Figure 2 — Teacher 불일치 및 토큰별 Supervision
실험 결과, Road MOPD는 다양한 Domain 조합 및 Teacher–Student Configuration에서 뛰어난 성능을 보였습니다. 특히 Math × Medical 및 Code × Medical과 같은 High-conflict Setting에서, Qwen3-1.7B Student Model의 Medical Accuracy를 5.6~8.8 Percentage Points 개선하여 Vanilla MOPD를 크게 상회했습니다. Qwen3-4B Student Model의 경우, Medical Accuracy를 Single OPD Reference 수준까지 회복시키면서 동시에 다른 Domain의 성능도 향상시켰습니다. Low-conflict Setting인 Math × Code에서는 55.40의 "All Avg."를 달성하며 ExOPD를 0.35 Points 앞섰고, Three-domain Setting (Math × Code × Medical)에서는 모든 Domain에서 Baseline들을 능가하며 52.89의 "All Avg."를 기록하여 CaMOPD보다 1.18 Points 우수했습니다. [Table 1]과 [Table 3]은 이러한 Main Results를 보여줍니다. 또한, [Figure 3]은 Preventive Projection이 PCGrad와 같은 Post-hoc Correction 방식보다 Joint Learning에서 더 우수한 성능을 제공함을 보여주며, Ablation Study를 통해 Credit Assignment와 Gradient Protection 각 Component의 기여도와 Adaptive Retention의 중요성이 확인되었습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Multi-teacher On-policy Distillation (MOPD)의 핵심 과제인 업데이트 비호환성(Update Incompatibility) 문제를 성공적으로 해결했습니다. 제안하는 Road MOPD는 Auxiliary Teacher를 활용하여 동일한 학생 Trajectory를 평가하게 함으로써, Agreement-aware Token Weighting과 Preventive Gradient Projection을 통해 Conflicting Supervision 및 업데이트를 억제하고 Target-domain Learning Signal을 유지합니다. 이 연구는 Mathematics, Medicine, Code Domain에 걸쳐 High-conflict Domain에서의 성능 저하를 완화하고, Compatible Setting에서의 강점을 유지하며, Three-domain Joint Training 환경에서 가장 우수한 Distilled Model Average를 달성했습니다. Road MOPD는 Large Language Models (LLMs)의 Multi-domain Capability Integration을 위한 효과적인 Framework를 제공하며, 이는 학계 및 산업계에서 보다 Robust하고 Versatile한 LLM을 개발하는 데 중요한 시사점을 가집니다. 향후 연구는 더 광범위한 Domain과 대규모 Teacher Pool에 대한 확장 및 Computational Overhead 감소를 위한 효율적인 Teacher Selection 및 Compatibility Estimation 방안을 모색할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] Semifactual Credit-Augmented Policy Optimization
- [논문리뷰] Economy of Minds: Emerging Multi-Agent Intelligence with Economic Interactions
- [논문리뷰] ESPO: Early-Stopping Proximal Policy Optimization
- [논문리뷰] AEM: Adaptive Entropy Modulation for Multi-Turn Agentic Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
- 현재글 : [논문리뷰] Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
- 다음글 [논문리뷰] BigCell: Generating Gigapixel Whole-Slide Images
댓글