[논문리뷰] Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
링크: 논문 PDF로 바로 열기
저자: Yuyao Ge, Shenghua Liu, Peizhong Gao, Chendi Ge, Chenxu Liu, Yiwei Wang, Lingrui Mei, Baolong Bi, Jiayu Yao, Jiafeng Guo, Xueqi Cheng
1. Key Terms & Definitions (핵심 용어 및 정의)
- Harness: LLM 기반 코딩 에이전트가 실행되는 주변 환경(infrastructure)을 지칭하며, 세션 상태, 도구 실행, 권한 관리, 결과 검증 등을 담당함.
- Contract Skeleton: 초기 단계에서 제공되는 최소한의 인터페이스 선언문으로, 구현체(Implementation)를 제외한 뼈대 코드.
- Candidate Harness: 빌드 모델(build model)이 Contract Skeleton을 사용하여 최종적으로 생성한 완성형 Harness 결과물.
- Positive Control: 관찰된 Pass가 단순한 오류나 우연이 아닌 의도된 동작에 의한 것임을 검증하기 위해 도입된 제어 장치로, Vacuous Pass를 방지함.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 기반 코딩 에이전트의 성능이 모델 자체뿐만 아니라 이를 둘러싼 Harness의 설계 품질에 크게 의존함에도 불구하고, 기존 벤치마크들이 Harness 자체의 엔지니어링 능력을 평가하지 못한다는 점을 지적한다. 기존의 SWE 벤치마크들은 고정된 환경에서 하위 작업의 성공 여부만을 측정하므로, 에이전트가 자신의 동작을 제어하는 인프라를 직접 구축하고 개선하는 능력을 평가하기 어렵다. 이를 해결하기 위해 저자들은 Doc2Harness라는 2단계 평가 프레임워크를 제안하며, 이는 모델이 스스로 Harness를 구축하도록 유도하여 그 성능을 결정론적으로 평가하는 최초의 벤치마크이다 [Figure 2].
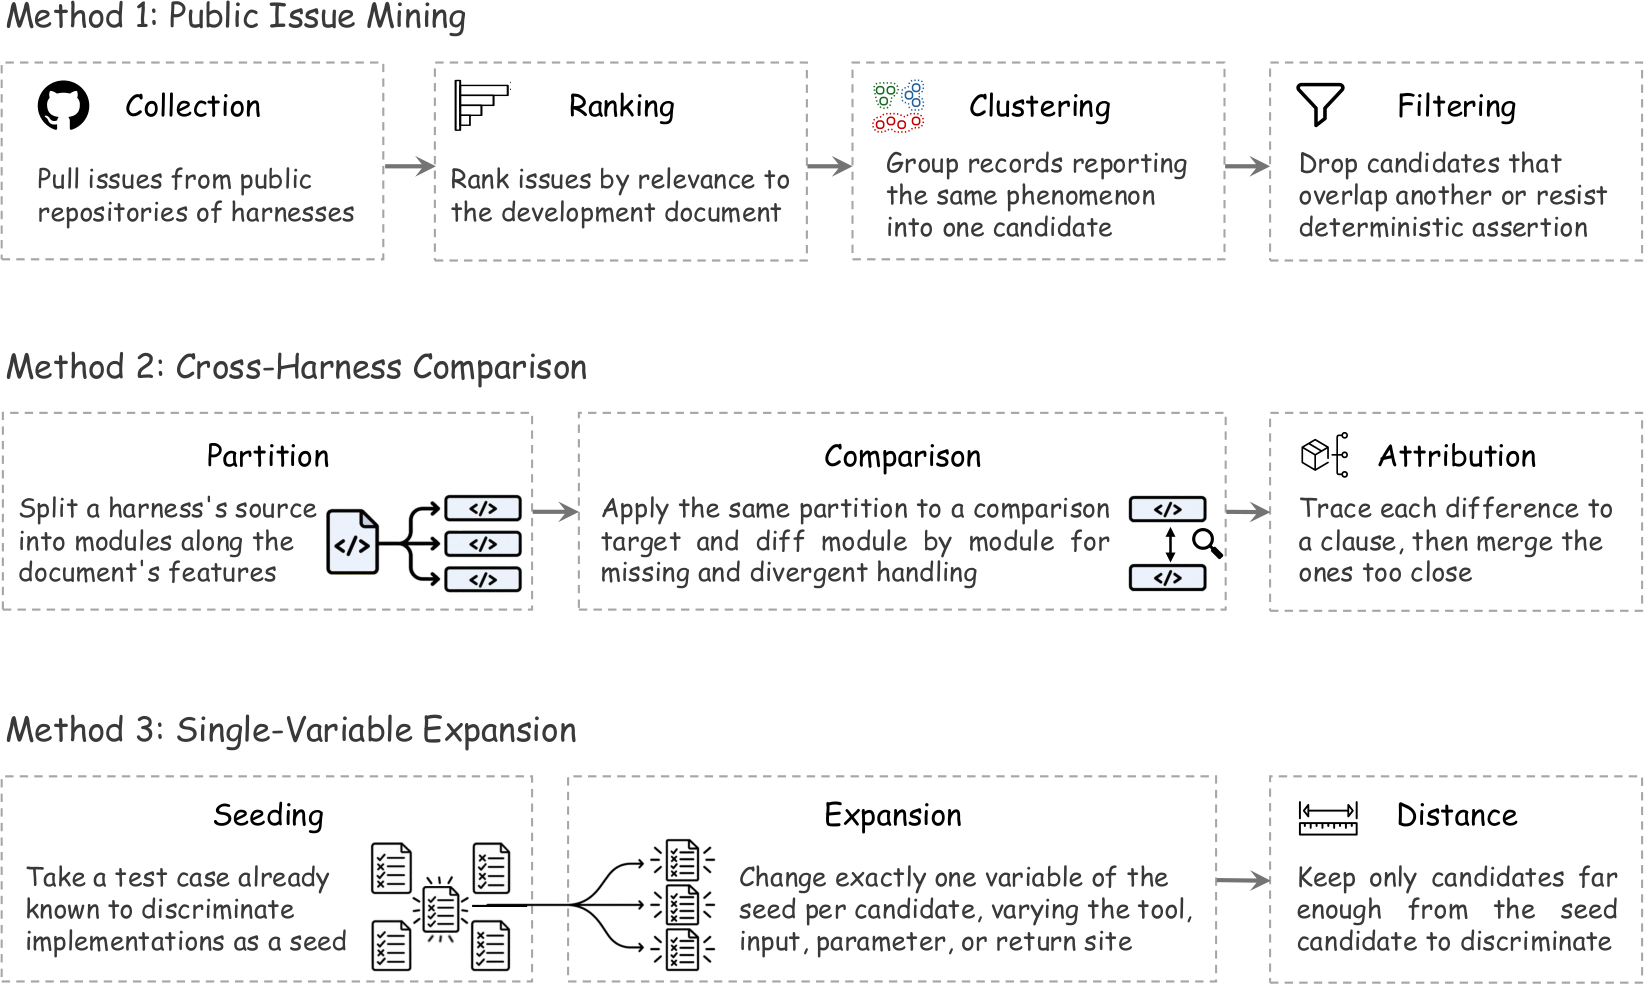
Figure 2 — Doc2Harness 전체 프로세스
3. Method & Key Results (제안 방법론 및 핵심 결과)
Doc2Harness는 1단계에서 빌드 모델이 Development Document와 Contract Skeleton을 기반으로 Candidate Harness를 생성하고, 2단계에서 Mock model을 사용하여 이를 블랙박스 방식으로 평가한다. 빌드 모델은 OpenCode 환경에서 구축을 수행하며, 제출된 결과물은 4가지 관찰 채널(요청 내용, 디스크 파일, 프로세스 종료 코드, 명령어 출력)을 통해 테스트 케이스를 통과하는지 평가받는다 [Figure 2]. 19개의 최신 모델을 대상으로 328개의 테스트 케이스를 수행한 결과, GPT-6 Astra가 53.05%의 Pass rate로 가장 우수한 성능을 보였고, 가장 낮은 성능의 모델은 27.44%를 기록하여 약 26%p의 격차를 보였다 [Figure 1]. 실험 결과, 모델들은 전반적으로 Boundary 상황에서의 대처 능력에서 큰 성능 차이를 보였으며, 우수한 모델일수록 크로스 커팅 기능을 더 적은 수의 모듈로 결집하는 경향을 나타냈다 [Table 2].
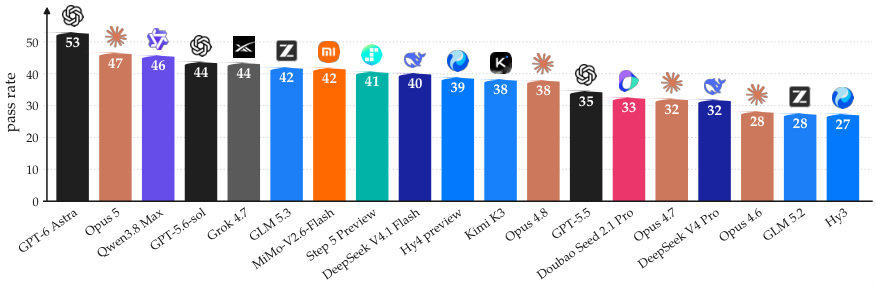
Figure 1 — 모델별 Pass rate 순위
4. Conclusion & Impact (결론 및 시사점)
본 연구는 코딩 에이전트의 핵심 인프라인 Harness 구축 능력을 평가하는 새로운 정량적 방법론을 제시하였다. Doc2Harness는 모델의 일반화 능력을 테스트하는 결정론적 벤치마크로서, 향후 더 복잡하고 자율적인 에이전트 개발을 위한 중요한 이정표가 될 것이다. 연구 결과는 모델의 규모뿐만 아니라 아키텍처 설계 능력이 에이전트의 전체 성공률에 결정적인 영향을 미친다는 것을 시사한다. 이 프레임워크는 학계와 산업계 모두에서 더 나은 코딩 에이전트를 설계하고 평가하는 기준으로 활용될 것으로 기대된다.
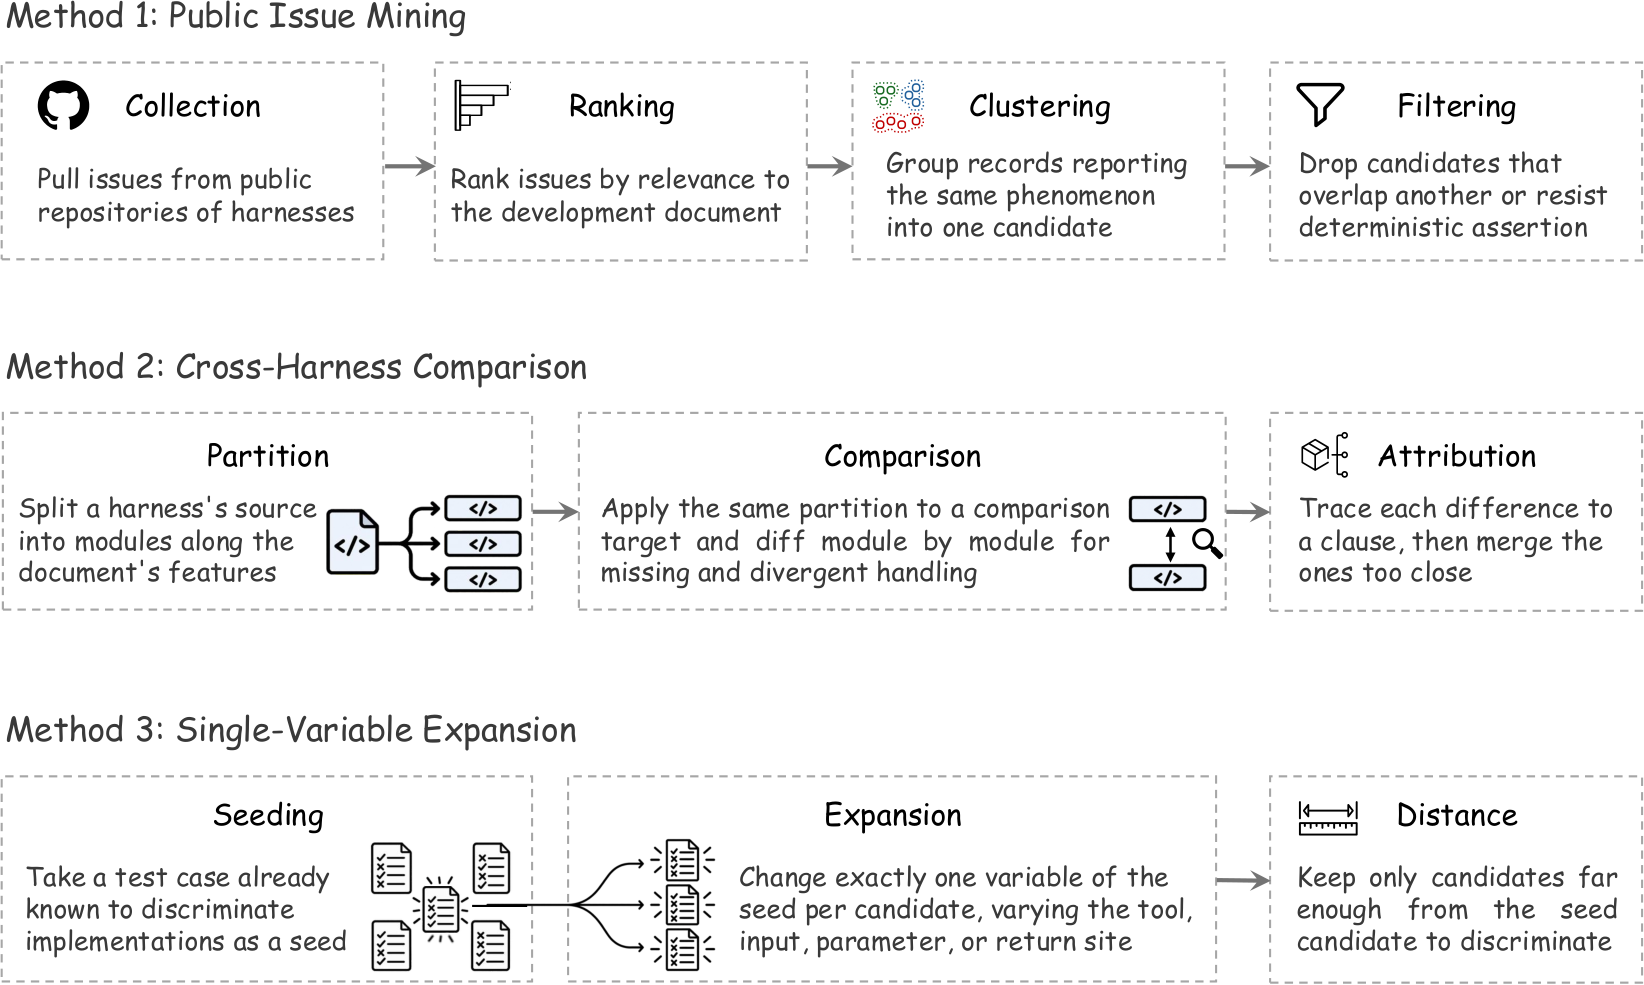
Figure 3 — 테스트 케이스 합성 방법론
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Stateless Language Agents: Scaling Long-Horizon Automated Research
- [논문리뷰] ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
- [논문리뷰] Emergence World: Adversarial Stress-Testing of Long-Horizon Multi-Agent Systems
- [논문리뷰] VibeLifeBench: Can Your Life Agent Be Proactive and Persistent in a Living World?
- [논문리뷰] Mendel Gödel Machine: Recursive Self-Improving Coding Agents via Comparative Evolution
Review 의 다른글
- 이전글 [논문리뷰] Diff Diffusion: Predicting Edit Paths with Diffusion Models for Efficient Code Editing
- 현재글 : [논문리뷰] Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
- 다음글 [논문리뷰] Efficient Scene-Text Refinement via Pixel-Space Grouped Image Generation
댓글