[논문리뷰] SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
링크: 논문 PDF로 바로 열기
The paper is titled "SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm". Authors: Qianru Meng, Xi Zhang, Konstantinos Papakostas, Congfeng Cao, Wenxiang Hu, Tianyi Lu, Xiao Zhang, Lun Zhou, Zaiqiao Meng, Zhaochun Ren, Xiaohui Yan, Yougang Lyu. Affiliations mostly from Huawei Technologies Co., Ltd., Leiden University, University of Groningen.
I need to identify keywords. Based on the abstract and introduction, "Recursive Self-Improvement", "Scientific Agent Swarm", "Feedback-Guided Swarm Mutation", "Complementary Swarm Recombination", and "Recursive Swarm Evolution" are key terms.
Now I will structure the summary.
Part 1: Summary Body
## 1. Key Terms & Definitions
- Recursive Self-Improvement (RSI): 에이전트가 자신의 실험 경험을 통해 연구 역량을 향상시키는 목표를 의미합니다.
- Scientific Agent Swarm: 여러 전문화된 에이전트들이 아이디어 생성, 구현, 평가를 조율하여 연구 목표를 추구하는 시스템입니다.
- Research State: 가설 (hypotheses), 프로그램 (programs), 실험적 증거 (experimental evidence), 그리고 미해결 요구사항 (unresolved needs)을 포함하여 에이전트가 현재의 연구 활동을 계획하는 데 사용하는 정보 집합입니다.
- Feedback-Guided Swarm Mutation: 다른 에이전트들의 실험 피드백을 활용하여 가설 또는 해당 구현 (program)을 수정할지 결정하는 메커니즘입니다. H-mutation은 가설을 변경하고, P-mutation은 가설을 유지한 채 구현을 수정합니다.
- Complementary Swarm Recombination: 다른 에이전트들의 유효한 프로그램 기반 위에서 유지된 가설을 재검토하고, 상호 보완적인 프로그램 구성 요소들을 결합하여 재사용하는 메커니즘입니다. Rebase와 Crossover 작업이 포함됩니다.
- Recursive Swarm Evolution: 모든 실험 결과(성공, 실패, 개선 없음 포함)를 공유 그래프(shared graph)에 기록하고, 이 상태를 활용하여 다음 에이전트가 어떤 가설을 재검토하고 어떤 프로그램을 개선할지 결정하는 프로세스입니다.
## 2. Motivation & Problem Statement 본 논문은 과학 연구 분야에서 Recursive Self-Improvement (RSI)를 달성하려는 Scientific Agent Swarm의 두 가지 주요 한계점을 해결하고자 합니다. 첫째, 실패한 실험은 가설(hypothesis)이 문제였는지 혹은 그 구현(implementation)이 문제였는지 명확히 밝히지 못하여 유망한 가설이 부적절한 구현 때문에 버려질 수 있습니다 [cite: 1, Figure 1]. 둘째, 전체적으로 성능 개선이 없는 프로그램이라 할지라도 다른 에이전트의 향후 연구에 유용한 구성 요소(components)를 포함할 수 있지만, 이러한 유용성이 간과될 수 있습니다 [cite: 1, Figure 1]. 기존 연구들은 프로그램 진화(program evolution) 또는 가설 진화(hypothesis evolution)에 초점을 맞추었으나, 가설의 가치가 구현 방식과 테스트 엄격성에 의존하고, 중간 결과의 가치가 다른 발견과의 조합에 따라 달라지는 상호 연관된 문제들을 효과적으로 다루지 못했습니다. 이러한 문제들은 에이전트들이 경험을 공유하더라도 더 나은 연구 결정을 내리지 못하게 하는 원인이 됩니다.
## 3. Method & Key Results 저자들은 Recursive Self-Improvement (RSI)를 위해 Scientific Agent Swarm을 진화시키는 프레임워크인 SwarmRSI를 제안합니다. 이 프레임워크는 에이전트들이 상속하는 연구 상태(research states)를 진화시키는 것을 핵심으로 합니다. 각 에이전트는 가설, 프로그램, 실험 증거 및 미해결 요구사항을 활용하여 연구를 계획하며, 이 모든 상속 가능한 연구 상태는 공유 그래프(shared graph)에 기록됩니다.
SwarmRSI는 세 가지 핵심 메커니즘을 통해 연구 상태를 업데이트합니다 [cite: 1, Figure 2]:
- Feedback-Guided Swarm Mutation: 에이전트들이 다른 에이전트의 실험 피드백을 사용하여 가설과 프로그램을 수정합니다. 성능 차이는 가설 수정에 정보를 제공하고, 미해결 연구 요구사항은 구현 변경을 안내합니다. H-mutation은 가설을 변경하고, P-mutation은 가설을 유지한 채 프로그램을 수정합니다.
- Complementary Swarm Recombination: 에이전트들이 기존 가설을 다른 에이전트의 구현에 재적용(rebase)하거나, 상호 보완적인 강점을 가진 프로그램 구성 요소들을 결합(crossover)하여 부분적인 결과를 재사용합니다.
- Recursive Swarm Evolution: 모든 결과(성공, 실패, 개선 없음 포함)를 공유 그래프에 반환하고, 이 상태를 기반으로 다음 에이전트가 어떤 가설을 재방문하고 어떤 프로그램을 개선할지 결정합니다. 이 과정은 H/P selection 메커니즘을 통해 discounted-UCB index를 사용하여 다음 업데이트를 결정합니다.
실험 결과, SwarmRSI는 다양한 벤치마크에서 State-of-the-Art (SOTA) 성능을 달성했습니다.
- OpenProblems 벤치마크에서 Gemini 3.1 Pro Preview를 백본으로 사용했을 때 평균 점수 76.2를 달성하여 비교 대상 방법론 중 가장 높은 성능을 보였습니다 [cite: 1, Table 1]. DeepSeek-V4-Pro를 사용했을 때는 74.2를 기록하며 TusoAI의 67.1을 능가했습니다.
- NatureBench 벤치마크에서 DeepSeek-V4-Pro를 사용했을 때 Match-SOTA 비율이 44.4%에 달했으며, 이는 Arbor보다 7.8%p 높고 AIDE보다 16.7%p 높은 수치입니다 [cite: 1, Table 2]. Gemini 3.1 Pro Preview를 사용했을 때도 동일하게 44.4%의 Match-SOTA 비율을 기록했습니다 [cite: 1, Figure 3].
- MLE-Bench Lite 벤치마크에서는 DeepSeek-V4-Pro와 Gemini 3.1 Pro Preview 모두 Any-Medal 비율 81.8%를 달성하며 Arbor와 MLEvolve를 상회했습니다 [cite: 1, Table 3]. 또한, DeepSeek-V4-Pro를 사용한 NatureBench 실험에서 최종 최적 프로그램의 약 77%가 rebase, crossover 또는 피드백에 의해 촉발된 업데이트에서 파생된 것으로 나타나, SwarmRSI의 재사용 메커니즘이 성능 향상에 크게 기여함을 입증했습니다.
## 4. Conclusion & Impact 본 논문은 과학 에이전트 군집이 직면하는 두 가지 주요 장애물, 즉 실패한 실험에서 가설과 구현 중 무엇이 문제인지 불분명한 점과 전체적으로 이득이 없는 프로그램 내 유용한 구성 요소의 간과 문제를 효과적으로 해결합니다. SwarmRSI는 Feedback-Guided Swarm Mutation을 통해 가설 수정과 프로그램 수리 결정을 최적화하고, Complementary Swarm Recombination을 통해 유지된 가설과 유용한 구성 요소를 다른 에이전트의 작업에 통합합니다. Recursive Swarm Evolution은 모든 실험 결과를 공유 그래프에 피드백하여 이후 에이전트의 연구 시작점을 지속적으로 개선합니다. 이러한 접근 방식은 OpenProblems 및 NatureBench에서 SOTA 성능을 달성했으며, 생물학자들이 장 및 비장 면역 분석에 SwarmRSI가 생성한 프로그램을 재현하여 활용할 정도로 실질적인 과학적 유용성을 입증했습니다 [cite: 1, Figure 5]. 결과적으로, 이 연구는 에이전트 군집이 상속하는 연구 상태를 진화시킴으로써 자체 연구 역량을 향상시킬 수 있음을 시사하며, 이는 AI 기반 과학 발견 분야에 중요한 발전을 가져올 것입니다.
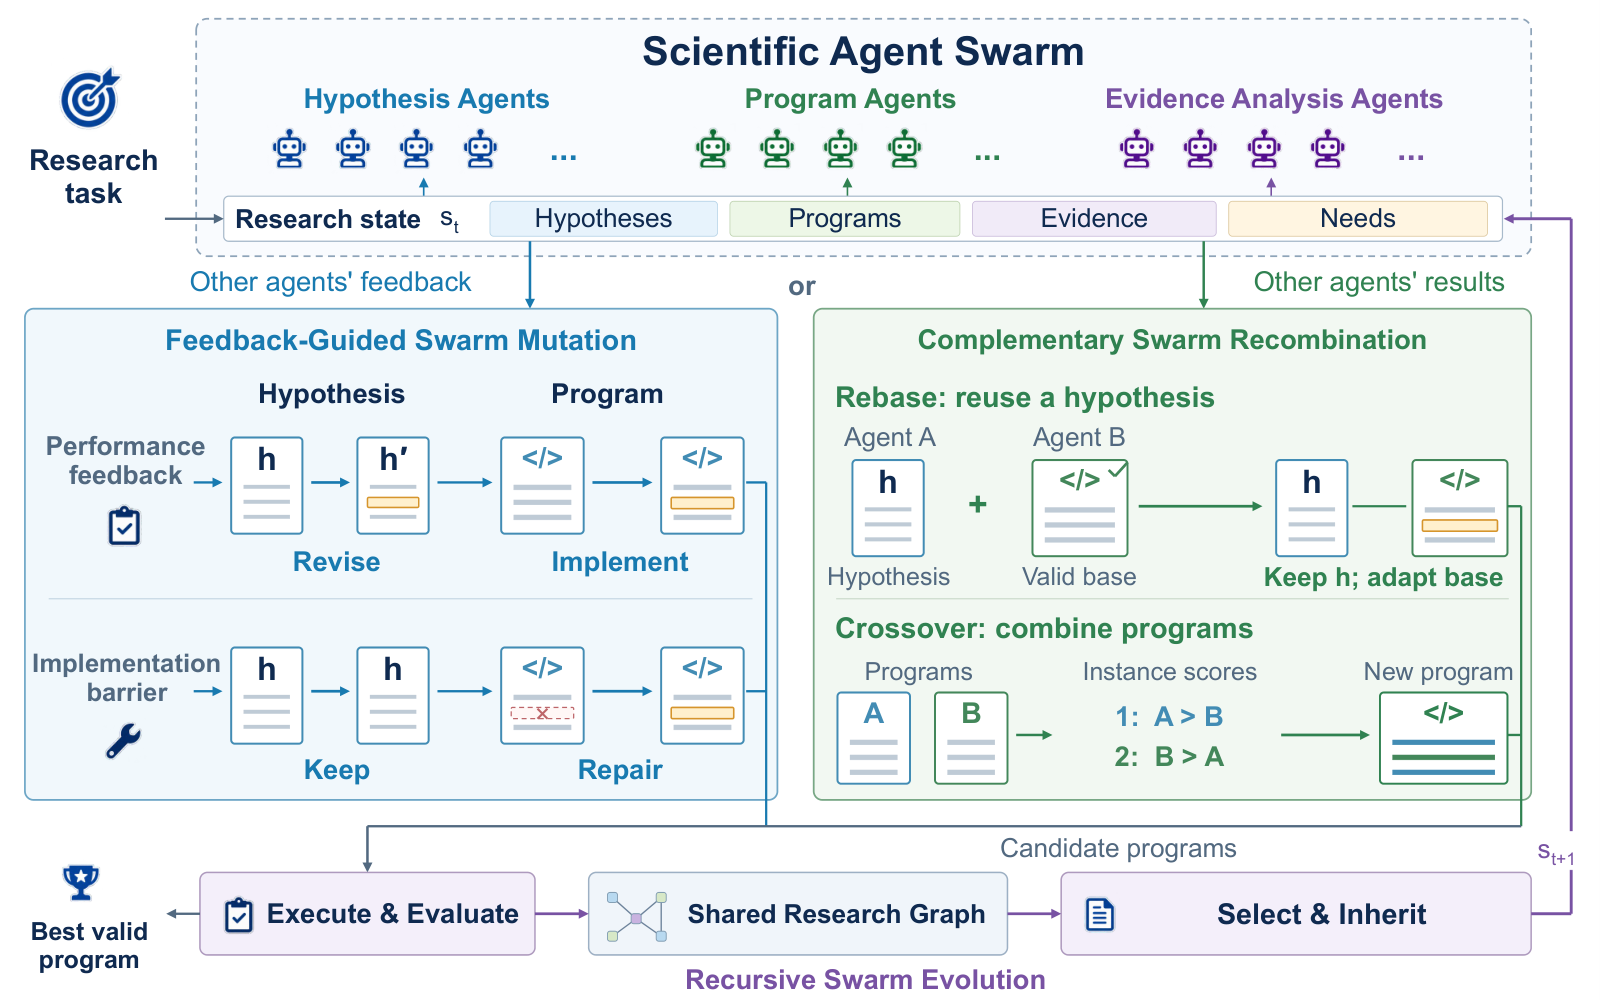
Figure 1 — SwarmRSI 개발 동기가 된 두 가지 한계점
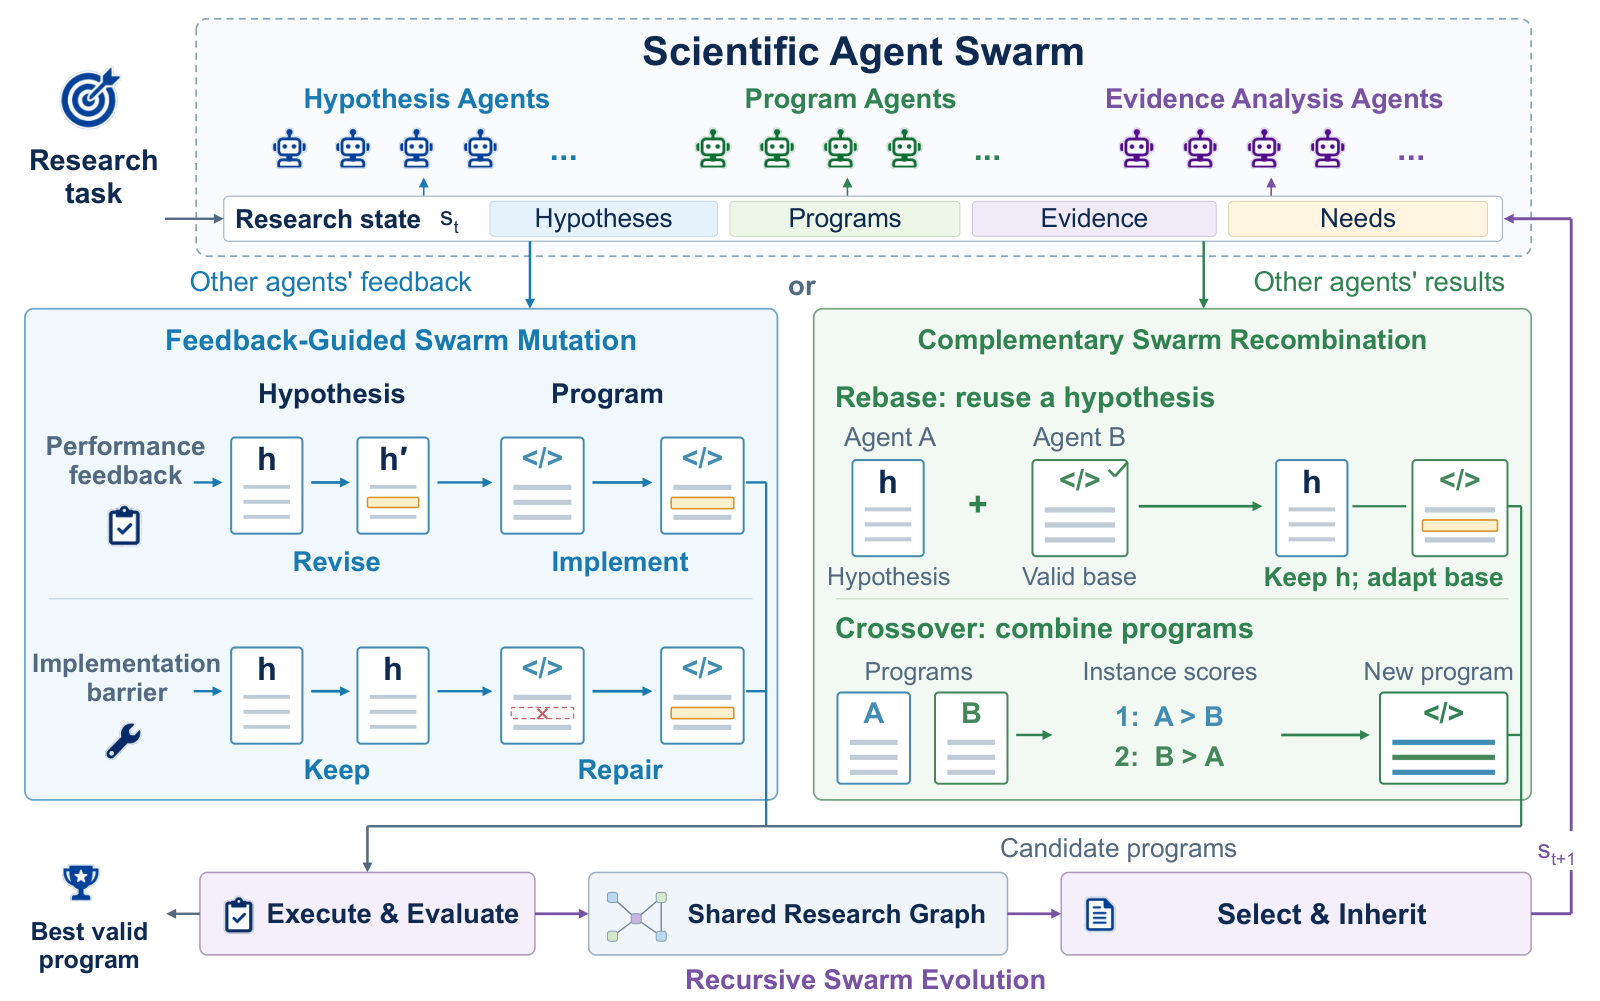
Figure 2 — SwarmRSI의 전체 아키텍처 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Virtual Head Attention
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Review 의 다른글
- 이전글 [논문리뷰] Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
- 현재글 : [논문리뷰] SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
- 다음글 [논문리뷰] TextVerifier: Seeing Beyond Recognition to Verify Chinese Text Rendering
댓글