[논문리뷰] Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
링크: 논문 PDF로 바로 열기
저자: Wanzhou Lei, Cuifeng Shen, Yanjin He, Maohua Li, Hua Yuan, Per-Olof Persson, Tao Lan, Kan Liu, Hanlin Tang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Latent Space Manifold: 고해상도, 자연스럽고 선명한 이미지의 임베딩이 형성하는 공간으로, 이미지의 품질 저하(degradation)는 해당 이미지의 임베딩을 이 manifold에서 벗어나게 한다. SR(Super-Resolution)은 degraded embedding을 manifold의 올바른 지점으로 매핑하는 작업이다.
- DINOv3-L: self-supervised learning을 통해 대규모 이미지 데이터셋에 사전 학습된 Vision Transformer 모델의 일종으로, 본 논문에서는 DINOv3-L의 frozen encoder의 fused layers를 SR 작업의 latent substrate로 활용한다. 이는 pixel 재구성이 아닌 표현 일치(representation matching) 학습에 중점을 둔다.
- Fidelity-Perception Trade-off: 이미지 복원 모델의 성능을 평가하는 두 가지 상충 관계 지표이다. Fidelity는 원본 이미지와의 픽셀 일치도를 측정하며, Perception은 사람이 인지하는 시각적 품질을 평가한다. 이 연구는 이 두 지표 사이의 최적의 균형을 찾는 것을 목표로 한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
현재의 Real-world Super-Resolution (SR) 방법론들은 degraded image의 latent embedding이 clean image manifold에서 멀리 떨어져 있는 reconstruction-oriented latent space나 pixel space에서 복원 작업을 수행한다. 이러한 공간들은 degraded image의 정보를 충실히 보존하기 때문에, degraded image의 임베딩이 manifold에서 멀리 떨어져 있게 되고, 이는 복원 매핑(mapping)을 어렵고 비용이 많이 들게 만든다. 또한, 이러한 substrate들은 semantic information이 부족하여 매핑 과정에서 올바른 지점을 찾기 어렵게 만들고, 이는 심각한 hallucination 현상을 초래한다. 기존 연구들은 encoder fine-tuning이나 external semantic guidance injection과 같은 방법으로 이러한 문제를 완화하려 했지만, 근본적인 문제인 부적절한 latent substrate 사용 자체는 해결하지 못했다. 따라서 저자들은 효율적이고 고품질의 SR을 위해 적절한 latent space를 substrate로 선택하는 것이 중요하다고 주장하며, degraded image가 manifold에 가깝게 임베딩되고 풍부한 information hierarchy를 제공하는 공간의 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 degraded image가 clean image manifold에 더 가깝게 임베딩되고 풍부한 information hierarchy를 제공하는 DINOv3-L의 frozen encoder의 fused layers를 latent substrate로 활용하는 새로운 SR 방법론인 RAESR을 제안한다. DINOv3-L의 24개 레이어 중 23개 레이어를 융합하여 pixel detail부터 degradation-robust semantics까지 다양한 수준의 정보를 담고 있는 latent space를 구성한다. 이 information hierarchy는 manifold의 올바른 지점으로의 매핑에 직접적인 guidance를 제공한다. 이 substrate 위에서 415M 파라미터를 가진 단일 Decoder를 훈련하여 degraded embedding을 manifold로 매핑하고 pixel space로 한 번에 디코딩한다. Decoder는 L1, LPIPS, 그리고 Adversarial objective를 포함하는 loss function으로 학습된다. 특히, Adversarial term은 학습의 중요한 부분으로, Critic은 DINOv3-B encoder의 12개 레이어로부터 각 토큰의 "realness"를 평가하는 학습 가능한 convolutional head로 구성되어, dense하고 position-paired 방식으로 realism 요구 사항을 fine-grained하게 제공한다. 실험 결과, RAESR은 RealSR, DRealSR, LSDIR, DIV2K-Val 벤치마크에서 SOTA adversarial 및 diffusion-based restorer들 중 최고의 Fidelity-Perception trade-off를 달성한다. RAESR은 NIQE, DISTS, MANIQA에서 가장 우수한 점수를 기록했으며, LPIPS, MUSIQ, TOPIQ에서는 두 번째로 우수한 성능을 보였다. 또한, 단일 H20 GPU에서 512x512 이미지당 37ms의 inference time을 기록하며 최고의 Efficiency-Perception trade-off를 보여준다. Human preference study에서도 RAESR은 Real-HAT-GAN, DiffBIR, SUPIR, TSD-SR 등 4개의 경쟁 모델 대비 높은 선호도를 얻었다. [Figure 1] [Figure 2] [Figure 4]
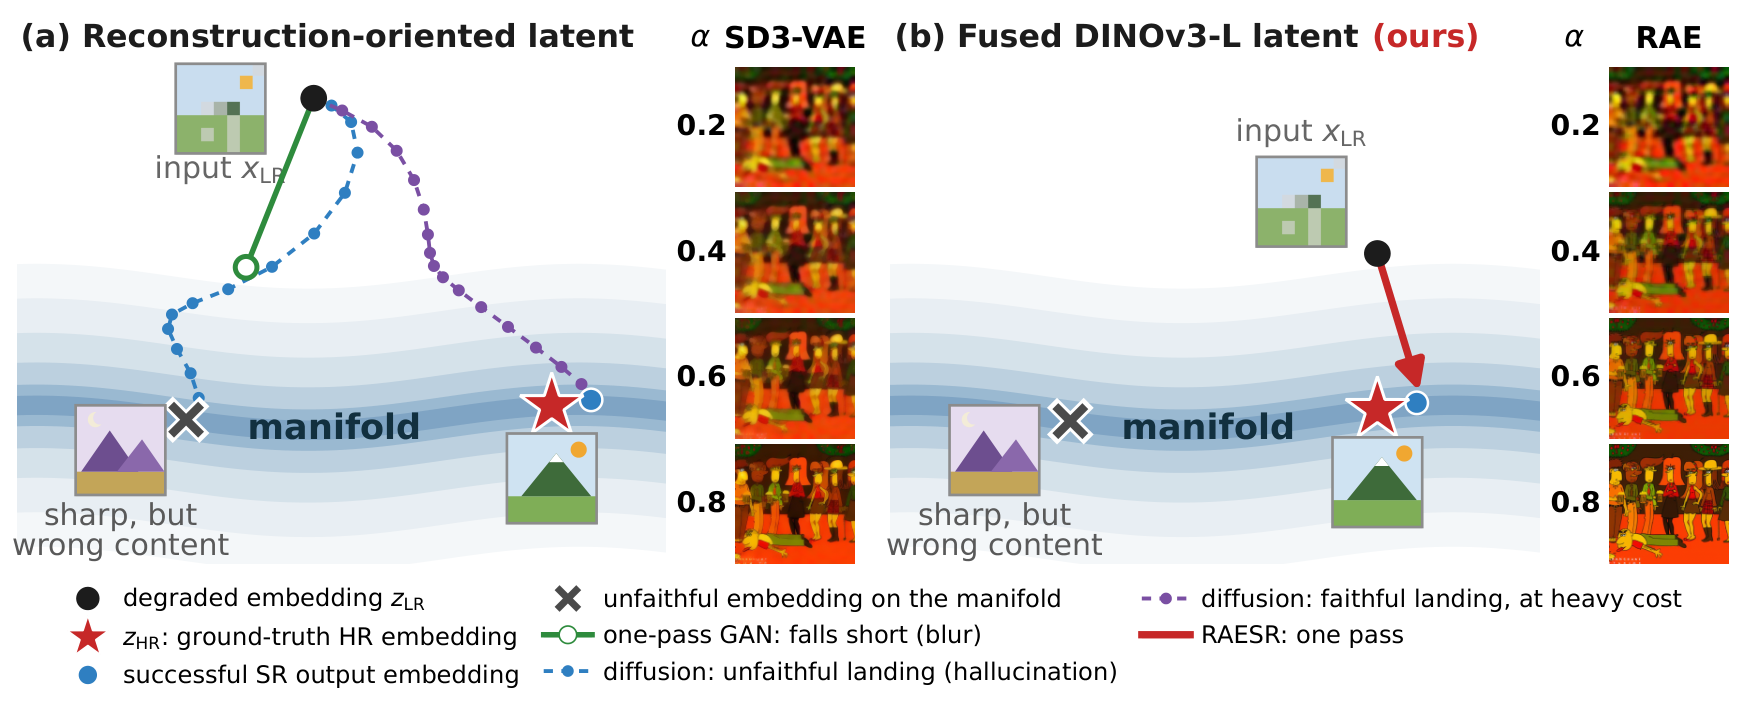
Figure 1 — 잠재 공간 선택에 따른 SR 작업 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 SR 작업의 난이도를 결정하는 데 적절한 latent space 선택이 결정적임을 강조한다. Degraded image가 manifold에 가깝게 임베딩되고 pixel record부터 semantic 정보까지 모든 수준의 guidance를 제공하는 fused DINOv3-L latent space가 이상적인 substrate임을 입증했다. 제안된 RAESR 모델은 단 한 번의 decoder pass를 통해 SOTA 성능을 달성하며, 기존 방법론들의 느린 추론 속도와 낮은 품질 문제를 해결한다. 이는 향후 SR 연구가 latent substrate의 선택에 더 많은 관심을 기울여야 함을 시사하며, 효율적이고 고품질의 이미지 복원 기술 발전에 중요한 영향을 미칠 것으로 예상된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] One Small Step in Latent, One Giant Leap for Pixels: Fast Latent Upscale Adapter for Your Diffusion Models
- [논문리뷰] The Unanticipated Asymmetry Between Perceptual Optimization and Assessment
- [논문리뷰] Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
- [논문리뷰] AdvSim2Real : Training Web Agents Against Adaptive Prompt Injection in a Web World Model
- [논문리뷰] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
Review 의 다른글
- 이전글 [논문리뷰] StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
- 현재글 : [논문리뷰] Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
- 다음글 [논문리뷰] SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
댓글