[논문리뷰] τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
링크: 논문 PDF로 바로 열기
저자: Rishitosh Kumar Singh, Amir Saeidi, Shamanthak Hegde, Shrinidhi Kumbhar, Chitta Baral
1. Key Terms & Definitions
- τ-Emotion-Bench: LLM 에이전트가 통제된 감정 조건화 사용자 상호작용 하에서도 본질적인 작업 목표를 유지하면서 툴-콜링 능력을 평가하도록 설계된 10개 도메인의 벤치마크이다.
- Tracer: 접지되고 정책-유효한 태스크를 구성하고 상호작용 에이전트-사용자-환경 하네스를 통해 궤적(trajectories)을 수집하는 확장 가능한 에이전트적(agentic) 데이터 생성 파이프라인이다.
- Interaction-aware reward signal: Tracer 하네스 내의 메커니즘으로, 불만족한 사용자(시뮬레이션된)가 비효율적인 상호작용을 종료할 수 있도록 하여 과도한 사용자 의존성을 가진 궤적을 필터링하고 효과적인 툴 사용을 선호하는 신호를 제공한다.
- Avg@3: 주어진 태스크에 대한 세 번의 시도(trials)에 걸친 평균 성공률을 나타내는 평가 지표로, 전반적인 성능을 측정한다.
- Pass^k: k번의 시도 중 최소 k번 성공적으로 완료된 태스크의 비율을 나타내는 평가 지표로, 반복적인 상호작용에서의 일관성(consistency)을 파악한다.
2. Motivation & Problem Statement
본 논문은 기존 LLM 에이전트 벤치마크가 터미널 태스크 성공에만 초점을 맞추어 사용자 상호작용의 효율성을 간과하는 문제점을 제기한다. 현재 롱-호라이즌(long-horizon) 툴-콜링(tool-calling) 태스크를 수행하는 LLM 에이전트들은 툴 사용 오류뿐만 아니라 사용자와의 비효율적인 상호작용으로 인해 실패할 수 있다. 기존 연구(baseline)들은 대부분 협조적이고 행동적으로 안정적인 사용자를 가정하며, 감정적 변화가 에이전트의 신뢰성(reliability)에 미치는 영향을 충분히 탐구하지 못했다.
이러한 한계점 때문에 에이전트가 태스크를 완료하더라도 불필요한 질문을 반복하거나, 툴을 통해 얻을 수 있는 정보를 계속 요청하거나, 환경과 상호작용하는 대신 사용자에게 과도하게 의존하는 등 사용자에게는 바람직하지 않은 행동을 보일 수 있다. 결과적으로, 현재의 에이전트 하네스(agent harnesses)는 태스크 완료 여부만을 측정할 뿐, 상호작용 자체의 효율성에 대한 신호를 거의 제공하지 못하는 중요한 단점을 드러낸다. 따라서 저자들은 감정 조건화된 사용자 상호작용 하에서 에이전트의 신뢰성을 평가하고, 상호작용 효율성을 고려한 새로운 벤치마크 및 데이터 생성 방법론의 필요성을 강조한다.
3. Method & Key Results
본 논문은 감정 조건화된 사용자 상호작용 하에서 툴-콜링 에이전트의 취약성을 노출하고 개선하기 위해 τ-Emotion-Bench와 Tracer 데이터 생성 파이프라인을 제안한다. τ-Emotion-Bench는 10개 도메인에 걸쳐 580개의 실행 가능한 태스크를 포함하며, 5가지 감정 계열(Anger, Fear, Disgust, Sadness, Enjoyment)과 22가지 세분화된 감정, 그리고 3가지 행동 차원(politeness, urgency, trust)을 통해 사용자 행동을 체계적으로 변화시킨다. Tracer는 접지되고 정책-유효한 툴 워크플로우를 통해 이러한 태스크를 구성하고, interaction-aware reward signal을 제공하는 에이전트-사용자-환경 하네스를 사용하여 훈련 궤적을 생성한다 [Figure 2]. 이 하네스에서는 사용자가 비효율적인 상호작용으로 불만족하면 세션을 종료할 수 있어, 에이전트가 불필요한 사용자 의존성을 줄이고 효율적인 툴 사용을 하도록 유도한다.
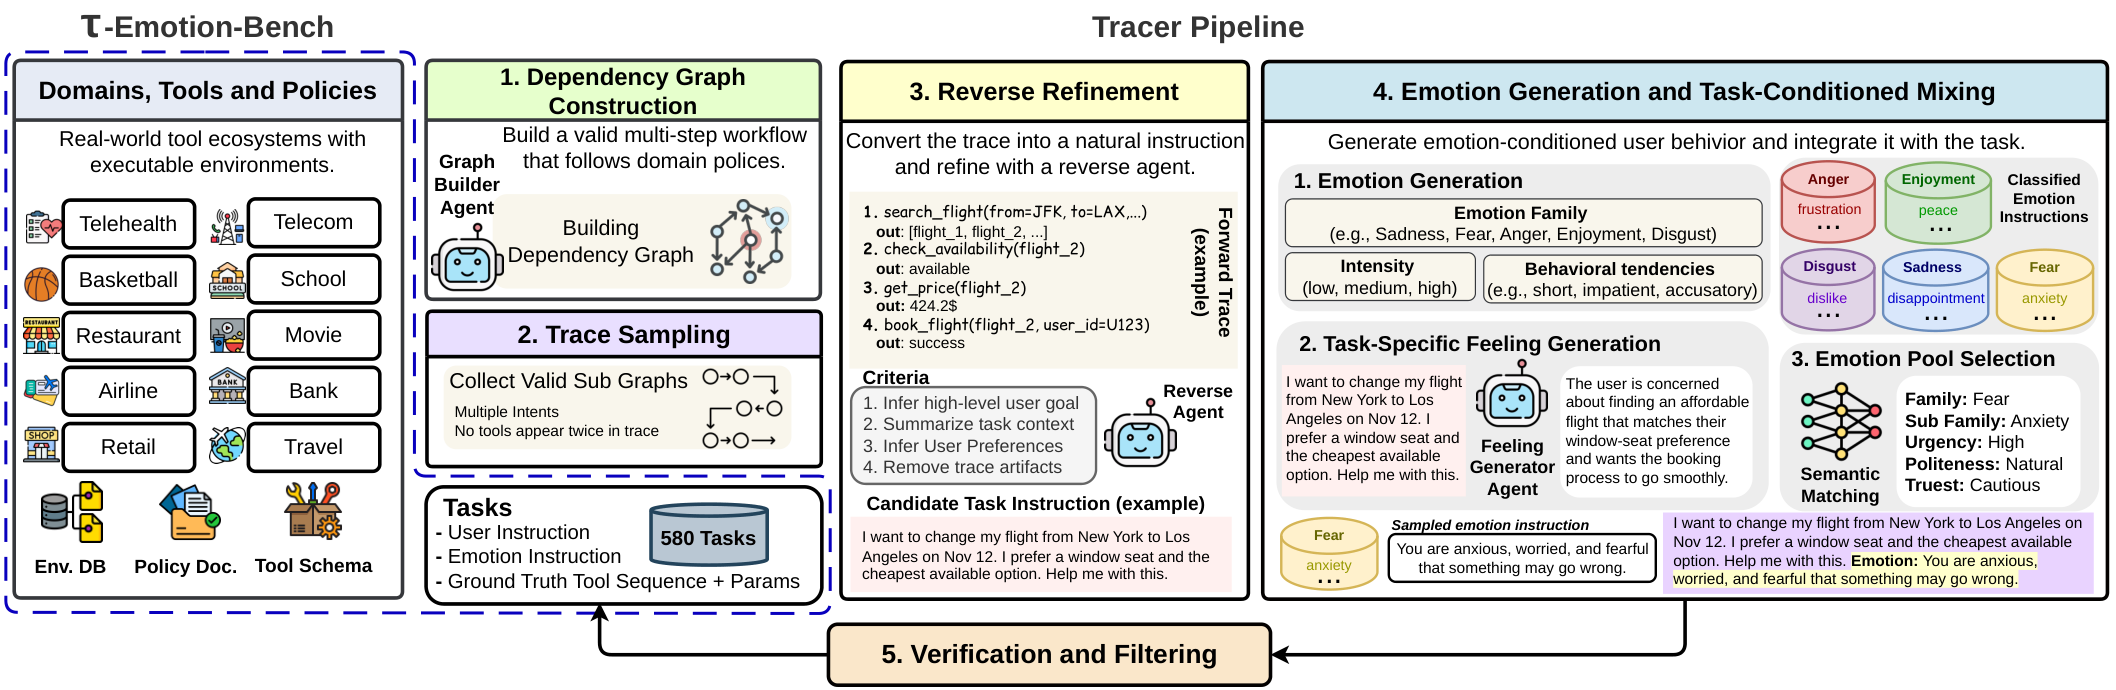
Figure 2 — τ-Emotion-Bench 및 Tracer 개요
실험 결과, τ-Emotion-Bench는 최첨단(frontier) 모델들에게도 여전히 도전적임을 보여주었다. Qwen3-235B-A22B-Instruct-2507 사용자 시뮬레이터 환경에서 DeepSeek-V4.1-Flash는 55.9% Avg@3를 달성했지만, 평균 Pass^3는 32.2%에 그쳐 반복적인 태스크 완료 일관성에서 상당한 격차를 보였다 [Figure 1, cite: 1]. 이는 강력한 에이전트 능력에도 불구하고 감정적으로 변화하는 사용자 상호작용 하에서 신뢰성 있는 행동을 보장하지 못함을 시사한다. 반면, Tracer로 파인-튜닝된 모델들은 모든 Qwen3 스케일에서 일관적이고 상당한 성능 향상을 보였다 [Figure 1, cite: 1]. GLM-5.2 사용자 시뮬레이터를 사용했을 때, Tracer-High는 해당 Qwen3-1.7B, 4B, 8B 모델들의 Avg@3를 17.1–25.2 percentage points 개선했으며, Tracer-High-8B는 54.7%에 도달하여 일부 더 큰 최첨단 모델들보다 우수한 성능을 보였다.
특히, Tracer-Low는 단 1,498개의 궤적으로 4개 도메인에서 훈련되었음에도 불구하고 6개 미시행(unseen) 도메인으로 효과적으로 generalize하며, 비교된 에이전트 훈련 방법론 중 모든 3개 모델 스케일에서 가장 높은 평균 Pass^3를 달성했다 [Table 4, cite: 1]. 또한, Tracer 튜닝을 통해 학습된 행동은 다른 태스크 분포와 사용자 시뮬레이터를 사용하는 τ-Bench 및 τ-Trait와 같은 외부 벤치마크로도 transfer됨을 입증했다 [Figure 3, cite: 1]. 행동 분석에 따르면, 더 높은 태스크 성공률은 툴 실행과 필요한 사용자 후속 조치(follow-up) 사이의 균형과 연관되어 있으며, 정책 위반(policy violations) 및 불필요한 상호작용이 주요 실패 요인으로 작용함을 밝혔다.
4. Conclusion & Impact
본 논문은 감정 조건화된 사용자 상호작용 하에서 툴-콜링 에이전트의 취약성을 드러내는 10개 도메인 벤치마크인 τ-Emotion-Bench를 성공적으로 소개했다. 이 연구는 에이전트가 감정적으로 변화하는 사용자들과 상호작용할 때 상당한 성능 저하와 지속적인 정책 실패가 발생함을 명확히 보여주었다. 또한, 저자들은 감정 조건화된 에이전트-사용자-환경 하네스를 통해 접지된 에이전트 태스크와 훈련 궤적을 생성하는 확장 가능한 접근 방식인 Tracer를 제안했다.
Tracer로 튜닝된 모델들은 기존 에이전트 훈련 방법론보다 훨씬 적은 훈련 데이터를 사용했음에도 불구하고, 인-도메인(in-domain) 및 아웃-오브-도메인(out-of-domain) 평가 모두에서 강력한 성능을 달성했다. 본 연구의 행동 분석은 이러한 성능 향상이 툴 실행과 필요한 사용자 후속 조치 간의 보다 효과적인 균형과 연결되어 있음을 시사한다. 이는 상호작용 인지 신호(interaction-aware signal)를 통해 효율적인 태스크 진행을 장려함으로써 가능하며, 이는 단지 태스크 완료만을 목표로 하지 않는다. 전반적으로, 본 연구 결과는 사용자 행동이 에이전트 신뢰성의 중요한 차원임을 강조하고, 상호작용 인지 데이터 생성이 툴-콜링 에이전트를 위한 효율적이고 전이 가능한 supervision을 제공할 수 있음을 입증한다.
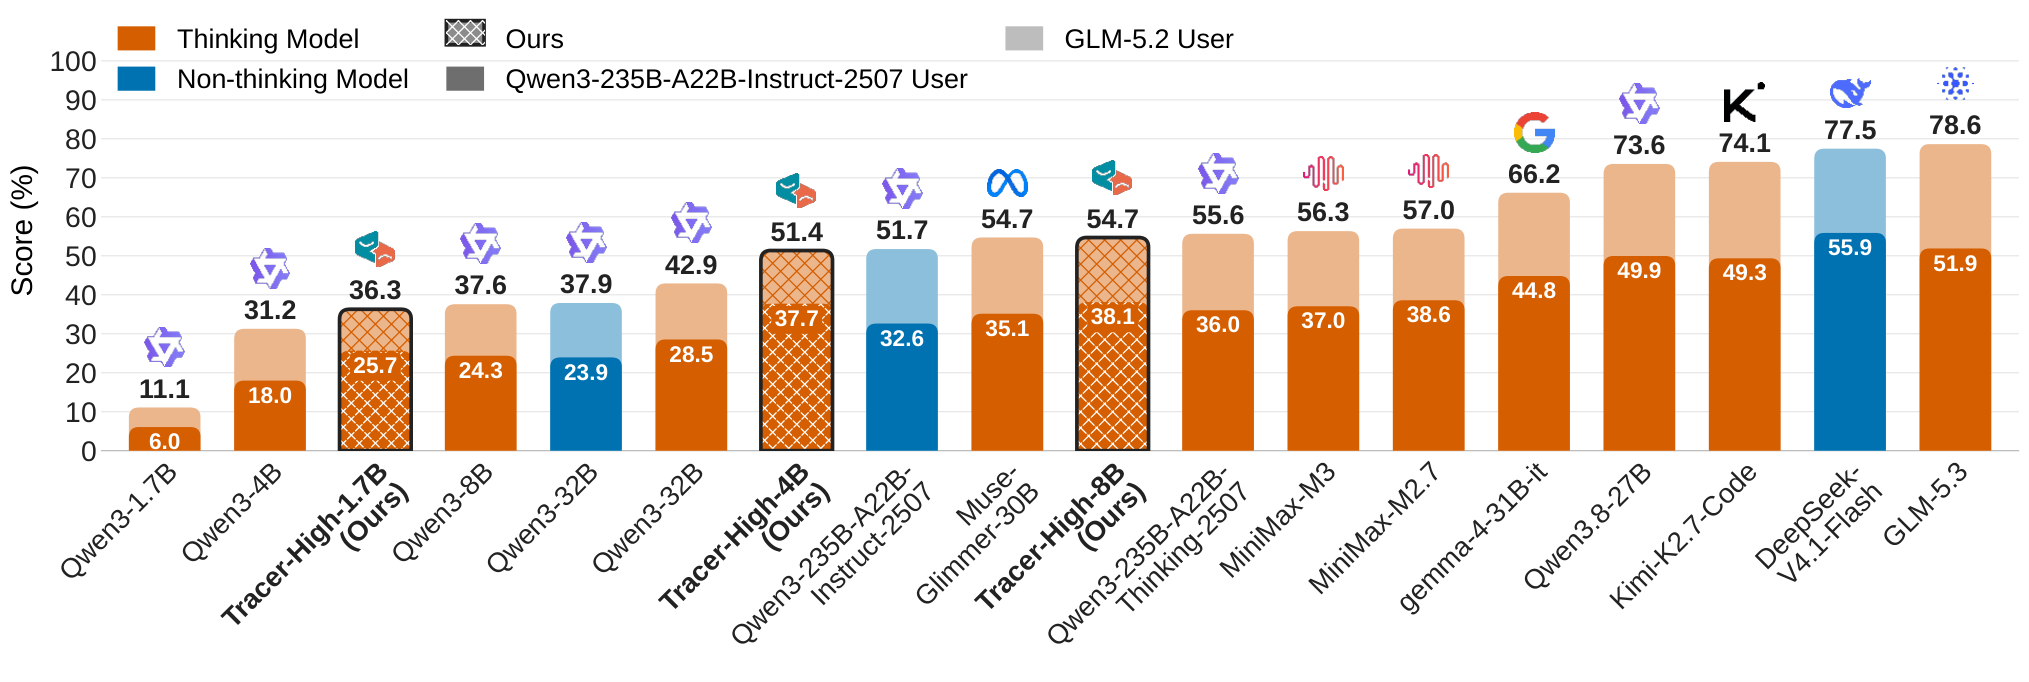
Figure 1 — LLM 에이전트의 평균 정확도
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] BI-Agent and BI-Bench: Towards Automating End-to-End Business Intelligence
- [논문리뷰] SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents
- [논문리뷰] What Makes Good Agentic Data? An ACE Lens on Data Generation for LLM Agents
- [논문리뷰] ToolHazard: Scaling Adversarial Environments for Security Evaluation and Alignment of LLM-based Agents
- [논문리뷰] SecRespond: Benchmarking AI Agents for Real-World Post-Compromise Incident Response
Review 의 다른글
- 이전글 [논문리뷰] What Makes a Social Agent's Interactions Effective? Learning from Verifiable Outcomes in Paired Worlds
- 현재글 : [논문리뷰] τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
- 다음글 [논문리뷰] 3DCodeVerse: Exploring 3D Worlds as Code
댓글