[논문리뷰] Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
링크: 논문 PDF로 바로 열기
저자: Sai Kiran Bathula
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Frozen Table: 훈련 중 업데이트되지 않는 고정된 형태의 임베딩 행렬로, Principal-Component Projection과 Sign Binarisation을 통해 생성됨.
- Ternary Language Model: 가중치를 {-1, 0, +1}의 3진법 값으로 제한하여 연산 효율성과 모델 압축을 극대화한 아키텍처.
- BitLinear: BitNet 모델에서 사용되는 선형 계층으로, RMSNorm과 int8 absmax 활성화, absmean 가중치를 결합하여 Ternary 연산을 수행함.
- Seal: 고정된 임베딩 코드에 토큰의 Unigram 빈도 정보를 결합하여 모델 성능을 보완하는 보조적 메커니즘.
- GGUF: llama.cpp 프로젝트에서 사용하는 모델 파일 형식으로, 모델의 배포 및 효율적인 CPU 추론을 지원함.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 소형 언어 모델(SLM)에서 임베딩 테이블이 전체 파라미터의 대부분을 차지하며 메모리 병목의 주원인이 되는 구조적 문제를 해결하는 것이 본 연구의 목적입니다. 기존 모델들은 파라미터의 다수가 학습 가능한 임베딩 테이블로 구성되어 있어, 모델 본체를 압축하더라도 임베딩 테이블이 16-bit로 유지되어 전체 모델의 저장 공간 및 메모리 점유율을 과도하게 차지합니다. 특히 소형 모델에서는 전체 파라미터의 63% 이상이 임베딩 테이블에 할당되어, 모델 성능 대비 비효율적인 자원 소모가 발생합니다 [Table 1]. 저자들은 학습 가능한 임베딩 테이블이 과연 필수적인지 의문을 제기하며, 이를 고정된 저용량의 Frozen Table로 대체하여 효율성을 극대화하고자 합니다.
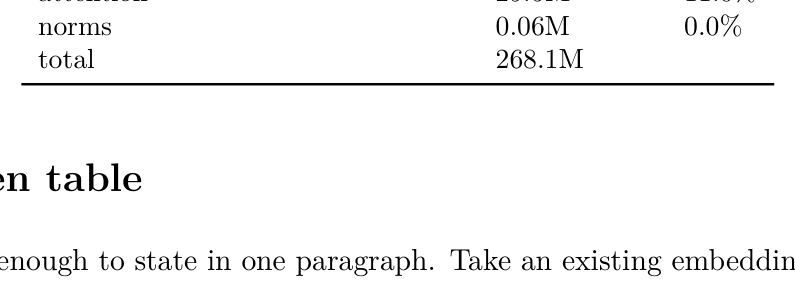
Table 1 — 모델 내 임베딩 테이블이 차지하는 파라미터 비중을 나타내는 핵심 데이터
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 Gemma 3 270M 아키텍처를 기반으로 학습 가능한 임베딩 테이블을 512-bit의 고정된 코드북으로 대체하고, BitNet b1.58의 Ternary 가중치를 적용한 모델을 제안합니다. 제안된 방법론은 기존 학습 가능한 임베딩 행렬을 Principal-Component 분석을 통해 512개의 주요 방향으로 투영하고 이진화(Binarisation)하여 단 16MB의 공간만을 점유하게 합니다. 주요 실험 결과, Frozen Table 기반 모델은 LAMBADA 및 PIQA 벤치마크에서 기존 학습형 임베딩 모델과 대등하거나 우수한 성능을 보였습니다 [Table 2]. 특히 CPU 추론 환경에서 제안 모델은 기존 float 모델 대비 5~6배 빠른 Throughput과 1/7 수준의 메모리 점유율을 달성하였습니다 [Table 5]. 추가적으로, 학습 후 10,000개의 신규 토큰을 추가할 때도 매우 낮은 비용으로 유연한 확장이 가능함을 입증했습니다.
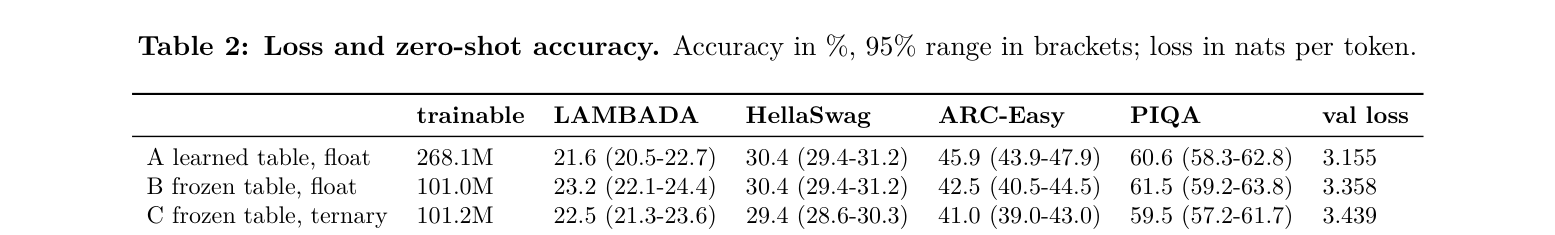
Table 2 — 제안 모델과 기존 모델 간의 벤치마크 성능 및 loss 비교
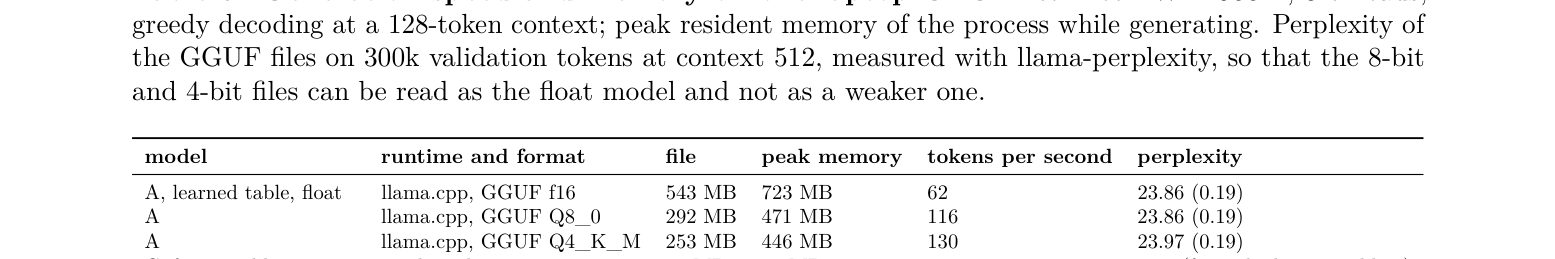
Table 5 — 추론 속도와 메모리 사용량 측면의 효율성을 입증하는 핵심 실험 결과
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 임베딩 테이블의 파라미터가 모델 성능에 미치는 영향이 생각보다 작음을 증명하며, 고정된 임베딩과 Ternary 아키텍처의 결합이 소형 모델의 효율성을 극대화할 수 있음을 보여줍니다. 이러한 접근은 리소스가 제한적인 엣지 디바이스나 모바일 환경에서 거대 모델의 성능을 유지하면서도 가볍고 빠른 추론을 가능하게 하는 핵심적인 전략이 될 것입니다. 저자들은 향후 텍스트, 이미지, 오디오를 통합하는 멀티모달 환경에서도 이와 같은 고정 임베딩 전략을 확장할 수 있을 것으로 전망합니다. 연구 결과는 코드, 가중치, 데이터셋과 함께 공개되어 학계의 투명성과 재현성을 높이는 데 기여하고 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Daedalus-150M: A Convolution-Attention Hybrid Designed for CPU Inference
- [논문리뷰] Resisting Harmful Instructions through Training-Free Weight Editing
- [논문리뷰] Share the Symbol, Not the Vector: Training-Free Fact Communication Across Language Models
- [논문리뷰] Self-Preservation in Language Models
- [논문리뷰] U-Space: Uncovering When and Why Uncertainty Arises in Language Models
Review 의 다른글
- 이전글 [논문리뷰] DuoDiscover: Scaling Autonomous Discovery Beyond the Evaluation Bottleneck
- 현재글 : [논문리뷰] Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
- 다음글 [논문리뷰] Execution Before Memory: Diagnosing Memory Failures in Video World Models
댓글