[논문리뷰] Execution Before Memory: Diagnosing Memory Failures in Video World Models
링크: 논문 PDF로 바로 열기
저자: Weiyang Jin, Jiwen Yu, Sihan Xu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Video World Models: 비디오 시뮬레이션 및 상호작용 환경을 생성하는 대규모 비디오 생성 모델.
- MIST (Memory test separating scene setup from delayed state reveal): 비디오 월드 모델의 메모리 테스트에서, 장면 설정(scene setup), 숨겨진 변화의 노출 여부(leakage), 최종 프레임의 결과 일치(reveal)를 분리하여 평가하는 프레임워크.
- M3-Agent (Make the Missing Move): 모델이 요청된 명령을 성공적으로 수행하도록 입력 지침의 세부 사항을 재귀적으로 수정하는 test-time 에이전트.
- WRBench: 카메라가 시야를 벗어났다가 돌아온 후 객체의 관계 지속 여부와 액션 업데이트를 평가하는 벤치마크.
- MBench-T: WRBench와 유사하게 카메라가 시야를 벗어났다가 돌아온 후 객체의 상태 변화를 평가하는 벤치마크.
- Execution Failure: 모델이 명령된 변화나 액션을 수행하지 못하여 최종 상태가 나타나지 않는 경우.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 비디오 월드 모델의 메모리 테스트가 핵심 문제를 정확히 진단하지 못하는 한계를 지적한다. 현재의 테스트 방식은 장면 설정(scene setup), 변화 수행(change execution), 최종 프레임 결과 일치(last frame match) 등 여러 평가 요소를 단일 점수로 통합하여, 낮은 점수가 단순한 "망각(forgetting)"으로 잘못 해석될 수 있다. 이러한 통합된 스코어는 장면이 제대로 설정되었는지, 요청된 변화가 실제로 수행되었는지, 또는 마지막 프레임이 그 결과를 보여주는지 여부를 구분하지 못한다. 특히, 모델이 명령된 변화를 실행하지 않을 경우, 숨겨진 상태 전환(hidden state transition)이 나타날 수 없어 실제 메모리 테스트가 불가능해지는 문제점이 발생한다. 기존 벤치마크인 WRBench와 MBench-T의 실패 사례를 분석한 결과, 카메라가 시야를 벗어나기 전에 객체가 움직임을 완료하지 않거나, 카메라가 돌아온 후에도 객체가 여전히 온전한 상태로 남아있는 Execution Failure가 빈번하게 관찰되었다 [Figure 2].
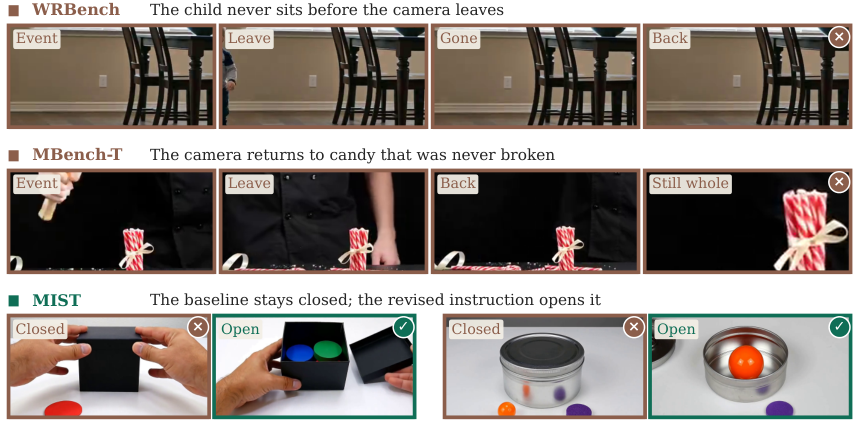
Figure 2 — 기존 모델의 실행 실패 사례
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 비디오 월드 모델의 메모리 테스트에서 Execution Failure와 실제 메모리 실패를 분리하기 위해 MIST라는 새로운 평가 프레임워크를 제안한다. MIST는 모델이 먼저 장면을 설정(scene setup)하고 변화(change)는 숨겨진 상태로 유지하다가, 나중에 해당 변화를 보여주도록 요청하는 3단계(Setup, Leak, Reveal) 평가 방식을 사용한다 [Figure 3]. 이 프레임워크는 모델이 장면을 설정하지만 지시된 변화를 수행하지 못하는 Execution Failure가 병목 현상임을 진단한다. 이러한 진단을 기반으로, 저자들은 M3-Agent (Make the Missing Move)를 제안한다. M3-Agent는 동일한 frozen model에서 입력 지시(input instruction)의 세부 사항을 재귀적으로 수정하여 모델이 요청된 지시를 성공적으로 수행하도록 돕는 test-time workflow이다 [Figure 3]. 이 방법론은 메모리 모듈을 추가하거나 모델을 재훈련하지 않고도 실행(execution) 측면에서 문제에 접근한다.
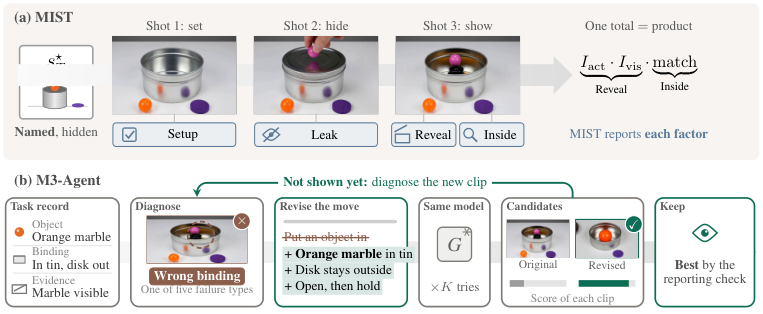
Figure 3 — MIST 평가 및 M3-Agent 워크플로우
주요 실험 결과로, M3-Agent는 baseline 대비 Internal MIST reveal score를 0.147에서 0.492로 세 배 이상 (+0.344) 크게 향상시켰다. 또한, 공식 벤치마크인 WRBench에서 score TT가 26.1% (0.452 → 0.570) 상승했으며, MBench-T에서는 score UU가 52.7% (0.292 → 0.446) 상승했다. 이러한 성능 향상은 주로 누락된 움직임(missing move)을 재지정하는 지시 수정을 통해 달성되었으며, 이는 비디오 월드 모델의 실제 역량을 더 정확하게 드러낸다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 비디오 월드 모델의 메모리 평가에 있어 Execution Failure와 실제 메모리 실패를 명확히 구분하는 MIST 프레임워크와 M3-Agent 방법론을 제안한다. 연구 결과, 모델이 장면을 설정하고 정보 유출 없이 중간 상태를 유지할 수 있지만, 지시된 변화를 실행하지 못하는 경우가 빈번하여 기존의 단일 점수 방식으로는 메모리 문제를 정확히 진단하기 어렵다는 것을 밝혀냈다. M3-Agent는 test-time에 입력 지시를 수정함으로써, 동일한 frozen model이 누락된 변화를 실행하도록 유도하여 MIST 및 공식 벤치마크 점수를 크게 향상시키는 효과를 입증했다. 이 연구는 비디오 월드 모델의 "기억 상실"이 종종 "실행 실패"에서 비롯됨을 진단하며, 향후 메모리 평가는 각 구성 요소(장면 설정, 변화 수행, 결과 표시)를 분리하여 보고해야 함을 강조한다. 이는 모델의 실제 역량을 더 정확하게 이해하고, 개선 방향을 제시하는 데 중요한 시사점을 제공한다.
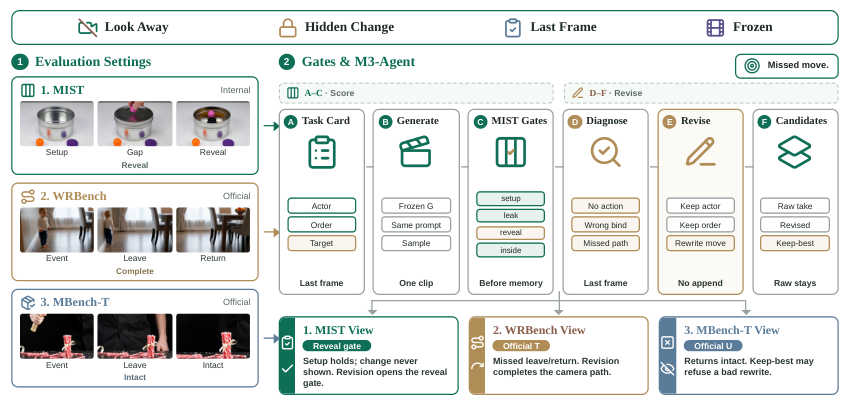
Figure 1 — 제안 방법론 및 문제 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Xiaomi-Lens-0 Technical Report
- [논문리뷰] Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
- [논문리뷰] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
- [논문리뷰] Stuck on Shuffle: On Attribute-Object Binding in Vision-Language Models
Review 의 다른글
- 이전글 [논문리뷰] Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
- 현재글 : [논문리뷰] Execution Before Memory: Diagnosing Memory Failures in Video World Models
- 다음글 [논문리뷰] FC-SWE: Failure-Conditioned RL for Long-Horizon Software Engineering Agents
댓글