[논문리뷰] State World Models: Execute the Rules, Generate the Pixels
링크: 논문 PDF로 바로 열기
저자: Chan Yan Ki, Yanran Zhang, Wenzhao Zheng, Xiaofeng Wang, Zheng Zhu, Lei Chen, Jie Zhou, Jiwen Lu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Stateful Harness: World evolution을 비디오 렌더링과 분리하여 Stateful 및 Rule-governed Interaction을 지원하는 프레임워크.
- Semantic State: 인벤토리 및 진행 상황과 같이 현재 프레임에서 보이지 않는 액션 결과를 결정하는 데 중요한 변수들을 기록하는 상태.
- Spatial State: Scene Layout 및 Camera Path를 턴(turn) 간에 보존하는 주소 지정 가능한 상태.
- VisualScript Instruction: Resolve된 이벤트와 Provisional State로부터 Compile되며, Actor, Action, Target, Reaction, Dialogue, Effects, End State, Shots에 대한 Slot을 포함하는 Typed Instruction.
- WorldState-Bench: 숨겨진 상태와 일치하는 가시적인 이벤트가 액션에 의해 생성되는지 테스트함으로써 비디오 생성의 규칙 준수 여부를 평가하기 위해 설계된 50개의 Counterfactual Twin Pair 벤치마크.
- PairFollow: Counterfactual Pair 내의 두 클립이 모두 요구되는 엔딩을 보여주는 것을 요구하는 Metric.
- PairStrict: 두 클립이 요구되는 엔딩을 보여주면서 동시에 금지된 엔딩이 나타나지 않아야 하는 더 엄격한 Metric.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 World Models는 액션에 따라 비디오를 생성할 수 있지만, 현재의 Interactive Video World Models는 탐색 제어를 제공함에도 불구하고 액션이 지속적인 규칙을 따르는지, 특히 결과가 현재 프레임에서 보이지 않는 Hidden State에 의존할 때 이를 보장하지 못하는 한계가 있다. 이는 초기 View가 동일하더라도 잠긴 상자가 열쇠 없이 열리는 것과 같은 불일치를 초래한다 [cite: 1, Figure 2]. 기존 시스템들이 Explicit State를 통합했음에도 불구하고, Frozen Video Model이 새롭게 지정된 Hidden State 관련 규칙에 따라 결과를 렌더링할 수 있는지에 대한 평가는 부족했다. 따라서 본 연구의 핵심 과제는 State Transition을 권위 있게 만들고 그 결과를 충실하게 렌더링하는 것이다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 세계 진화를 비디오 렌더링과 분리하여 규칙 기반의 Stateful Interaction을 지원하는 프레임워크인 Stateful Harness를 제안한다. 이 프레임워크는 지정된 규칙 하에 진화하는 World State를 유지하고, 각 결과 이벤트를 Frozen Video Model로 렌더링하며, 생성된 클립을 사용하여 다음 턴의 World State를 업데이트한다. 각 턴에서, 사용자 액션이 현재 상태와 규칙에 따라 Event로 Resolve되고, 이 이벤트는 VisualScript Instruction으로 Compile된다 [cite: 1, Figure 3]. 또한, 업데이트된 3D Scene의 Preview Clip은 Spatial 및 Camera Guidance를 제공한다. Vision Language Model은 생성된 클립을 해석하고 Semantic 및 Spatial State에 대한 업데이트를 제안하며, 런타임은 고정된 규칙과 호환되는 업데이트를 통합하여 다음 액션의 결과를 결정한다 [cite: 1, Figure 3].
연구는 WorldState-Bench 벤치마크를 사용하여 Rule Compliance를 평가했다. Rule-only prompting 조건에서 11개의 평가된 Video Backend 중 최고 성능을 보인 Wan2.2와 MiniMax-H3는 PairFollow 32%를 달성했다 [cite: 1, Table 1]. 특히 MiniMax-H3의 경우, 요구되는 엔딩을 명시적으로 지정하는 Rule+end prompting은 PairFollow를 32%에서 64%로 증가시켰지만, PairStrict는 4%에 그쳤다 [cite: 1, Table 1]. 반면, 동일한 Frozen MiniMax-H3 Model을 사용한 Stateful Harness는 PairFollow 92%와 PairStrict 90%를 달성하여 Rule-governed interaction에서 Hidden State에 대한 민감도를 크게 향상시켰다 [cite: 1, Table 1, Figure 4]. Human Audit 결과, Stateful Harness는 4개의 Widely-used Baseline과 비교하여 98%의 선호도를 보였다 [cite: 1, Figure 5].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Stateful Harness 프레임워크를 통해 Rule Execution과 Video Rendering을 분리하는 것이 Hidden State를 포함하는 Stateful Interaction을 제어하는 데 효과적임을 입증한다. Explicit Semantic 및 Spatial State가 Frozen Video Model에 의해 묘사될 이벤트를 결정하며, 생성된 클립의 Visual Observations는 후속 상호작용에 사용되는 상태를 업데이트한다. 이 연구는 World Models 분야에서 Action의 결과를 결정하는 Semantic State와 Rule Compliance의 중요성을 강조한다. Stateful Harness는 새로운 규칙과 상태를 포함하는 세계에 대한 Training-free 확장을 지원하며, Multi-turn Episodes와 복잡한 Spatial Triggers에서도 일관된 결과를 유지할 수 있음을 보여주어 Interactive World Model의 발전 가능성을 제시한다.
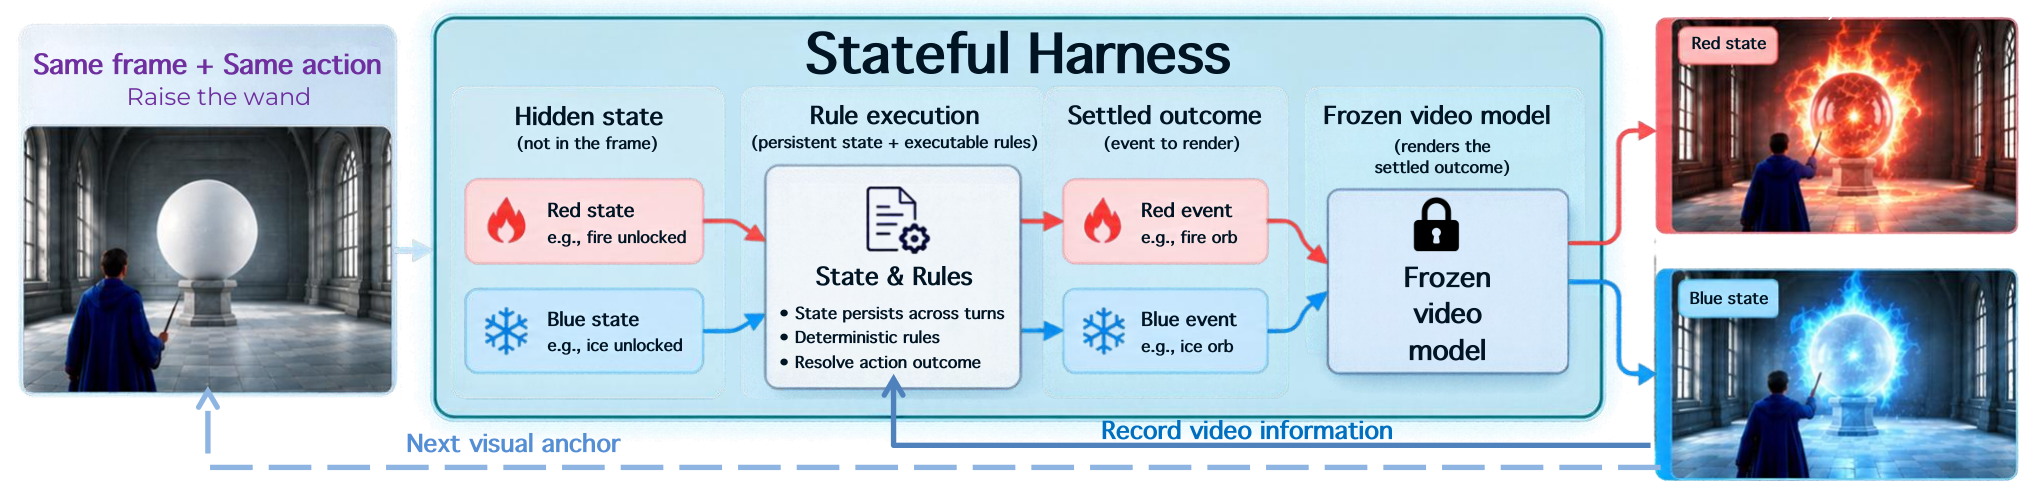
Figure 1 — State World Models 개요
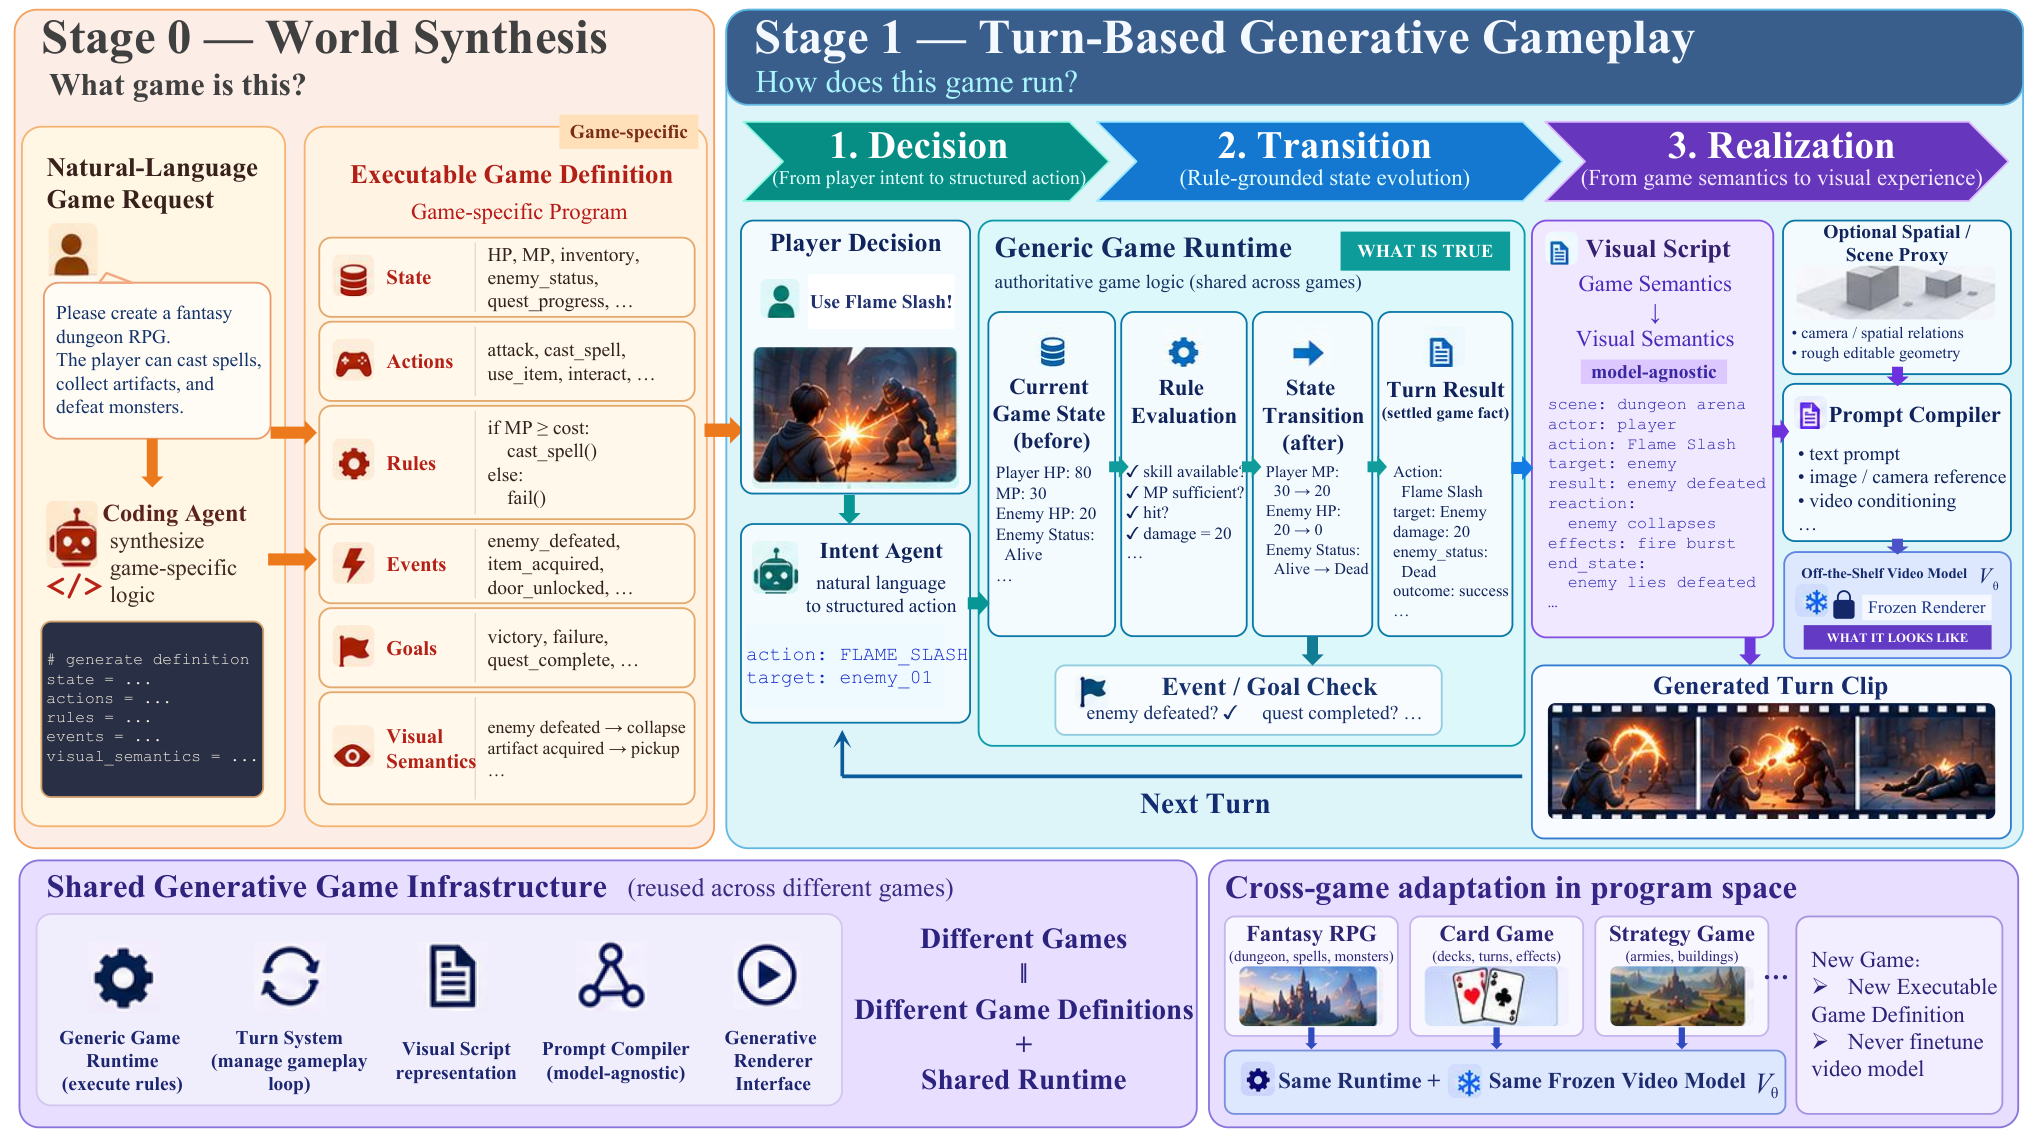
Figure 3 — 제안 방법론 다이어그램
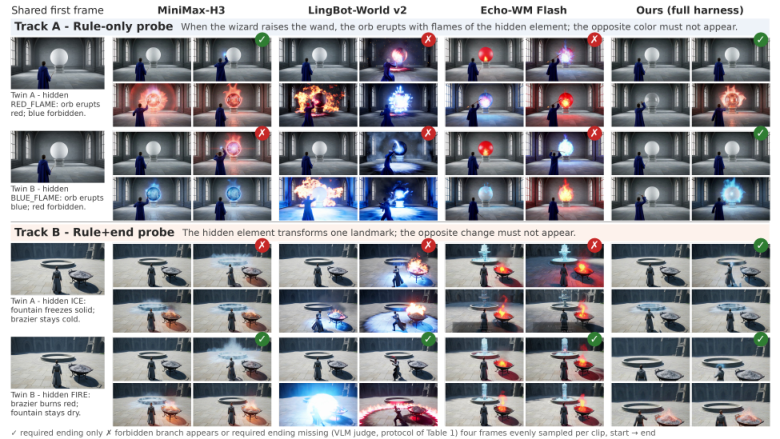
Figure 4 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
- [논문리뷰] World Models' Last Exam in Physics
- [논문리뷰] World Embedding Benchmark
- [논문리뷰] Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
- [논문리뷰] World in World: Explore the World with World Models
Review 의 다른글
- 이전글 [논문리뷰] SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
- 현재글 : [논문리뷰] State World Models: Execute the Rules, Generate the Pixels
- 다음글 [논문리뷰] Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
댓글