[논문리뷰] Game2Real-Bench: Do Toy Games Reveal and Transfer to Real-World Visual Reasoning?
링크: 논문 PDF로 바로 열기
저자: Qingan Liu, Juntong Feng, Yue Zhu, et al.
1. Key Terms & Definitions
본 논문에서 제안하는 핵심 용어 및 기술적 개념은 다음과 같다.
- Game2Real-Bench: 토이 게임(toy games)과 실제 환경(real-world)의 Visual Reasoning 능력 간의 관계를 연구하기 위해 Fine-grained Perception, Spatial Reasoning, Constraint Reasoning, Sequential Planning의 네 가지 능력 그룹에 걸쳐 구축된 벤치마크이다.
- Game2Real-Dataset: Game2Real-Bench와는 별개로, Visual Reasoning 평가 및 학습을 지원하기 위해 18개 토이 게임 태스크와 65개 QA Families에 걸쳐 약 24K개의 프로그램적으로 검증된 게임 샘플로 구성된 데이터셋이다.
- Fine-grained Perception: 미묘한 국소적 차이(subtle local differences), 대응 관계(correspondences), 부분적 관찰(partial observations)로부터 태스크 관련 시각적 증거(visual evidence)를 식별해야 하는 모델의 능력을 요구한다.
- Spatial Reasoning: 관계, 방향(orientation), 시점(viewpoint), 기하학(geometry), 3D 구조를 포함하는 공간적 구성(spatial configurations)을 추론하고 변환해야 하는 모델의 능력을 요구한다.
- Constraint Reasoning: 여러 상호 의존적인 관계 및 제약 조건(interdependent relations and constraints)을 통합하여 전역적으로 일관된 해법(globally consistent solution)을 도출해야 하는 모델의 능력을 요구한다.
- Sequential Planning: 상태 전이(state transitions)를 추론하고, 목표를 향해 상태 의존적 행동(state-dependent actions)을 선택해야 하는 모델의 능력을 요구한다.
2. Motivation & Problem Statement
본 논문은 토이 게임에서 측정된 Visual Reasoning 능력이 실제 환경의 요구 사항과 어떻게 일치하는지, 그리고 게임 예시가 실제 태스크 해결에 유용한 신호를 제공할 수 있는지에 대한 근본적인 질문에 답하고자 한다. 기존 평가들은 실제 데이터(real-world data) 또는 절차적으로 생성된 태스크(procedurally generated tasks)에 주로 의존해왔다. 실제 데이터는 자연스러운 장면의 복잡성을 보존하지만, 통제된 생성과 검증 가능한 해법을 제공하기 어렵다. 반면, 절차적 게임은 대규모 생성이 가능하고 프로그램적으로 해답을 검증할 수 있지만, 단순화된 시각 환경으로 인해 실제 환경으로의 일반화 가능성이 불분명하다는 한계가 있다. 이러한 한계점들을 극복하고 게임 기반 평가와 실제 환경 추론 간의 관계를 명시적으로 탐구하기 위해, 추론 요구 사항에 따라 태스크를 연결하는 공유된 평가 프레임워크의 필요성이 제기된다.
3. Method & Key Results
저자들은 토이 게임과 실제 환경 Visual Reasoning을 네 가지 핵심 능력(Fine-grained Perception, Spatial Reasoning, Constraint Reasoning, Sequential Planning)에 걸쳐 연결하는 벤치마크인 Game2Real-Bench를 제안한다. 이 방법론은 세 가지 주요 단계를 통해 구축된다. 첫째, Task Design 단계에서는 네 가지 능력 그룹을 중심으로 18개의 토이 게임 태스크와 65개의 QA Families를 설계한다. 둘째, Procedural Generation 단계에서는 실행 가능한 생성기(executable generators)와 태스크별 검증기(task-specific verifiers)를 개발하여 Game2Real-Dataset(약 23,893개의 검증된 게임 샘플)과 토이 게임 평가 세트(1,000개 샘플)를 구축한다. 셋째, Real-World Curation 단계에서는 시각적 유사성보다는 공유된 추론 요구 사항에 따라 400개의 실제 환경 샘플을 큐레이션한다. 이러한 다단계 구축 파이프라인은 [Figure 1]에서 확인할 수 있다.
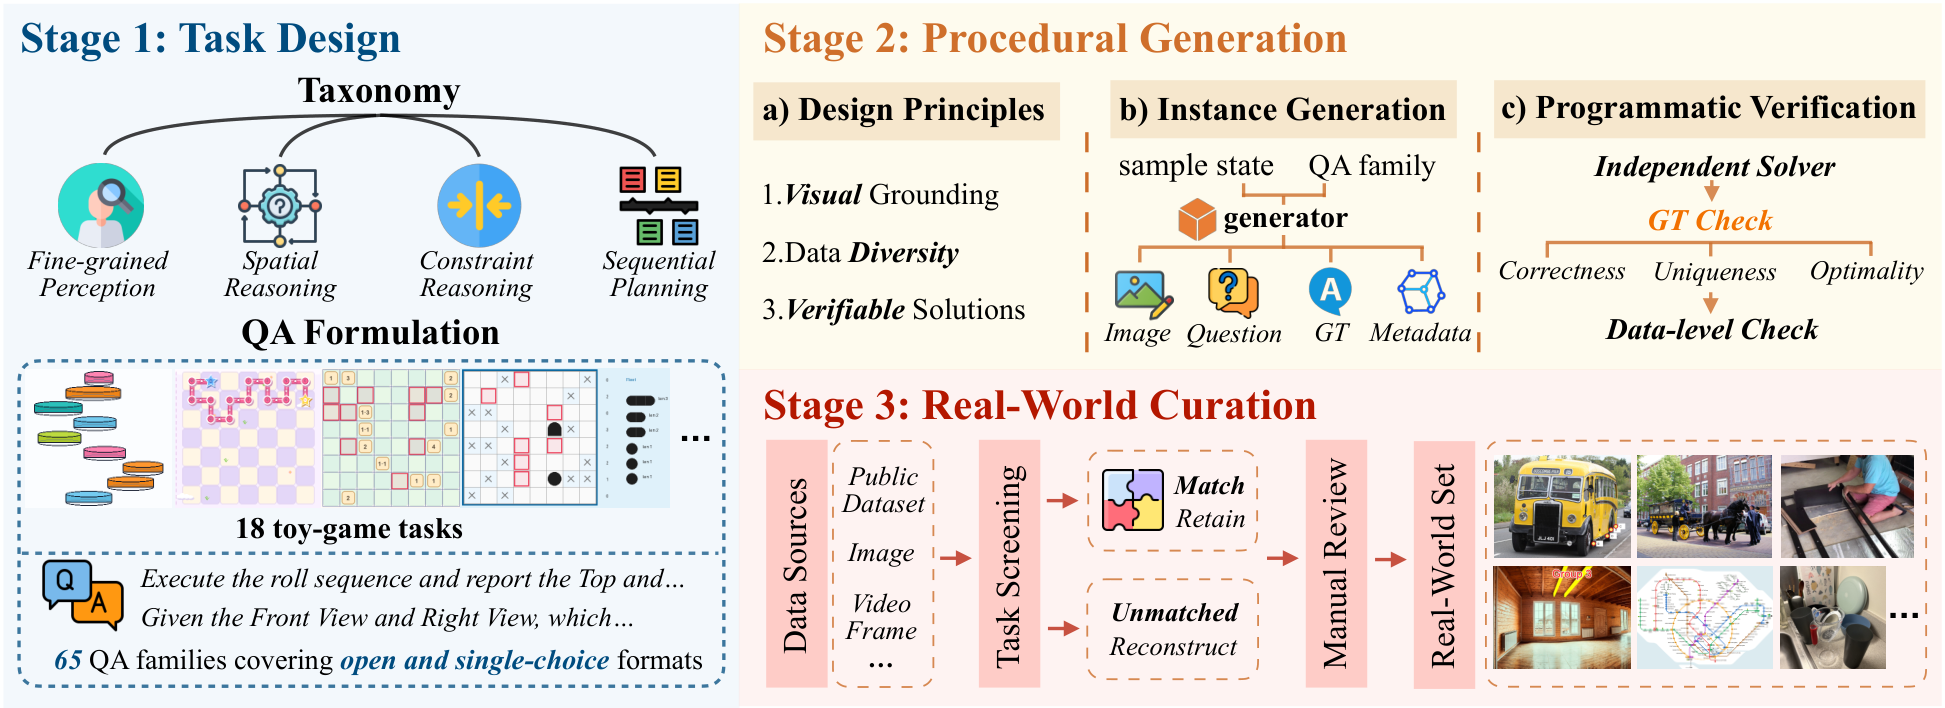
Figure 1 — 제안 모델의 전체 아키텍처
25개의 대표적인 VLM에 대한 평가 결과는 다음과 같다.
- 토이 게임과 실제 환경 태스크 간의 성능은 강력한 교차 설정 일관성(cross-setting consistency)을 보이며, 모델 수준 Pearson 상관관계 0.935 및 Spearman 상관관계 0.935를 기록했다. 이는 [Figure 4]에서 시각적으로 확인 가능하다.
- 토이 게임 태스크는 일반적으로 더 어려웠으며, 모델 간의 성능을 더 명확하게 구분하는 역할을 했다. 예를 들어, Fine-grained Perception에서 최고 성능의 상용 모델과 오픈-소스 모델 간의 차이는 토이 게임 세트에서 16.3%였으나, 실제 환경 세트에서는 이 차이가 훨씬 적었다.
- One-shot In-Context Learning을 통한 게임-실제 전이(game-to-real transfer) 연구에서는 선택적인 전이 효과를 보였다. Constraint Reasoning은 여러 모델에서 평균 4.89 포인트의 긍정적인 성능 향상을 보인 반면, Fine-grained Perception은 게임 데모를 통해 모든 모델에서 평균 4.92 포인트의 일관된 성능 하락을 보였다. 이는 [Figure 3]에서 나타난다.
- Thinking Mode를 활성화했을 때, 모든 4개 모델에서 전반적인 점수가 향상되었으며, 특히 대규모 모델(large models)인 GPT-5.6-Sol은 28.3%에서 69.8%로 41.5% 포인트의 큰 향상을 보였다.
4. Conclusion & Impact
본 연구는 통제된 토이 게임 태스크와 실제 환경 Visual Reasoning 태스크를 짝지어, 토이 게임에서 드러난 능력이 실제 환경 성능에 반영되는지, 그리고 설정 간에 전이될 수 있는지 탐구하기 위한 Game2Real-Bench를 제시한다. 25개 VLM에 대한 광범위한 평가를 통해, 토이 게임과 실제 환경 성능 사이에 강한 상관관계가 있음을 발견했으며, 토이 게임 태스크가 현재 모델들을 더 잘 구분할 수 있는 더 도전적인 환경을 제공함을 입증했다. 또한, One-shot In-Context Learning은 선택적인 전이 효과를 보여주는데, Constraint Reasoning은 긍정적인 영향을 받는 반면, Fine-grained Perception은 오히려 성능이 저하되는 현상을 관찰했다. 이러한 결과는 토이 게임이 실제 환경 Visual Reasoning 능력을 탐구하는 데 유용한 설정임을 시사하며, Game2Real-Bench와 Game2Real-Dataset은 Visual Reasoning의 게임-실제 전이 연구를 발전시키기 위한 검증 가능한 평가 프레임워크와 확장 가능한 데이터 리소스를 제공한다.
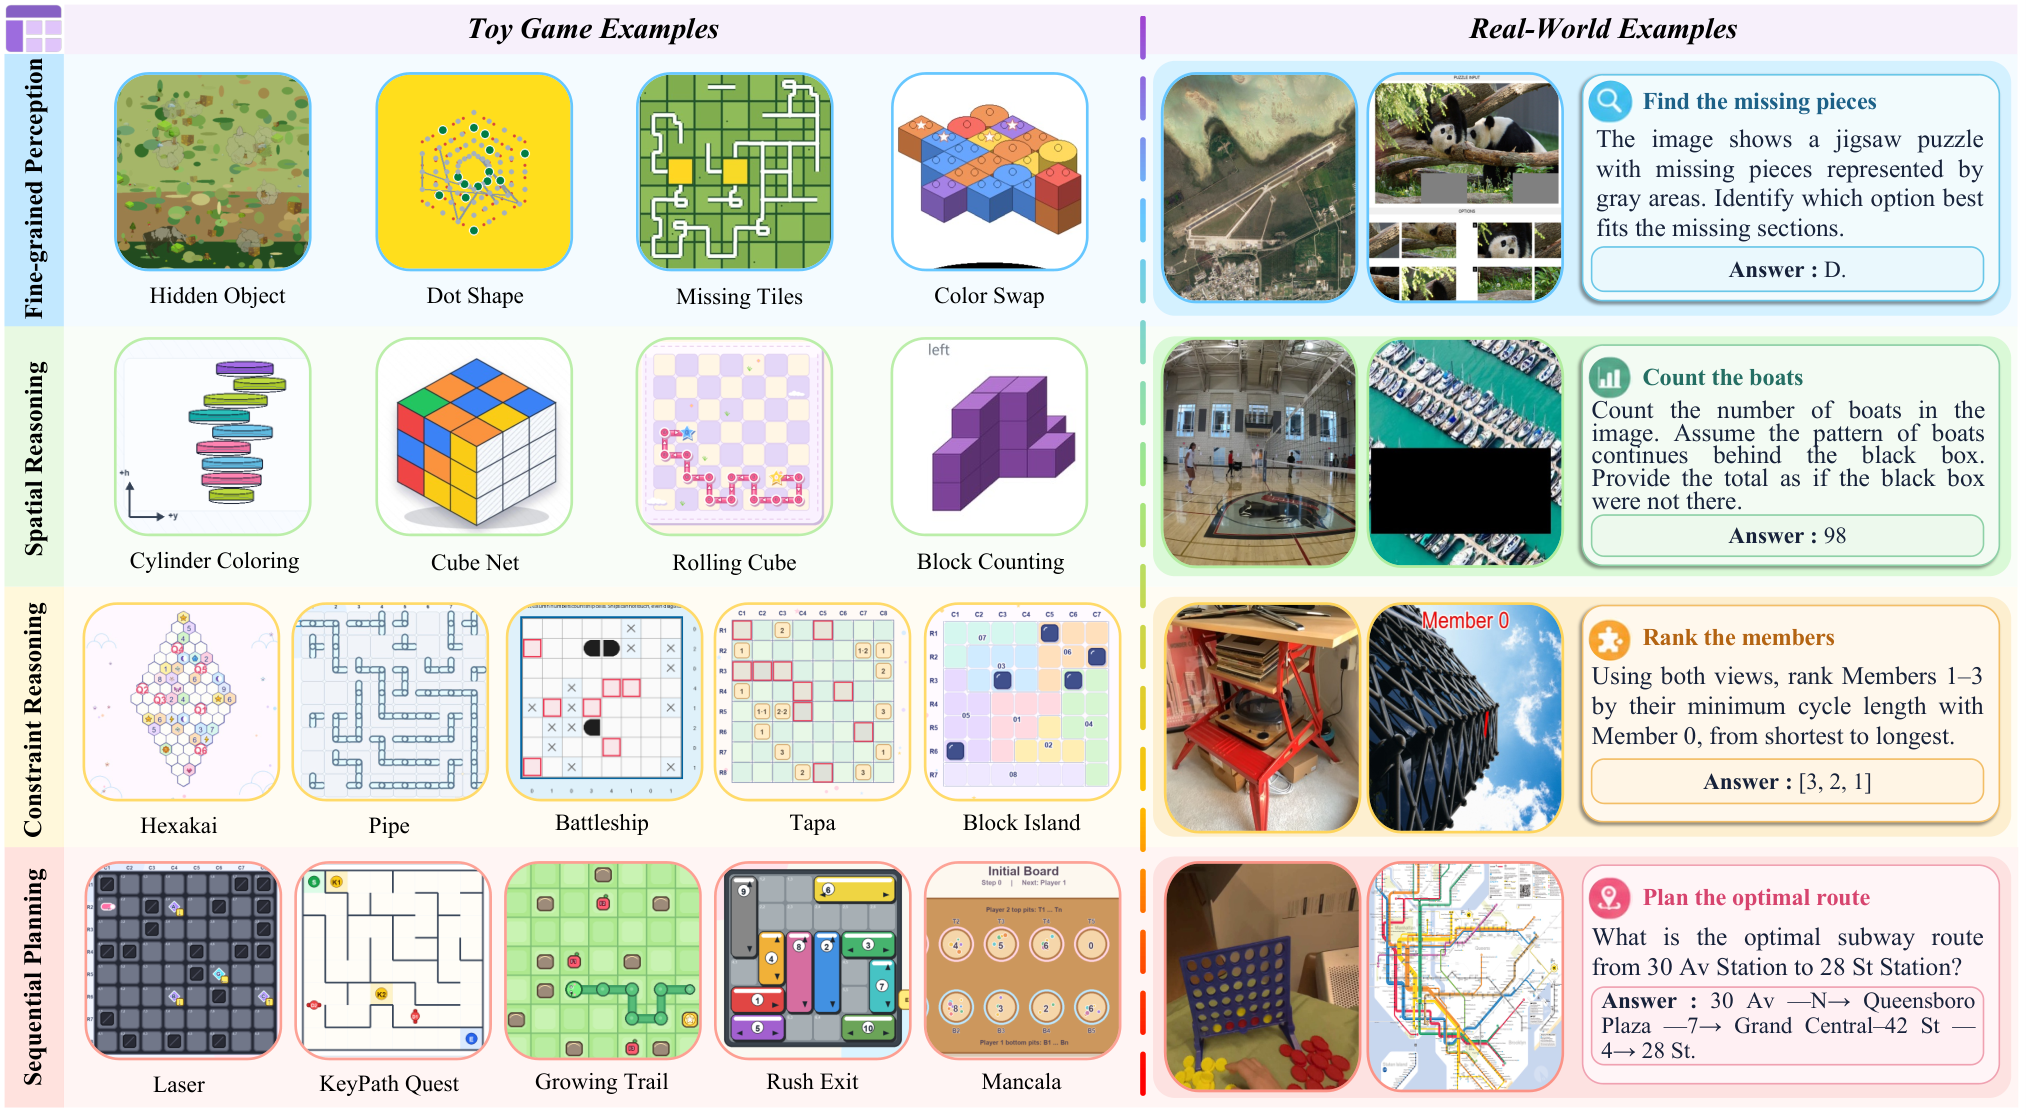
Figure 2 — 역량별 정렬된 태스크 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CaRGo-T: Causal Reasoning Graph-of-Thought improves Multimodal Humor Comprehension
- [논문리뷰] Trace: A Taxonomy-Guided Environment for Multidomain Visual Reasoning
- [논문리뷰] AnyGroundBench: A Specialized-Domain Benchmark for Video Grounding in Vision-Language Models
- [논문리뷰] 3DCodeBench: Benchmarking Agentic Procedural 3D Modeling Via Code
- [논문리뷰] Chartographer: Counterfactual Chart Generation for Evaluating Vision-Language Models
Review 의 다른글
- 이전글 [논문리뷰] From Research Goals to Scientific Closure: Evaluating Agents Through Evidence-Supported Physics Research
- 현재글 : [논문리뷰] Game2Real-Bench: Do Toy Games Reveal and Transfer to Real-World Visual Reasoning?
- 다음글 [논문리뷰] Has GPT-6-Astra Achieved Embodied Intelligence?
댓글