[논문리뷰] LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
링크: 논문 PDF로 바로 열기
저자: Jun Zhao, Leiming Fu, Yanbo Wen, Yiding Wang, Xuantong Liu, Yang Shu, Yuyang Lu, Xuanran Xing, Jingqi Tong, Hao Xu, Qi Zhang, Xuanjing Huang et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 제안하는 LiveMACEBench는 LLM Agent의 Capability를 Process-Aware하게 평가하기 위한 핵심 벤치마크이다.
- LiveMACEBench:
Persistent LLM Agent를Naturally Evolving Environment, 특히Live Financial Markets에서 평가하기 위한Process-Aware Benchmark. - Outcome–Capability Gap:
Agent의Realized Outcome(예:Return)과 해당Outcome을 생성하는Underlying Capability또는Mechanism간의 불일치. - Process Diagnostics:
Agent의Mechanism(도구, 메모리, 규칙, 협업)이 어떻게 사용되는지를Complete Decision Traces로부터 도출하여 특성화하는Mechanism-Specific Measurement. - ReAct Scaffold:
LLM Agent가Reasoning과Acting을Synergize하도록 설계된Common Interaction Framework. - Hierarchical Trading Rules (R0, R1, R2):
Rule Following Configuration에서 사용되는Structured Financial Policy로,System Hard Constraints(R0),Client Hard Policies(R1),Client Soft Preferences(R2)로 계층화되어 있다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Agent의 Performance를 Outcome만으로 평가하는 방식이 Agent의 실제 Capability를 가릴 수 있다는 문제를 제기한다. 특히 Evolving Environment에서는 Agent Behavior와 Changing External Conditions 간의 Closed-Loop Interaction이 Outcome에 복합적으로 영향을 미치므로, Outcome만으로는 Capability를 정확히 진단하기 어렵다. 기존의 Agent Benchmark들은 Long-Horizon 및 Dynamic Interaction으로 발전해왔지만, Environment의 Evolution이 Task-Scripted되지 않은 Real-World 환경에서의 Capability Evaluation은 여전히 도전 과제로 남아 있다. Live Financial Markets는 이러한 Evolving Environment의 자연스러운 Testbed를 제공하지만, 이전 연구들은 주로 Trading Outcome에 초점을 맞추어 Agent의 Process-Level Capability를 진단하는 데 한계가 있었다. 저자들은 Mechanism Access, Effective Mechanism Use, 그리고 Realized Task Benefit을 구분하여 Agent Capability를 보다 Fine-Grained하게 평가할 필요성을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 LLM Agent의 Capability를 Process-Aware하게 평가하기 위해 LiveMACEBench 벤치마크를 제안한다. LiveMACEBench는 Live Cryptocurrency 및 U.S. Equity Markets를 Naturally Evolving Environment로 활용하여 Persistent LLM Agent들을 Continuous Paper-Trading Trajectories 상에서 평가한다. 다섯 가지 Frontier LLM (GPT-5.4, DeepSeek-V3.2, Gemini-3.1-Pro, Grok-4.20, Qwen3-Max)이 Common ReAct Scaffold를 기반으로 Base, Tool Use, Persistent Memory, Rule Following, Multi-Agent Collaboration Configuration으로 30일간 평가되었다. 평가는 Task Outcome, Controlled Mechanism Effects, 그리고 Complete Decision Traces에서 도출된 Process Diagnostics의 세 가지 Complementary Signal을 통해 이루어진다. 이 설계는 Agentic Mechanism에 대한 Access, Mechanism의 Effective Use, 그리고 Realized Task Benefit이라는 세 가지 Quantity를 분리한다.
주요 결과로, 30일간의 Live Evaluation에서 Pronounced Outcome–Capability Gap이 발견되었다. Realized Returns는 시간 경과에 따라 Ranking이 크게 변동하고 Capability-Specific Measurement와 종종 Diverge하며, 유사한 Outcome이 현저히 다른 Mechanism Use Pattern에서 발생할 수 있음을 보여준다. 예를 들어, Tool Use Configuration에서 Grok-4.20은 가장 높은 Return을 달성했지만 가장 낮은 Tool Call Score (TCS)를 기록했고, DeepSeek-V3.2는 Rule-Condition Return에서 선두였으나 Gemini-3.1-Pro가 가장 높은 Rule Satisfaction Score (RSS)를 보였다. 이는 Scalar Return Measure가 가릴 수 있는 Heterogeneous Agent Strengths를 드러낸다. [Figure 2]
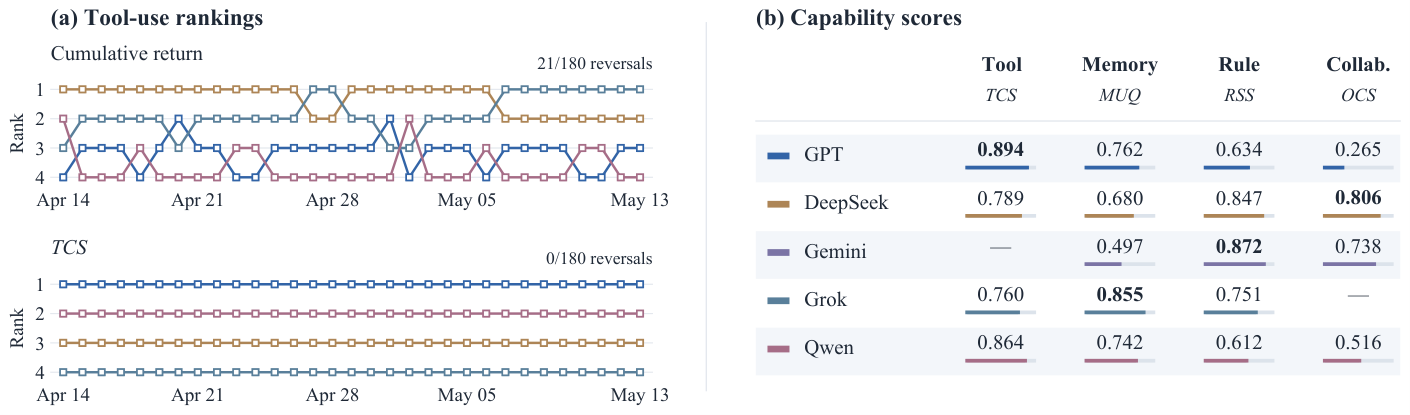
Figure 2 — 통합 역량 평가 결과
Trace-Level Diagnostics는 각 Capability별 Distinct Bottlenecks를 노출한다.
- Tool Use:
High Information Coverage (IC)(0.809–0.911)에도 불구하고Invocation Efficiency (IE)(0.581–0.731)가 일관되게 가장 취약한Dimension으로 나타나,Information Sufficiency가Economical Tool Use보다 달성하기 쉽다는 것을 시사한다.Routing Quality (RQ)와Valid Call Rate (VCR)분석에서는Tool Discovery와Tool Execution이 별개의Failure Mode임을 밝혀냈다. GPT-5.4는 두 단계 모두에서 일관되게 강한 성능을 보였지만 (RQ=0.920,VCR=0.998), Qwen3-Max는 낮은RQ에도 불구하고 높은VCR을, Grok-4.20은 그 반대의 경향을 보였다. [Figure 3] - Persistent Memory:
Memory Interaction(Table 1)에서 보듯이, 모델들은 매우 다른Memory Dynamics를 보였다. Gemini-3.1-Pro는 가장 많은Memory(93개)를 구축하고Memory Content Quality (MCQ)도 높았으나 (0.938),Memory Usage Quality (MUQ)는 가장 낮았다 (0.497). 반대로 Grok-4.20은 적은Memory(12개)를 저장하고MCQ는 낮았지만 (0.760),MUQ는 가장 높았다 (0.855). 모든Memory-Augmented Agent가Tail Loss (TL)를 감소시켜Downside Risk Control을 개선했지만,Return에 미치는 영향은Heterogeneous했다. - Rule Following:
Rule-Specific Metric은Rule-Following Capability의 두 가지Separable Aspect를 보여준다:Execution과Auditability. DeepSeek-V3.2는Rule Satisfaction Score (RSS)에서 강한 성능을 보였으나 (0.847),Rule Auditability Score (RAS)는 훨씬 낮았다 (0.623). 반면 Gemini-3.1-Pro는 두Dimension모두에서 강력했다 (RSS=0.872,RAS=0.882).R1-02 (Single-Asset Concentration Limit)와 같은 특정 규칙에서Failure가 집중되었는데, 이는Existing Exposure,Incremental Orders,Price Movements를Post-Trade Exposure추정 시 부정확하게 결합하는 경향 때문이었다. [Figure 4], [Table 2] - Multi-Agent Collaboration:
Multi-Agent Setup은GPT-5.4(+2.45%),DeepSeek-V3.2(+3.72%),Gemini-3.1-Pro(+2.57%)에게Return Gain을 가져다주었지만,Qwen3-Max의Return은 감소했다 (-4.39%). 모든 모델에서Max Drawdown과Average Tail Loss가 증가하여Multi-Agent가 더Variable Return-Risk Profile과 관련됨을 시사한다.Role Diversity (RD)와Evidence Integration (EI)은 모델별로 다른Collaboration Pattern을 나타냈다. DeepSeek-V3.2는 가장 균형 잡힌 행동 (RD=0.760,EI=0.852)과 가장 높은Observable Collaboration Score (OCS)를 보였으며, 가장 큰Return Gain과 연결되었다.Table 3
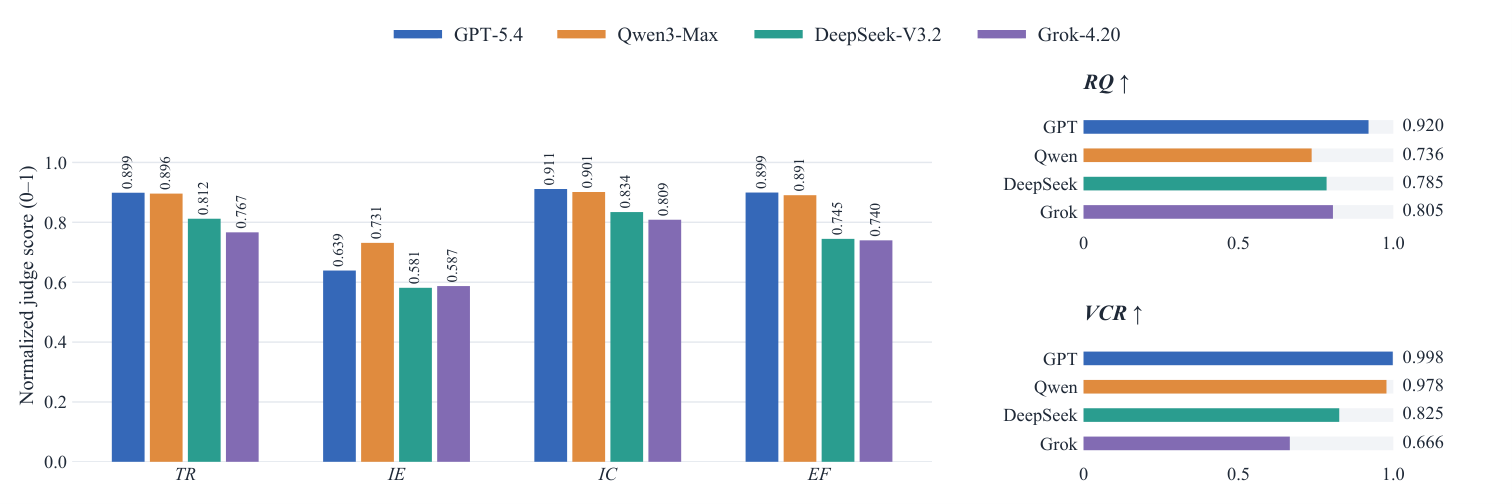
Figure 3 — 도구 사용 능력 세부 분석
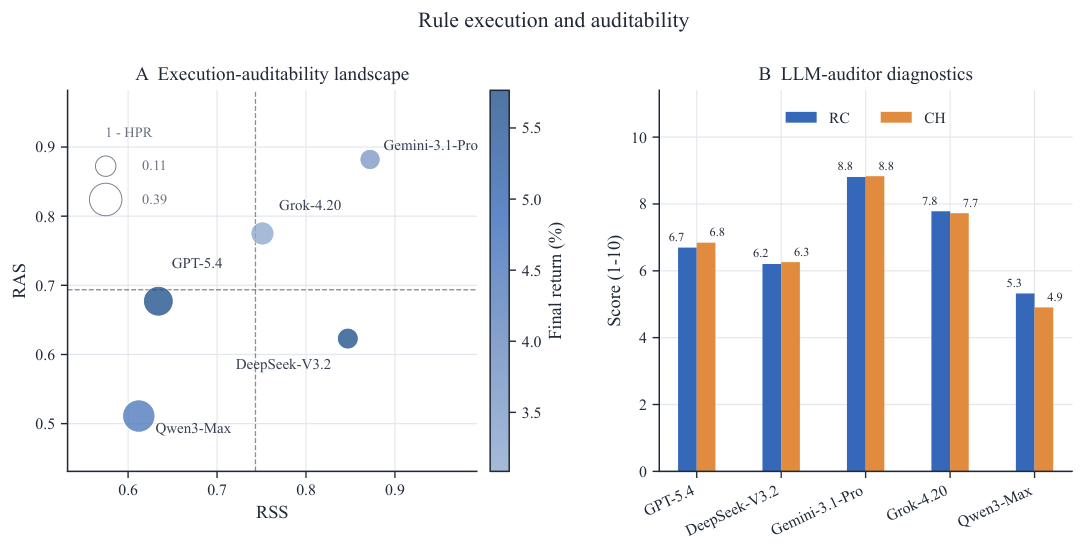
Figure 4 — 규칙 준수 및 감사 가능성
4. Conclusion & Impact (결론 및 시사점)
LiveMACEBench는 Sustained, Externally Driven Change 하에서 LLM Agent의 Capability를 평가하는 Process-Aware Benchmark로서 효과적임을 입증했다. Live Financial Markets를 Evolving Testbed로 사용하여, Mechanism Access, Mechanism Use, 그리고 Realized Effect를 구분하는 Trace-Derived Diagnostics의 중요성을 강조한다. 30일간의 Evaluation을 통해 Realized Performance가 Agent의 Mechanism Effective Use와 항상 일치하지 않는 Outcome–Capability Gap이 존재함을 확인했다. Process Diagnostics는 Memory Accumulation이 Effective Reuse를 보장하지 않고, Rule Execution이 Auditability와 Diverge할 수 있으며, Multi-Agent Gain이 Strong Observable Collaboration 없이도 발생할 수 있음을 보여주었다. 이러한 결과는 유사한 Outcome이 다른 Capability를 숨길 수 있으며, Agentic Mechanism에 대한 Access가 Effective Use나 Improved Performance로 이어지지 않을 수 있음을 시사한다. 이 연구는 LLM Agent Evaluation에서 Outcome 순위 매기기를 넘어 Mechanism을 측정하는 Process-Aware Approach의 필요성을 확립하며, Financial Markets를 넘어 Continuously Evolving Environment로 확장될 수 있는 중요한 Implication을 제공한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Procedural Graphs: Self-Evolving Execution Structures for LLM Agents
- [논문리뷰] OmniScientist: An Omni-Modal Omni-Discipline AI Scientist
- [논문리뷰] OmniScientist: An Omni-Modal Omni-Discipline AI Scientist
- [논문리뷰] Agentic Abstention: Do Agents Know When to Stop Instead of Act?
- [논문리뷰] Escaping the Self-Confirmation Trap: An Execute-Distill-Verify Paradigm for Agentic Experience Learning
Review 의 다른글
- 이전글 [논문리뷰] Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
- 현재글 : [논문리뷰] LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
- 다음글 [논문리뷰] MOSS-Image Technical Report
댓글