[논문리뷰] Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
링크: 논문 PDF로 바로 열기
저자: Zhiyong Cao, Hengjie Zhu, Yongxin Wang, Xuchen Li, Jintao Li, Shuxia Liu, Dunqiang Liu, Bo Wang, Kairan Zhang, Cong Lin, JiangDi Yu, Siyuan Liu, Sijia Yao, Yi-Liang Wei, Lingxu Ma, Aijia Wang, Anxin Chen, Zixian Wei, Xiang Ruan, Ruizhi Xu, Ruqian Shi, Baihua Xiao, Sicheng Zhou
1. Key Terms & Definitions (핵심 용어 및 정의)
- Agent Harness: LLM agent의 operation을 지원하는 system configuration 요소를 지칭하며, model의 decisions와 environment 간의 반복적인 interaction을 관리하는 역할을 한다. 이는 system instructions, context management, available tools, execution environments, persistent state, lifecycle controls, safety mechanisms 등을 포함한다.
- TraceTrial-Bench: Agent Harness의 Reliability와 Failure Attribution을 위해 제안된 mechanism-oriented benchmark이다. 이는 Harness reliability를 7가지 components로 분류하고, native harness behavior를 보존하면서 평가를 수행한다.
- Trajectory Tracing (TT): TraceTrial-Bench의 핵심 모듈 중 하나로, agent execution traces를 capture하여 Trace Intermediate Representation (Trace IR)로 재구성하며, trace의 provenance를 보존한다.
- Multi-source Evidence Acquisition (MEA): TraceTrial-Bench에 포함된 모듈로, agent context, harness, 그리고 execution environment로부터 증거를 수집하여 LLM 기반 evaluation 및 criterion-specific evidence를 제공한다.
- Failure Attribution (FA): Explicit mechanism chains를 활용하여 run-level에서 failure를 attribution하는 모듈로, model errors와 harness shortfalls를 구분하는 데 사용된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 AI agent 벤치마크는 주로 underlying 모델의 성능과 전반적인 Agent 성능 평가에 집중하여, Agent Harness 평가에 대한 관심이 제한적이라는 핵심 문제를 제기한다. Agent의 효과성은 단순히 모델의 capability뿐만 아니라, 모델의 작동을 지원하는 Harness(시스템 지침, context 관리, tool, 실행 환경, state, lifecycle 제어, 안전 메커니즘 등)에 크게 의존한다. [Figure 1]에서 나타나듯이, Task success만으로는 context 손실, 잘못된 tool results, 또는 lifecycle violation과 같은 특정 Harness mechanism의 신뢰성 문제나 Failure attribution을 명확히 식별하기 어렵다. Harness가 고정된 상태에서도 outcome-level 비교만으로는 관찰된 차이점을 유발하는 Harness behavior를 파악하기 어려웠다. 따라서, Agent Harness의 Reliability를 체계적으로 평가하고 Failure를 Attribution할 수 있는 새로운 접근 방식이 필요하다.
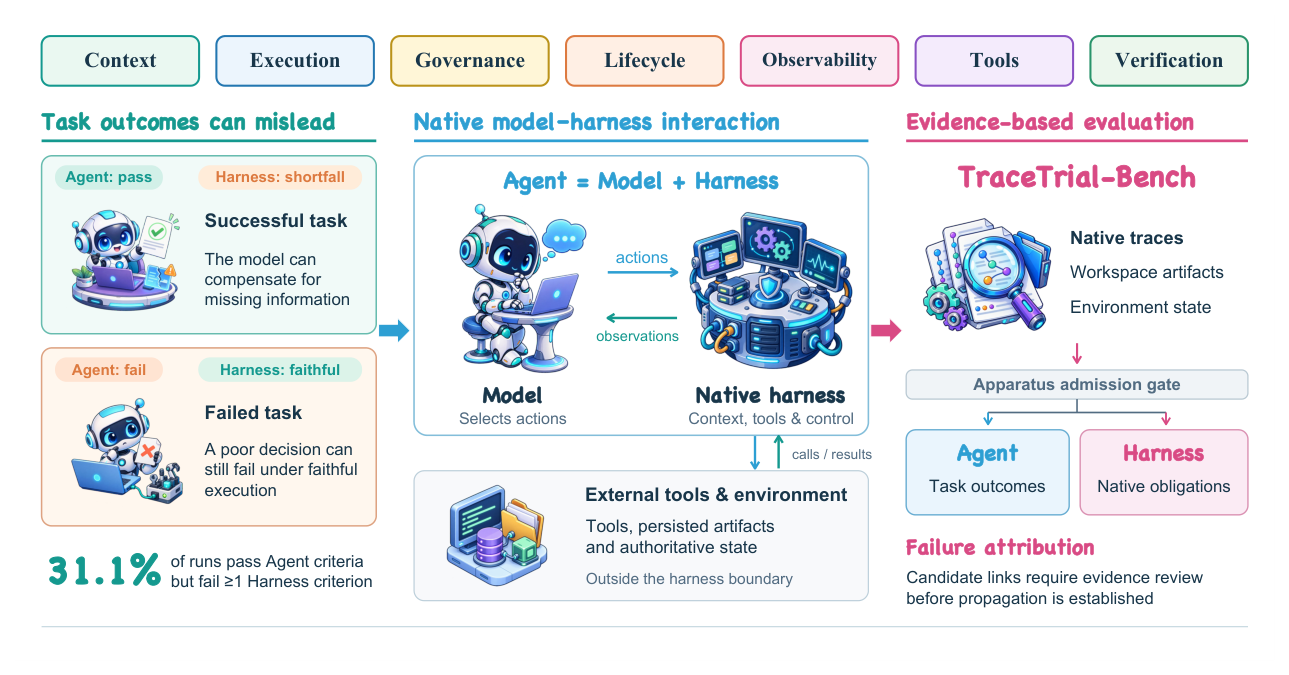
Figure 1 — AI Agent Harness 평가의 필요성과 TraceTrial-Bench의 고수준 개념을 설명하는 핵심 동기 부여 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Harness reliability와 Failure attribution을 체계적으로 평가하기 위해 TraceTrial-Bench라는 mechanism-oriented benchmark를 제안한다. TraceTrial-Bench는 Harness reliability를 Context, Execution, Governance, Lifecycle, Observability, Tools, Verification의 7개 components로 분류하며, [Figure 2]는 제안하는 평가 프레임워크의 개요를 보여준다. 이 프레임워크는 Trajectory Tracing (TT) 모듈을 통해 agent execution traces를 Trace Intermediate Representation (Trace IR)로 재구성하고, Multi-source Evidence Acquisition (MEA) 모듈로 agent context, harness, execution environment에서 증거를 수집하여 LLM 기반 evaluation을 지원한다. 또한, Failure Attribution (FA) 모듈은 explicit mechanism chains를 사용하여 run-level에서 failure를 attribution할 수 있도록 설계되었다. 저자들은 95개의 expert-level, mechanism-oriented task를 구축하여 각 Harness의 native behavior를 보존하며 semantically equivalent한 비교를 가능하게 했다.
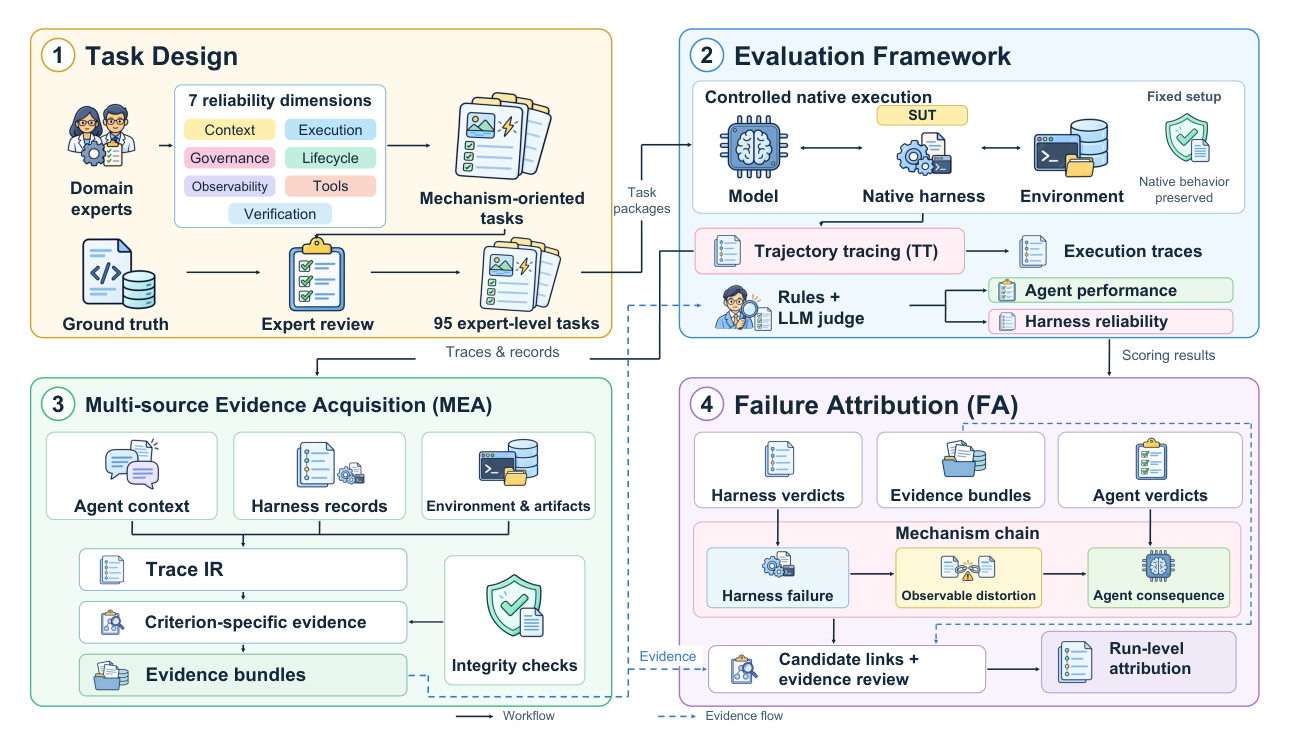
Figure 2 — 제안하는 TraceTrial-Bench의 전체 아키텍처와 주요 모듈(TT, MEA, FA)의 상호작용을 보여주는 핵심 프레임워크 다이어그램
4개 Harness, 9개 모델, 95개 task에 걸쳐 총 3,420개 run을 평가한 결과, macro-averaged Harness score는 59.8%에서 72.0% 범위로 나타났다. [Table 6]에서 볼 수 있듯이, Claude Code는 가장 높은 Agent task-success rate인 44.0%와 Agent macro score인 75.9%를 기록했다. 반면, OpenClaw는 가장 높은 Harness macro rate인 72.0%와 Harness micro rate인 71.9%를 달성했다. 특히, 총 run의 31.1%는 하나 이상의 Harness criterion을 실패했음에도 불구하고 task success를 달성했는데, 이는 outcome-only evaluation이 Harness reliability 차이를 간과할 수 있음을 명확하게 보여주는 정량적 증거이다. Harness macro rate의 범위는 12.2 percentage points로, Codex의 59.8%에서 OpenClaw의 72.0%까지 큰 차이를 보였다.
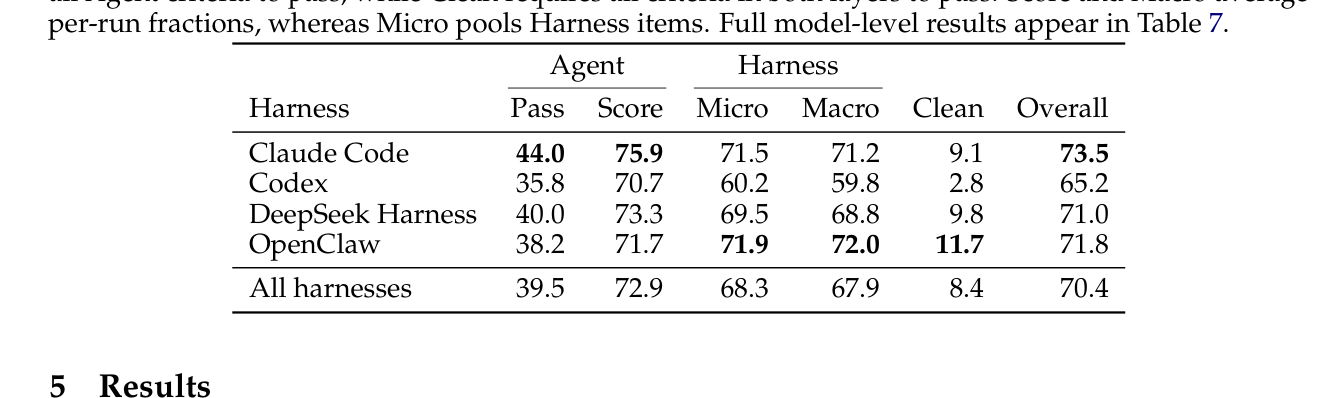
Table 6 — 4개 Harness에 대한 Agent 및 Harness의 종합적인 성능 지표를 정량적으로 비교하는 핵심 결과 테이블
4. Conclusion & Impact (결론 및 시사점)
결론적으로, 본 논문은 AI Agent Harness의 신뢰성과 Failure attribution을 위한 TraceTrial-Bench를 제안하며, 기존 outcome-only 평가의 한계를 극복한다. TraceTrial-Bench는 native agent harnesses를 95개의 mechanism-oriented task를 통해 7가지 reliability components에 걸쳐 평가하고, Trajectory Tracing 및 Multi-source Evidence Acquisition을 통해 Agent 및 Harness score를 분리하여 평가한다. 또한, explicit mechanism chains를 활용한 Failure Attribution을 통해 auditable한 Failure 분석을 가능하게 한다.
이 연구는 Harness 설계의 약점을 진단하고, Harness 개선을 위한 auditable하고 reproducible한 foundation을 제공함으로써 AI Agent 개발 및 평가 분야에 중요한 시사점을 준다. 특히, 31.1%의 run에서 Harness criterion 실패에도 불구하고 Agent success를 달성했다는 결과는 Harness reliability가 task outcome과 독립적으로 평가되어야 함을 강력하게 지지하며, Harness design과 model behavior 간의 복잡한 상호작용을 이해하는 데 필수적인 도구를 제공한다. 이는 장기적으로 AI Agent의 전반적인 reliability와 robustness 향상에 기여할 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] FDE-Gym: The Last Mile of AI Delivery
- [논문리뷰] One Success Isn't Reliability: Thinkingbox, a Sandbox and Benchmark for Agents in Stateful Business Workflows
- [논문리뷰] HarnessRisk: A Lifecycle-Oriented Benchmark for Agent Harness Safety
- [논문리뷰] AGVBench: A Reliability-Oriented Benchmark of Data Augmentation for Vein Recognition
- [논문리뷰] DoVer: Intervention-Driven Auto Debugging for LLM Multi-Agent Systems
Review 의 다른글
- 이전글 [논문리뷰] Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
- 현재글 : [논문리뷰] Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
- 다음글 [논문리뷰] Trust Mechanisms for Offline Generative AI at the Edge: A Connectivity-Regime Framework and an Empirical Study on a Raspberry Pi 5
댓글