[논문리뷰] BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xinyu Fang, Yuchi Wang, Weihao Yu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MLLMs (Multimodal Large Language Models): 텍스트, 이미지, 비디오 등 다양한 입력을 처리하고 소프트웨어 조작이나 코드 실행을 통해 자율적으로 작업을 수행하는 인공지능 모델입니다.
- BlenderWorld: 3D 재구성, 수정, 설계 작업에서 시각적 에이전트의 성능을 평가하기 위해 설계된 223개 태스크 기반의 포괄적인 벤치마크입니다.
- AaR (Automatic Agent Render): 제안된 Blender 프로젝트를 다각도에서 자동으로 렌더링하여 평가를 위한 시각적 증거를 수집하는 프로토콜입니다.
- Rubric Judging: 미리 정의된 2,651개의 이진 기준(Binary Rubrics)을 바탕으로, VLM 및 에이전트가 작업의 성공 여부를 구조적 및 시각적으로 검증하는 평가 방식입니다.
- MCP (Model Context Protocol): Blender 환경과의 상호작용을 위해 사용되는 인터페이스로, 에이전트가 3D 장면을 검사, 수정, 렌더링하는 데 필요한 도구들을 제공합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 실세계 레퍼런스를 바탕으로 한 3D 생성 및 편집 작업에서 MLLMs 기반 에이전트의 성능을 체계적으로 평가할 수 있는 통합 프레임워크가 부족하다는 점을 해결하고자 합니다. 기존 벤치마크들은 특정 객체나 고정된 기하학적 목표에만 집중하거나, 복잡한 3D 프로젝트를 종합적으로 검증할 환경이 결여되어 있다는 한계가 있습니다. 특히, 실세계의 오픈 엔드 요청을 수행할 때 모델들이 시각적인 2D 단서에 의존하여 3D 구조적 일관성을 확보하지 못하는 경우가 빈번합니다 [Figure 1]. 이러한 정렬 문제와 3D 생성 에이전트의 평가 표준화를 위해 BlenderWorld를 제안합니다.
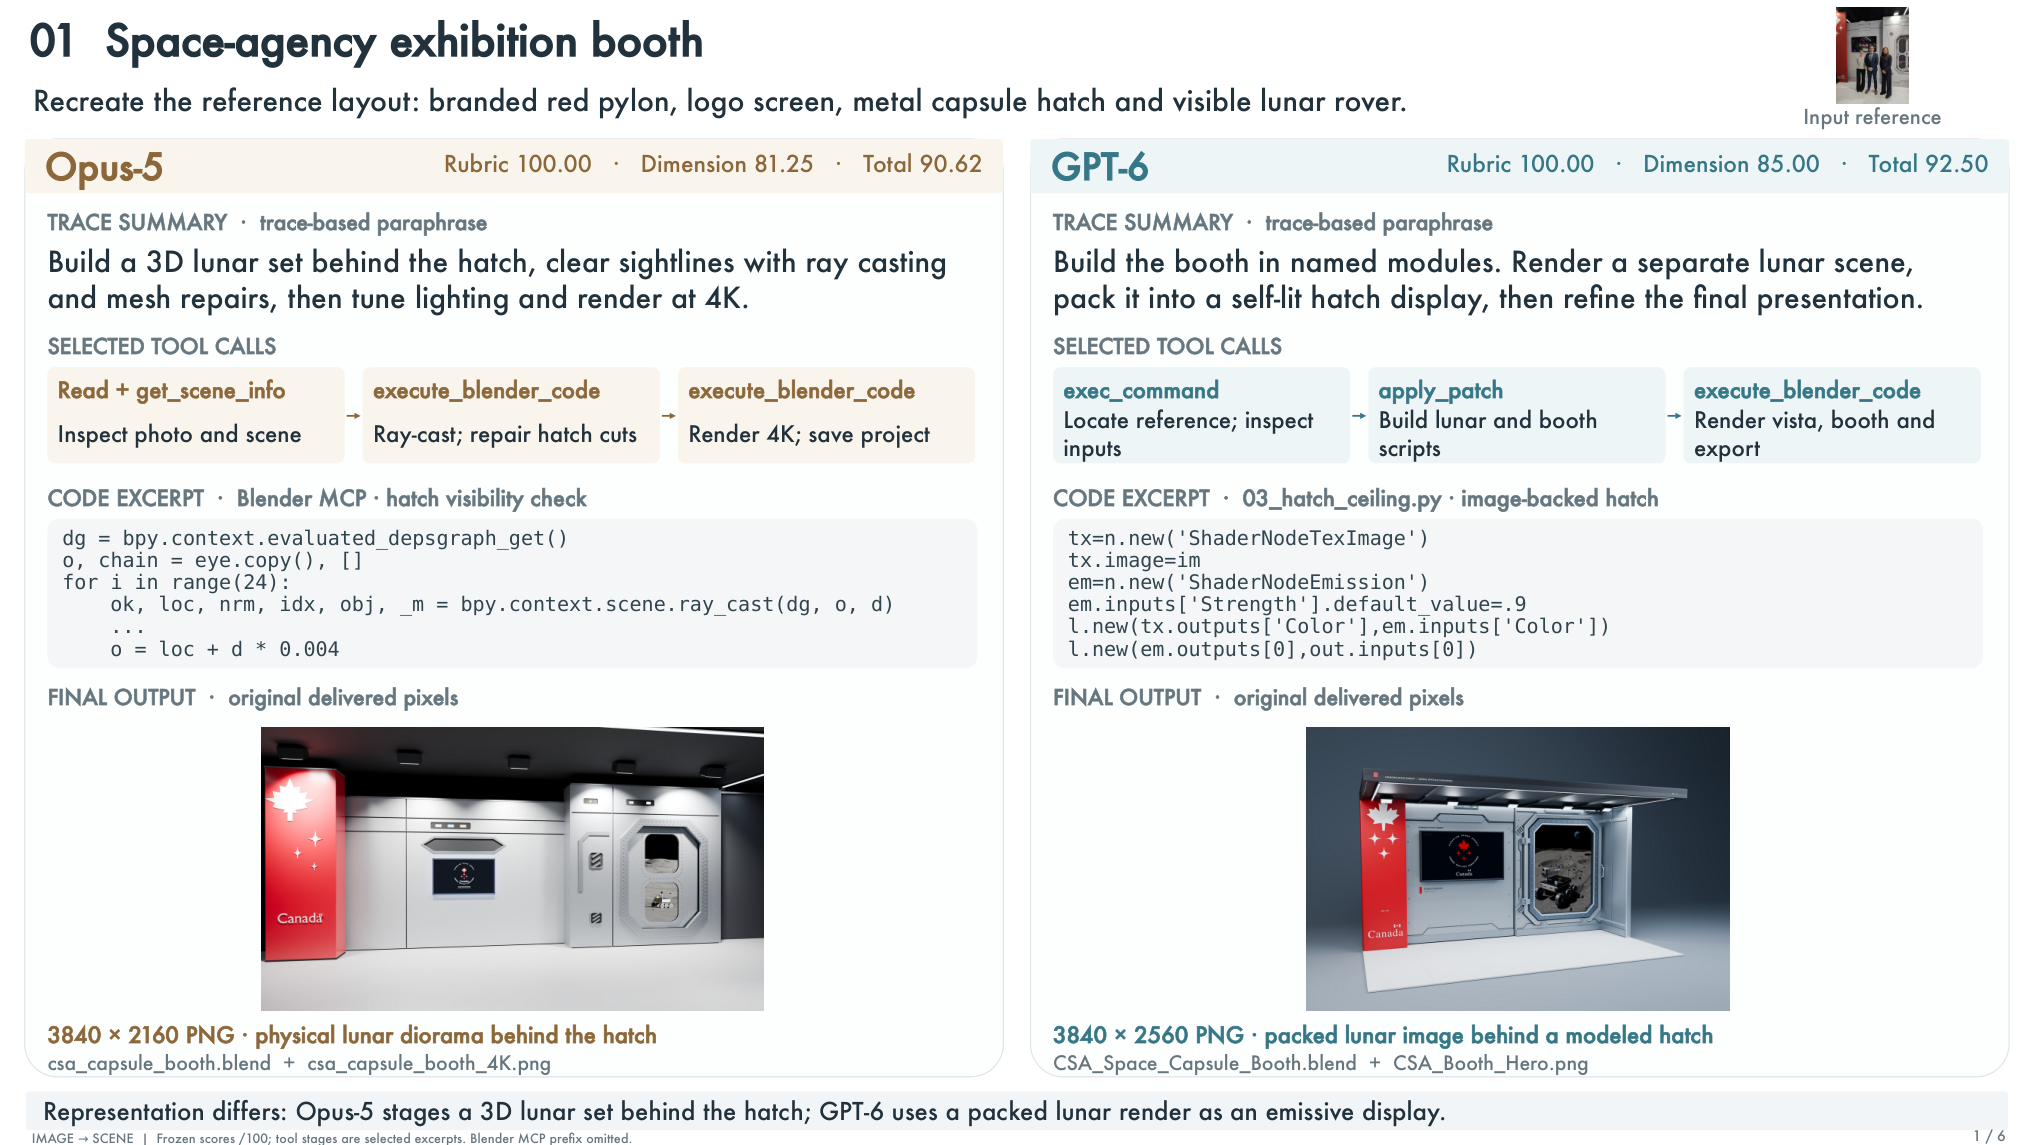
Figure 1 — BlenderWorld의 태스크 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 16개의 실무 적용 시나리오를 포함하는 223개의 3D 태스크로 구성된 BlenderWorld를 구축하고, 시각적 품질 평가와 구조적 검증을 병행하는 다각적 평가 프로토콜을 도입했습니다 [Figure 2]. 제안된 AaR 프로토콜은 에이전트가 제출한 프로젝트를 8개의 보완적인 뷰로 렌더링하며, VLM-as-Judge와 Agent-as-Judge라는 이중 판정 시스템을 통해 시각적 외관 및 내부 장면 구조를 엄격하게 평가합니다 [Figure 4]. 주요 실험 결과, GPT-6-Astra가 79.9의 Fused Score를 기록하며 가장 우수한 성능을 보였고, 뒤를 이어 Opus-5(73.0), GPT-5.6-Sol(67.7) 순으로 측정되었습니다. 그러나 최상위 모델조차 모든 rubric criterion을 만족시키는 Perfect 비율은 42.2%에 불과하여, 에이전트가 정교한 3D 공간 일관성 및 구조적 재현 능력을 달성하는 데 여전히 큰 기술적 병목이 존재함을 확인했습니다 [Table 2]. 이는 에이전트들이 2D 시각 정보에 의존하는 'Shortcut' 문제를 해결하고, 실제 3D 구조적 제약 조건을 반영하는 능력을 갖춰야 함을 시사합니다 [Figure 3].
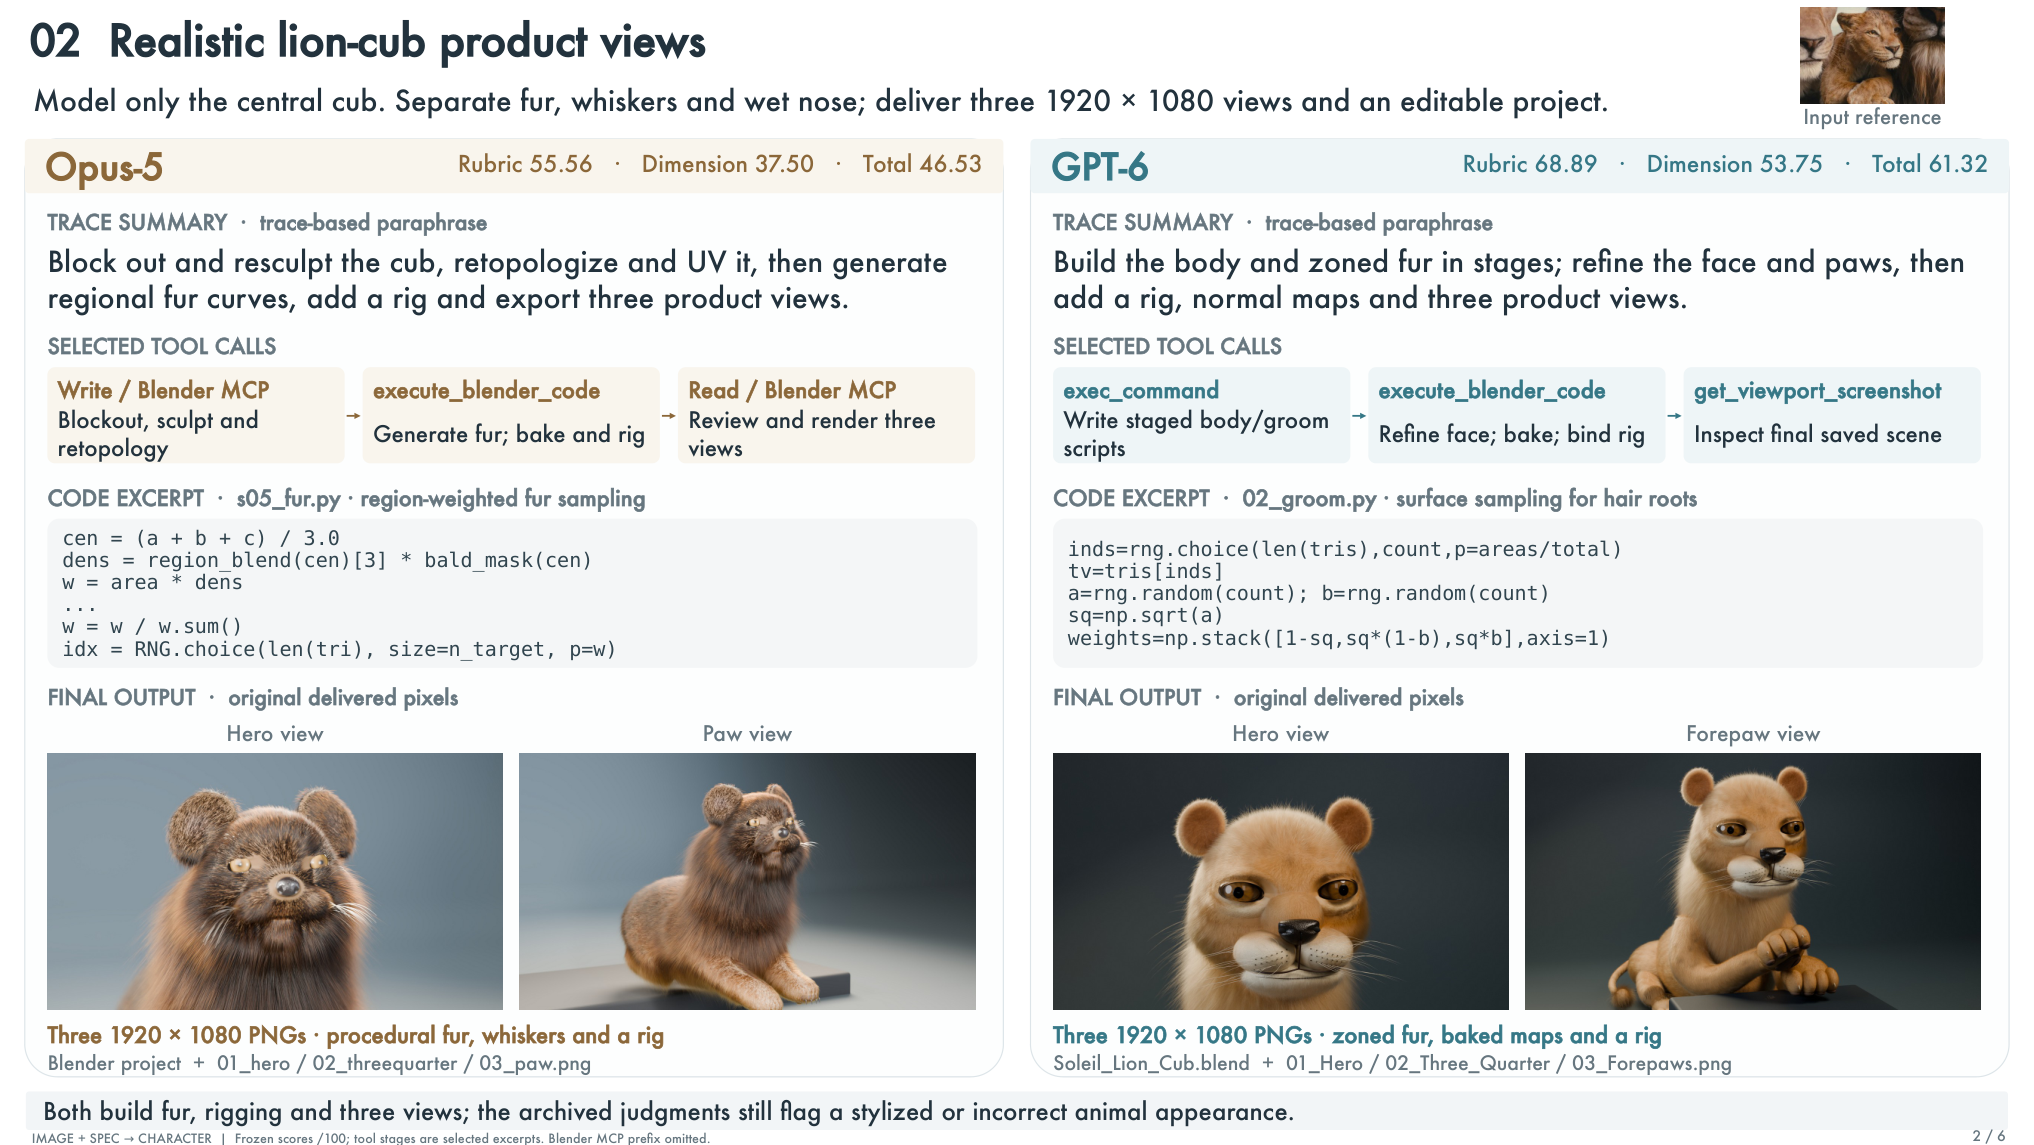
Figure 2 — BlenderWorld 구축 워크플로우
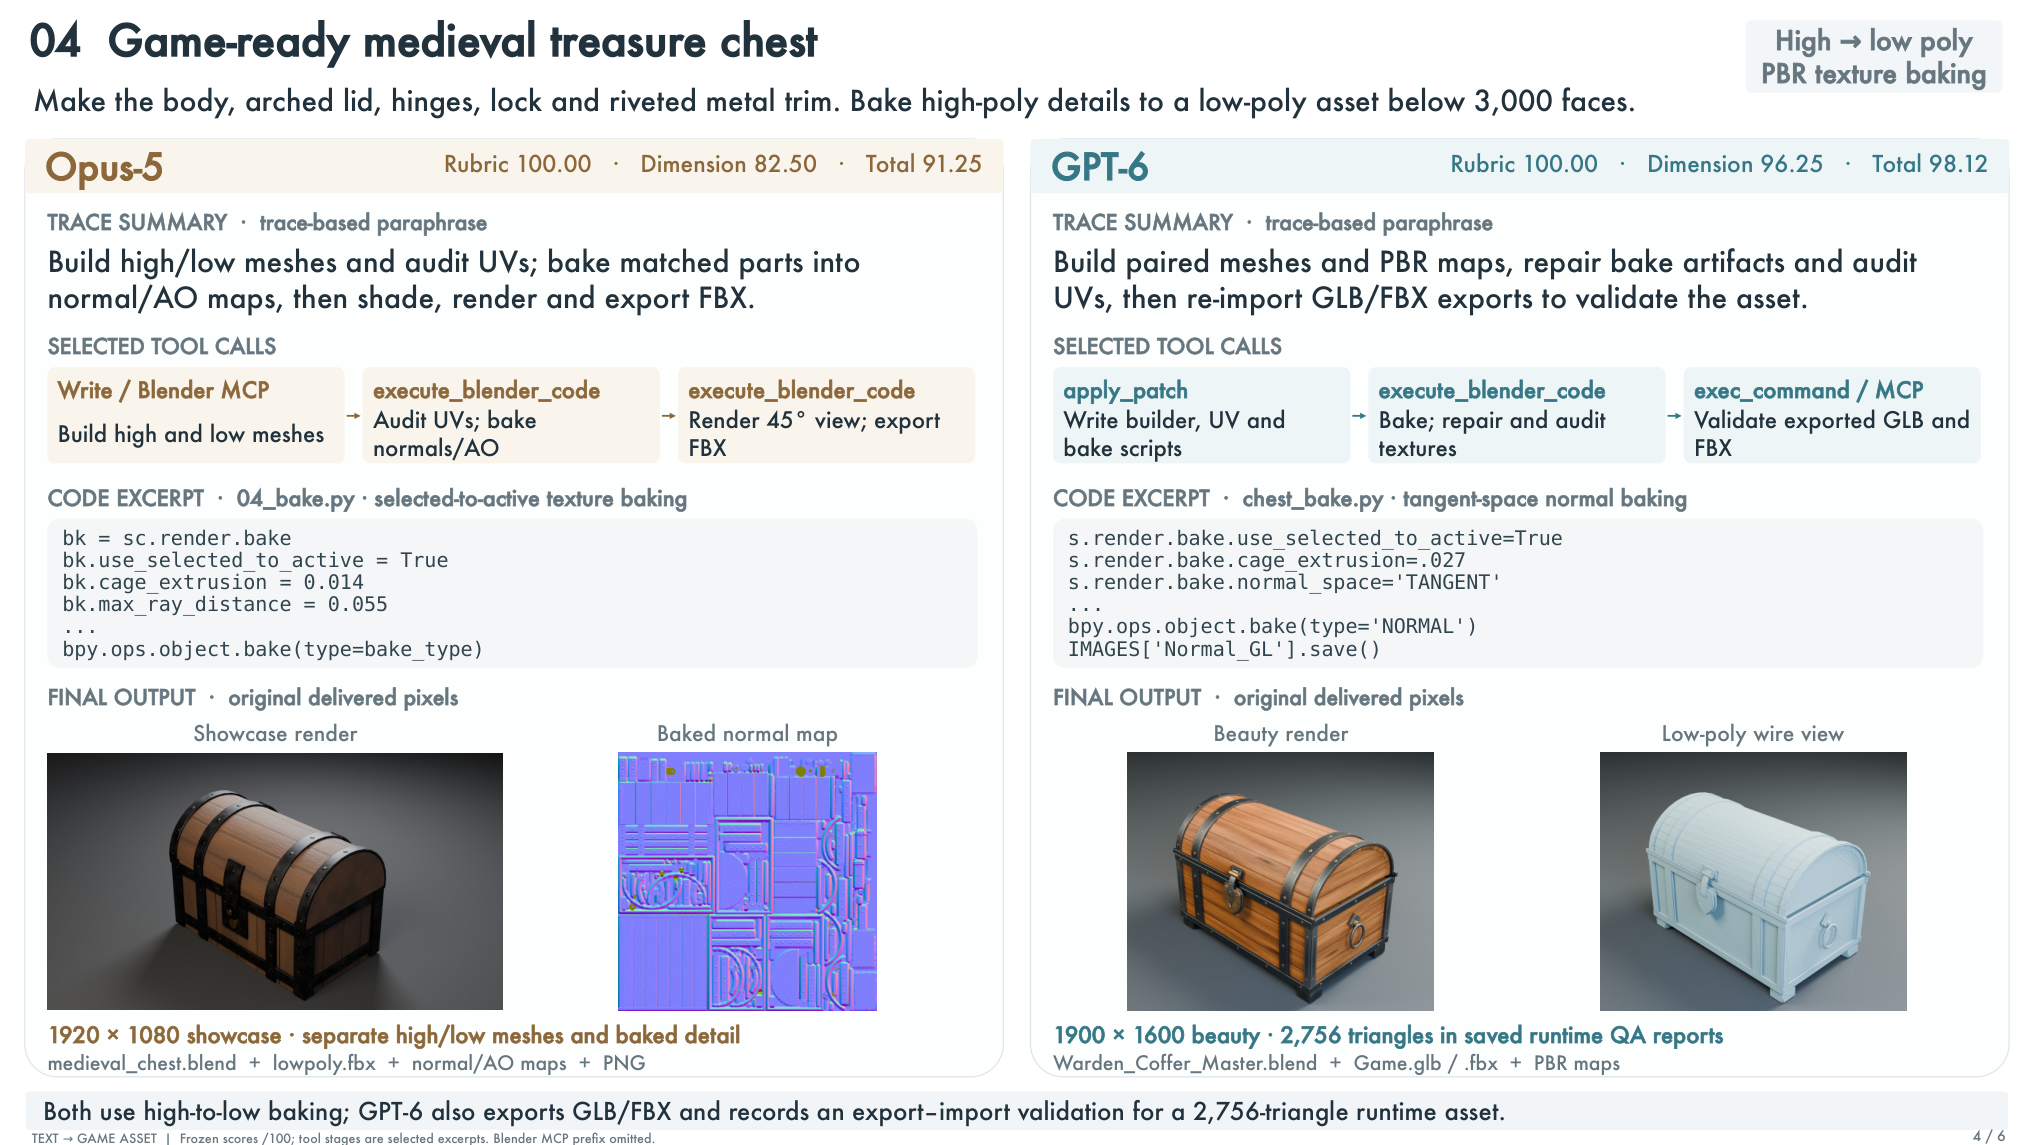
Figure 4 — BlenderWorld 평가 파이프라인
4. Conclusion & Impact (결론 및 시사점)
본 논문은 3D 생성 분야에서 에이전트의 실질적인 생산성을 측정하는 최초의 종합적 벤치마크로서 BlenderWorld의 중요성을 제시합니다. 연구 결과는 현재의 최첨단 모델들이 복잡한 지시를 이해하고 도구 호출을 수행하는 능력은 뛰어나지만, 정밀한 3D 공간 일관성을 유지하거나 구조적 보정으로 이어지는 추론 능력은 부족함을 명확히 보여줍니다. 향후 본 연구는 3D 네이티브 에이전트의 설계 방향을 제시하고, 학계와 산업계가 실질적인 3D 워크플로우를 자동화하는 모델을 개발하는 데 있어 중요한 이정표 역할을 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
- [논문리뷰] OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
- [논문리뷰] Spatial Memory Intelligence: Endowing World Models with Understanding-Driven Long-Term Memory
- [논문리뷰] BVB: Benchmarking Agentic Video Understanding via Programmatic Reconstruction in Blender
- [논문리뷰] RoboSPA: Can VLA Models Go Beyond Simple Scenes and Short-Horizon Tasks?
Review 의 다른글
- 이전글 [논문리뷰] AnyGoal: On World Model Generalization Beyond Expert Rollouts
- 현재글 : [논문리뷰] BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
- 다음글 [논문리뷰] Co-Evolving Acting and Forecasting for Language Agents
댓글