[논문리뷰] DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
링크: 논문 PDF로 바로 열기
저자: Deshui Miao, Yuhang Ma, Shaoyong Jia, Wenzhao Gao, Yue Zhang, Shaohui Jiao, Xin Li
1. Key Terms & Definitions (핵심 용어 및 정의)
- DVTE-Bench: 다양한 텍스트 오버레이(자막, 로고, 워터마크 등) 조건에서 비디오 재구성 성능을 평가하기 위해 제안된 1,631개의 페어드 데이터셋 및 벤치마크 프레임워크입니다.
- Source-Anchored Flow: 비디오의 오버레이 영역을 제거하고 원본 소스 latent를 기반으로 점진적으로 깨끗한 영상을 복원하는 모델 구조입니다.
- VSA (Visibility-aware Source Aggregation): 오버레이로 마스킹된 영역을 제외하고 가시성이 확보된 주변 프레임의 소스 정보를 효율적으로 집계하여 복원에 활용하는 기법입니다.
- Velocity Network: Flow Matching 학습 과정에서 소스에서 클린 상태로의 변화(Correction)를 예측하기 위해 공유 가중치를 사용하는 핵심 신경망입니다.
- GSC (Global Source Conditioning): 로컬 정보가 부족한 영역에 대해 비디오 전체의 시공간적 문맥 정보를 제공하여 재구성 품질을 높이는 컨디셔닝 모듈입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 비디오 내 자막이나 로고와 같은 오버레이를 제거할 때 발생하는 잔여물(Residual overlays) 및 장면 구조 왜곡 문제를 해결하고자 합니다. 기존의 propagation 기반 방식은 오버레이가 지속될 경우 복원 정보가 부족하며, generative 방식은 노이즈에서 시작하여 소스 정보를 충분히 활용하지 못해 일관성이 떨어지는 한계가 있습니다. 저자들은 소스 정보를 직접적인 고정 가이드로 활용하여 초기 상태부터 복원 과정까지 소스 latent를 앵커로 유지하는 새로운 프레임워크가 필요하다고 판단하였습니다 [Figure 1]. 이를 검증하기 위해 기존 벤치마크의 한계를 극복하고 다양한 오버레이 유형을 포괄하는 새로운 표준 데이터셋의 부재를 해결하고자 합니다.
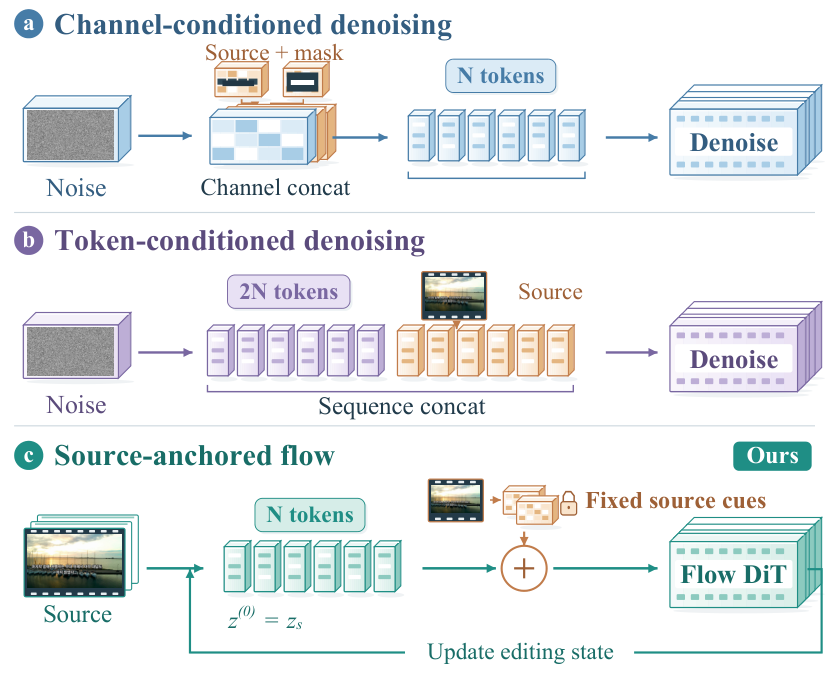
Figure 1 — 기존 모델과 제안 모델 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 소스 latent에서 시작하여 고정된 소스 가이드를 받는 Source-Anchored Flow 모델인 DeOverlay를 제안합니다 [Figure 3]. 모델은 Region-weighted Flow Matching 목적 함수를 사용하여 소스에서 클린 상태로의 변화를 학습하며, inference 시에는 Shared-weight Euler updates를 통해 점진적인 수정 과정을 거칩니다. 이때 VSA와 GSC를 통해 오버레이로 가려지지 않은 유효한 소스 정보와 전체적 문맥을 투입함으로써 고품질의 재구성을 달성합니다. DVTE-Bench를 통한 정량적 실험 결과, DeOverlay는 기존 baseline 대비 압도적인 성능 우위를 보였습니다. 특히 Mask LPIPS와 Mask VFID에서 기존 최강 모델 대비 각각 58.3% 및 70.3% 향상된 성능을 기록하였습니다 [Table 2]. 또한, Mask PSNR은 30.80 dB, SSIM은 0.8822를 달성하여 복원된 영상의 픽셀 및 구조적 충실도를 입증했습니다 [Figure 4].
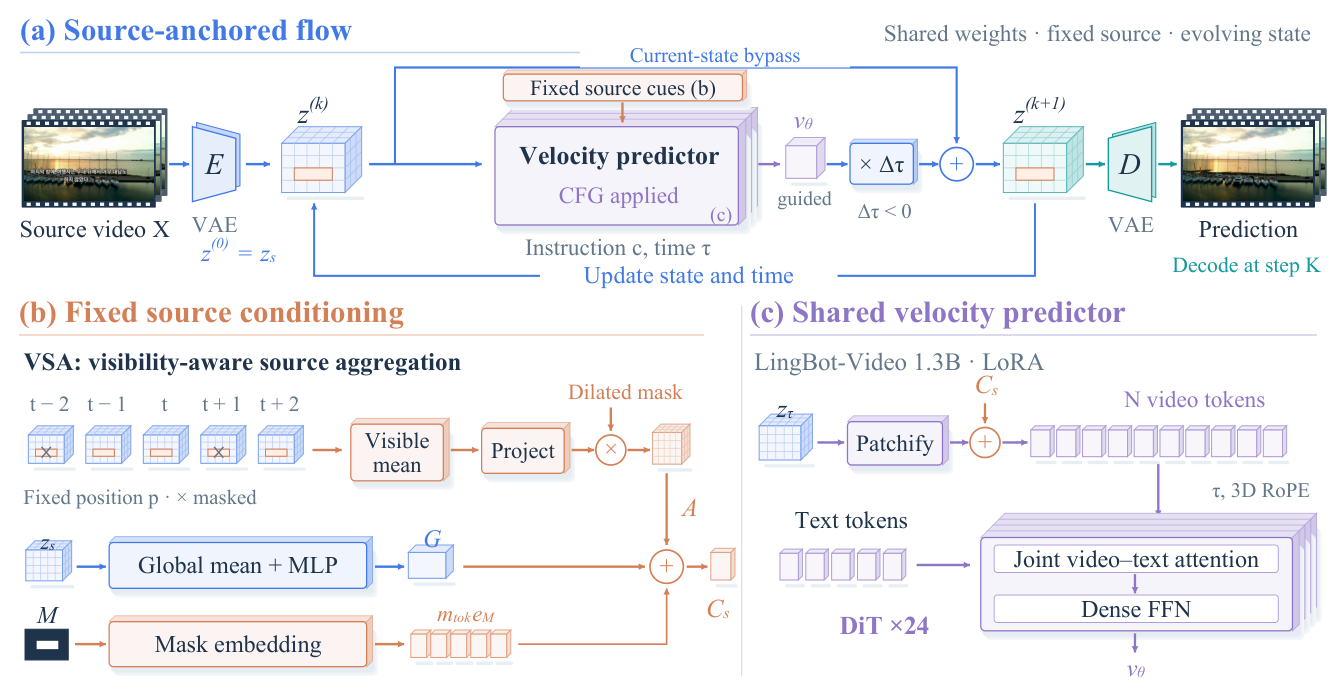
Figure 3 — DeOverlay 전체 아키텍처
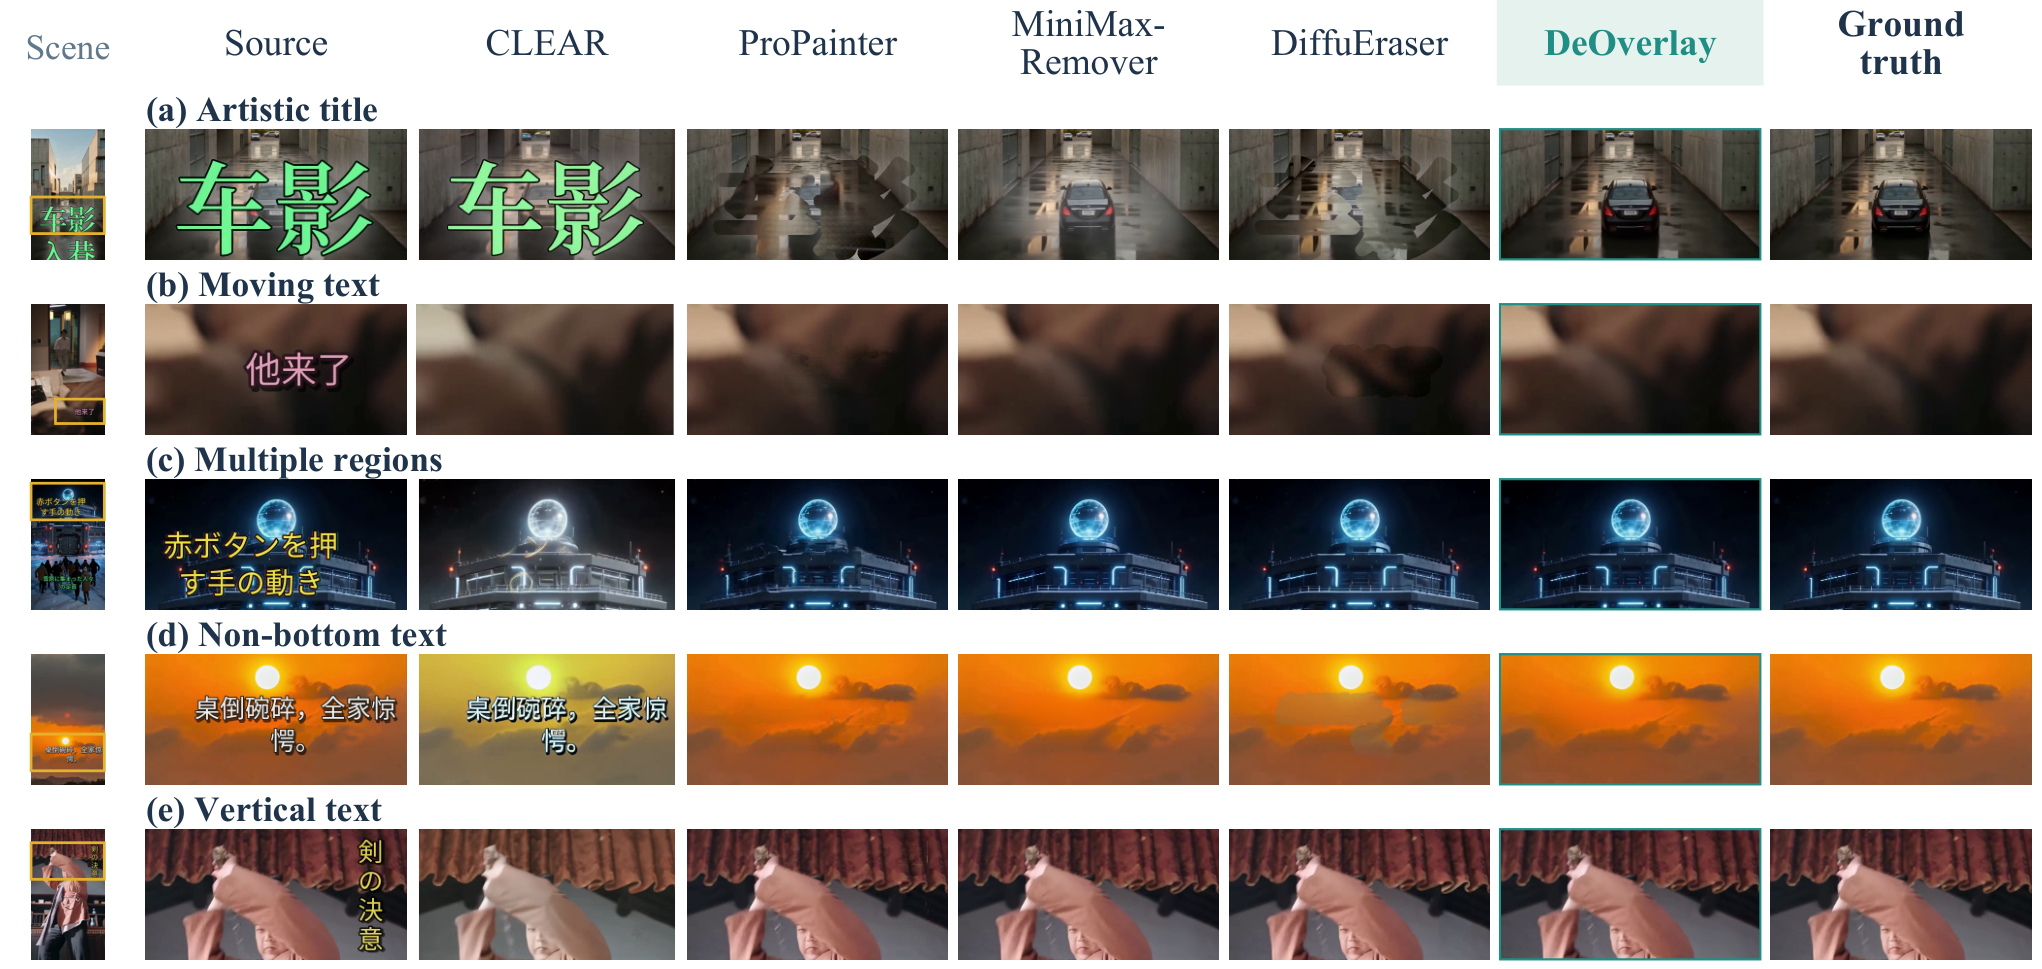
Figure 4 — 모델별 정성적 복원 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 비디오 오버레이 제거 작업을 위한 새로운 벤치마크 DVTE-Bench와 효과적인 모델 DeOverlay를 성공적으로 제시하였습니다. 제안된 방식은 소스 정보를 가이드로 삼아 복원 정확도를 크게 향상시켰으며, 이는 다양한 오버레이 환경에서도 강건한 성능을 보입니다. 본 연구는 학계에 표준화된 평가 지표와 대규모 데이터셋을 제공함으로써 향후 비디오 편집 및 복원 분야의 연구 활성화에 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] PixRestore: Unified Image Restoration via Pixel Diffusion Transformer
- [논문리뷰] PolyFlow: Continuous Topology Embedding Flow Matching for Artist-style Mesh Generation
- [논문리뷰] TV2TV: A Unified Framework for Interleaved Language and Video Generation
- [논문리뷰] ACG: Action Coherence Guidance for Flow-based VLA models
- [논문리뷰] X-VLA: Soft-Prompted Transformer as Scalable Cross-Embodiment Vision-Language-Action Model
Review 의 다른글
- 이전글 [논문리뷰] CoworkEnv: Synthesizing Training Environments for Long-Horizon Cowork Agents
- 현재글 : [논문리뷰] DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
- 다음글 [논문리뷰] ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
댓글