[논문리뷰] HSPR: Recovering Software-Agent Benchmark Scores via Hierarchical Posterior Inference
링크: 논문 PDF로 바로 열기
저자: Wanyi Chen, Wanqin Shen, Yuanchen Shi, Zhensu Sun, Fang Kong, et al.
키워: Software-Agent Evaluation, Benchmark Score Recovery, Hierarchical Modeling, Adaptive Querying, Posterior Inference, Mean Absolute Error, SWE-bench
1. Key Terms & Definitions (핵심 용어 및 정의)
- HSPR (Hierarchical Score Posterior Recovery): Source-fitted response factors와 uncertain group success rates를 결합하여 target agent의 full-benchmark score를 효율적으로 추정하는 방법론입니다.
- MAE (Mean Absolute Error): 예측된 score와 실제 score 간의 평균 절대 오차로, score estimation의 정확도를 측정하는 핵심 metric입니다.
- MaxErr (Maximum Absolute Error): 예측된 score와 실제 score 간의 최대 절대 오차를 나타내며, worst-case estimation error를 파악하는 데 사용됩니다.
- Kendall's Tau (τb): software agent들의 성능 rankings가 얼마나 잘 보존되는지를 측정하는 통계적 metric으로, 순위 예측의 신뢰도를 평가합니다.
- Source-signature groups: historical agents의 binary outcomes에 기반하여 tasks들을 그룹화한 것으로, 새로운 target agent에 대해 유사한 response tendency를 공유하는 task들의 집합을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 software agent를 full benchmark에서 평가하는 것이 expensive하며, limited execution budget 내에서 full-benchmark score를 정확하게 recover하는 문제에 직면한다. 기존의 subset selection 방식은 agent rankings를 보존할 수 있지만, inaccurate scores를 제공하는 한계가 있다. 예를 들어, SWE-bench Pro에서 Mid-Range selection은 높은 Kendall's Tau (τb = .967)를 보이지만, MAE는 22.798 percentage points (pp)에 달해 점수 정확도가 낮다. Historical responses는 유용한 structure를 제공하지만, 동일한 source response patterns을 가진 tasks라도 새로운 target agent에 대해 다른 outcomes를 가질 수 있으며, 이러한 transfer uncertainty는 기존 방법론들이 간과하는 부분이다. 이러한 배경에서, 저자들은 source response patterns이 target으로 전이되는 과정의 uncertainty를 고려하면서 적은 수의 실행만으로 full-benchmark score를 recover할 수 있는 새로운 접근 방식의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 source-fitted response factors와 uncertain group success rates를 결합하여 target agent의 full-benchmark score를 recover하는 Hierarchical Score Posterior Recovery (HSPR)를 제안한다 [Figure 2]. HSPR은 historical agents의 source responses를 기반으로 regularized logistic item model을 학습하여 item parameters (bi, ai, vi)를 얻고, task들을 source-signature groups로 그룹화한다. 관찰된 target outcomes는 target latent response state z=(θ, u)와 group success rates qg에 대한 posteriors를 update하는 데 사용된다. 다음 task 선택은 expected one-step reduction in finite-score variance를 최대화하는 posterior-guided acquisition criterion을 따른다. 최종 score estimate는 source-selected calibration이 적용된 full-score posterior의 median으로 산출된다.
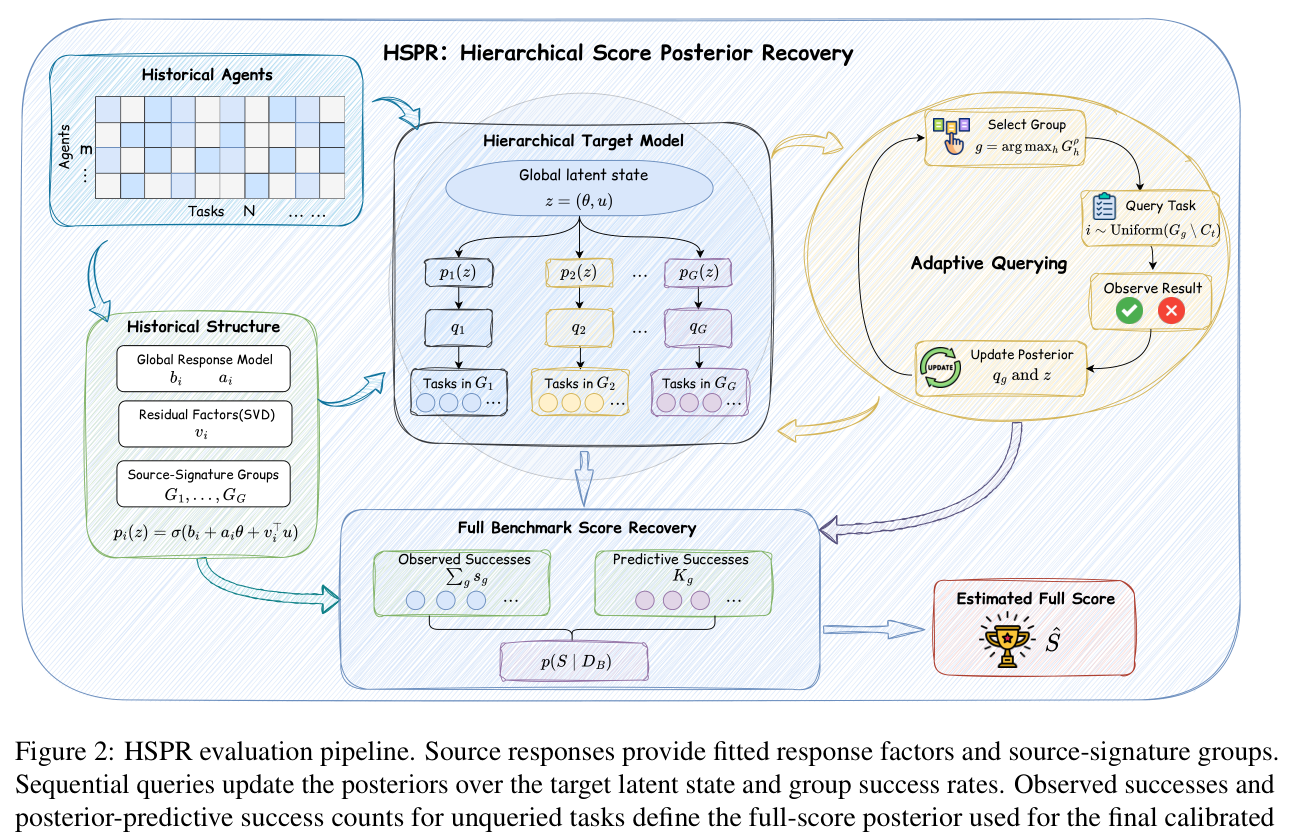
Figure 2 — HSPR 방법론의 전체적인 아키텍처와 데이터 흐름을 시각적으로 보여주는 핵심 다이어그램
실험 결과, 10%의 task budget에서 HSPR은 SWE-bench family의 4개 task banks (Lite, Verified, Full, Pro) 중 3개 bank (Lite, Full, Pro)에서 가장 낮은 MAE를 달성했으며, 모든 4개 bank에서 가장 낮은 MaxErr를 기록했다 [Table 1]. HSPR의 equal-bank macro MAE는 1.664 pp로, 가장 강력한 baseline인 PTA-IRT의 2.478 pp보다 낮았다. 특히 Pro bank에서 HSPR은 MAE 2.098 pp로 Mid-Range selection의 MAE 22.798 pp 대비 압도적인 성능을 보였다. Ablation study [Table 2]에서는 group uncertainty를 제거할 경우 macro MAE가 1.664 pp에서 1.808 pp로 증가했으며, adaptive queries를 Uniform 또는 Mid-Range 고정 쿼리로 대체할 경우 macro MAE가 각각 3.085 pp 및 2.934 pp로 크게 상승하여, 제안된 hierarchical modeling과 adaptive querying의 중요성을 명확히 입증했다. 또한, 5-20% task budgets에 걸쳐 HSPR의 equal-bank macro MAE는 2.562 pp에서 1.262 pp로 지속적으로 감소하는 경향을 보였다 [Figure 3].
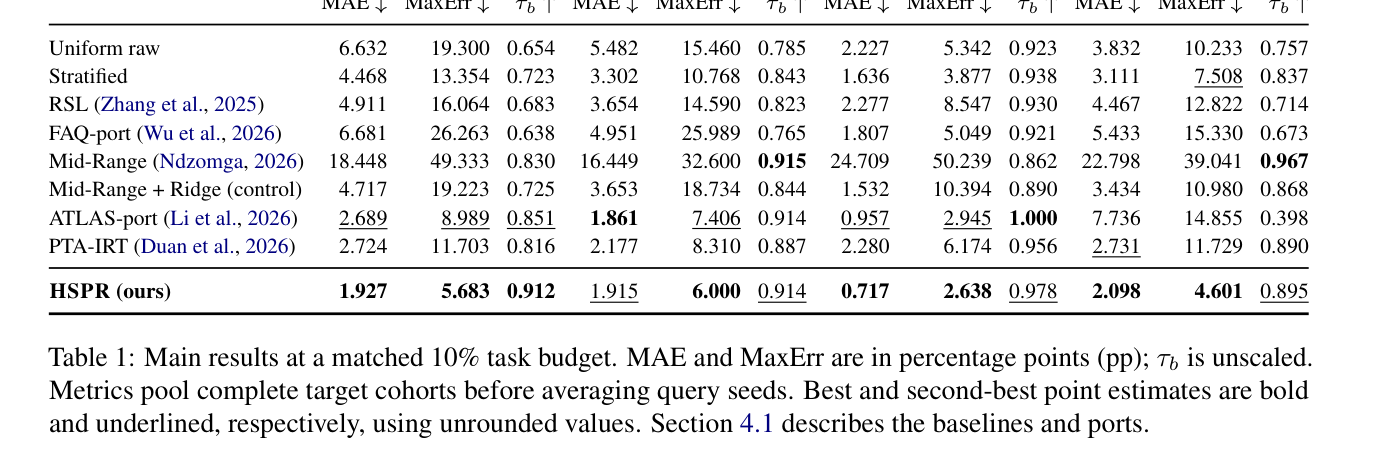
Table 1 — 제안된 HSPR과 다양한 baseline 방법론들의 MAE, MaxErr, Kendall's Tau 성능을 10% task budget에서 비교하는 주요 정량적 결과표
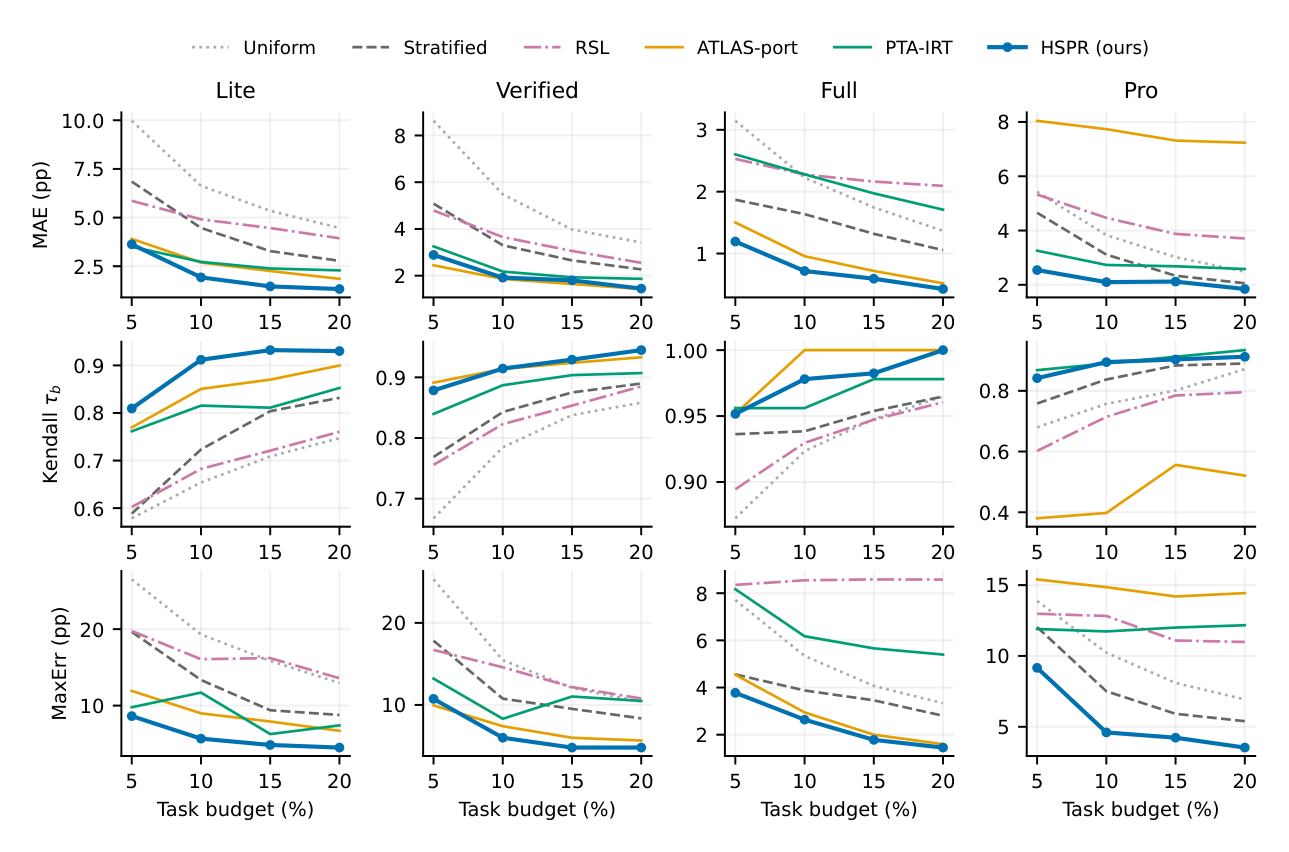
Figure 3 — 다양한 task budget(5%~20%)에 따른 HSPR 및 baseline 방법론들의 MAE, MaxErr, Kendall's Tau 변화를 보여주는 그래프
4. Conclusion & Impact (결론 및 시사점)
본 연구는 source-fitted response factors, uncertain group success rates, 그리고 posterior-guided acquisition을 활용하는 HSPR이 제한된 관찰만으로 full-benchmark scores를 정확하게 추정할 수 있음을 입증한다. HSPR은 주요 SWE-bench task banks에서 우수한 MAE와 MaxErr를 보여주며, 특히 adaptive querying과 hierarchical modeling이 성능 향상에 크게 기여함을 확인했다. 이 연구는 task-efficient score recovery에서 historical response structure의 중요한 역할을 강조한다. 이는 software agent evaluation의 효율성을 크게 높여, AI agents의 progress 비교 및 capability assessment에 실질적인 도움을 줄 수 있으며, limited budget 환경에서 reliable evaluation을 가능하게 하는 새로운 표준을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] World Model Interpretability: From Decoding Representations to Understanding Latent Worlds
- [논문리뷰] Where is Physical RSI capability from? An Observational Scaling Law of LLM-as-policy
- [논문리뷰] UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
- [논문리뷰] Think Visually Across Space and Time: Grounded Reasoning for Video Segmentation
Review 의 다른글
- 이전글 [논문리뷰] Frechet Forcing: Training Long-Horizon Streaming World Models from Short Clips
- 현재글 : [논문리뷰] HSPR: Recovering Software-Agent Benchmark Scores via Hierarchical Posterior Inference
- 다음글 [논문리뷰] HandsOn: A Large-Scale Simulation Benchmark for Generalizable Dexterous Manipulation
댓글