[논문리뷰] Qwen-Audio-3.1-ASR Technical Report
링크: 논문 PDF로 바로 열기
저자: Chuanmeng Bian, Daren Chen, Peixin Chen, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Speaker-diarized ASR: 음성 인식 결과에 발화자 정보(Speaker labels)와 타임스탬프를 결합하여 구조화된 출력을 생성하는 기술.
- General Audio Understanding: 음성뿐만 아니라 환경음, 음악 등 오디오 전반을 이해하고 캡셔닝(Captioning), 시간적 위치 파악(Temporal grounding), 질의응답(QA)을 수행하는 모델의 확장된 기능.
- Instruction-Controlled: 사용자의 명령(Task instruction)과 문맥적 조건(Context, Hotwords)에 따라 모델의 출력을 세밀하게 제어하는 프레임워크.
- FunVerl: 오디오 인식, 발화자 분리, 오디오 이해 등 다양한 태스크를 위해 비동기적 롤아웃(Rollout)과 태스크별 보상(Reward)을 최적화하는 Reinforcement Learning 프레임워크.
- cpWER (Concatenated minimum-permutation word error rate): 다중 발화자 환경에서 발화자 레이블의 임의성에 의존하지 않고 최적의 매칭을 통해 계산한 음성 인식 성능 지표.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 기존 ASR 시스템이 단일 발화자 혹은 텍스트 변환에만 국한되어, 다자간 대화에서의 발화자 식별이나 오디오 내 환경음 인식과 같은 복잡한 오디오 이해 요구사항을 충족하지 못하는 한계를 해결하고자 한다. [Figure 1]에서 제시된 바와 같이, 정확한 전사(Transcription)는 물론 발화자 구조 정보와 오디오 전체 맥락에 대한 이해가 실시간 및 비실기 환경 모두에서 요구되고 있다. 기존 모델들은 각 기능을 별도로 수행해야 하거나 다중 작업 처리에 최적화되지 않은 구조를 가져, 실제 서비스 환경에서의 일관성과 정확도가 저하되는 문제가 발생한다. 따라서 본 논문은 전사, 발화자 분리, 오디오 이해를 통합한 고성능 오디오-언어 모델인 Qwen-Audio-3.1-ASR 패밀리를 제안한다.
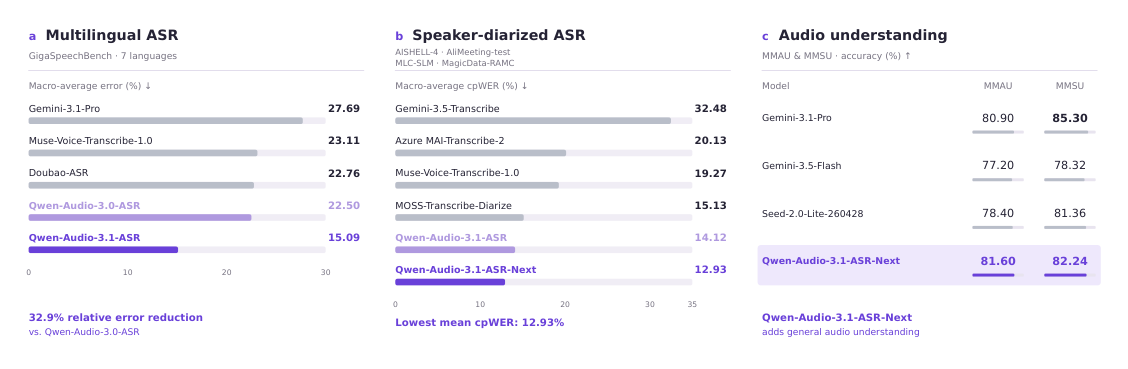
Figure 1 — 모델의 주요 벤치마크 성능을 Multilingual, Speaker-diarized, Audio understanding 세 부분으로 요약한 핵심 결과
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 모델은 Qwen Mixture-of-Experts (MoE) 백본을 기반으로 오디오 인코더와 어댑터를 학습시키고, Supervised Fine-tuning (SFT) 및 Reinforcement Learning (RL) 단계를 거쳐 지시 이행 능력을 강화했다. [Table 1]과 [Table 7]은 모델이 다양한 환경(Streaming, Non-streaming, Speaker-diarized)에서 어떻게 최적화되는지를 보여주며, 특히 FunVerl을 통한 RL 학습은 복잡한 다중 발화 환경에서도 안정적인 성능을 확보하게 한다. 성능 면에서 Qwen-Audio-3.1-ASR은 GigaSpeechBench에서 15.09%의 macro-average CER을 달성하여 이전 버전 대비 뚜렷한 향상을 보였다. 또한, Qwen-Audio-3.1-ASR-Next 모델은 MMAU 및 MMSU 벤치마크에서 우수한 정확도를 입증했으며, 특히 전문적인 오디오 이해 태스크인 CochlScene과 NSynth 등에서 기존 모델들을 큰 폭으로 앞서는 성능을 나타냈다.
Table 7 — 다양한 시스템들과의 Speaker-diarized ASR 성능을 상세히 비교한 결과 표
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 개선된 음성 인식 성능과 함께 구조화된 발화자 전사 및 종합적인 오디오 이해 기능을 하나의 패밀리 모델로 통합함으로써 실용적인 오디오-언어 모델링의 새로운 기준을 제시했다. 제안된 프레임워크는 30개의 언어와 16개의 중국어 방언을 지원하며, 다양한 배포 시나리오에 맞춤화된 기능을 제공하여 산업계의 실제 애플리케이션에 즉각적인 적용이 가능하다. 이러한 연구 결과는 단순히 텍스트를 인식하는 것을 넘어 오디오를 지능적으로 해석하고 대응하는 다중 모달 인터페이스의 발전에 핵심적인 기여를 할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VIBEVOICE-ASR Technical Report
- [논문리뷰] Step-Audio-R1 Technical Report
- [논문리뷰] MiDashengLM: Efficient Audio Understanding with General Audio Captions
- [논문리뷰] PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
- [논문리뷰] From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
Review 의 다른글
- 이전글 [논문리뷰] Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
- 현재글 : [논문리뷰] Qwen-Audio-3.1-ASR Technical Report
- 다음글 [논문리뷰] Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
댓글