[논문리뷰] PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
링크: 논문 PDF로 바로 열기
저자: Qiushi Sun, Jingyang Gong, Yang Liu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Multimodal Code Intelligence: 프로그램의 상징적 세계와 실행 결과로 생성되는 시각적 세계를 연결하는 능력으로, 차트, 웹 페이지, 애니메이션, 반정형 문서 등을 생성하는 모델에 대한 수요 증가와 함께 중요성이 커지고 있습니다.
- PrismaForge: 계층적으로 합성된 Rubric을 중심으로 하는 데이터 파이프라인 프레임워크로, Multimodal Code Data의 큐레이션 및 Policy Optimization에 활용됩니다.
- Rubric (Decomposed Rubric Synthesis): 코드의 정확성, 구성 품질, 시각적 충실도 등 다양한 평가 요소를 분해하여 체크 가능한 기준으로 만든 평가 척도입니다. 각 Rubric은 도메인 공유(Domain-shared) 기준과 샘플 특정(Sample-specific) 기준으로 구성되며, 데이터 필터링과 Reinforcement Learning Reward로 사용됩니다.
- PrismaCoder-2M: PrismaForge를 활용하여 큐레이션된, Multimodal Code Intelligence를 위한 가장 광범위하고 규모가 큰 오픈 데이터셋으로, 12개 이상의 카테고리와 10개 프로그래밍 언어를 포함합니다.
- Reinforcement Learning (RL) Data Curation: Supervised Learning에 사용되는 데이터와는 별도로, 모델의 Capability Boundary 근처에 있는 중간 또는 어려운 난이도의 Instruction을 선별하여 Reinforcement Learning에 활용하는 데이터 큐레이션 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Multimodal Code Intelligence 분야는 텍스트나 스크린샷만으로 인터랙티브한 아티팩트를 생성하는 독점 모델의 발전으로 큰 주목을 받고 있지만, 오픈 소스 분야의 발전은 데이터의 양과 품질, 그리고 이를 생성하는 파이프라인의 부족으로 인해 제약을 받고 있습니다. 기존 데이터셋은 주로 단일 샘플 점수나 Task-specific Verifier에 의존하여 에러에 대한 진단 정보가 제한적이거나 Task 전반에 걸쳐 일반화되지 못하는 한계를 가집니다. 이는 생성된 코드가 구문적으로 올바르더라도 렌더링된 결과의 시각적 정확성, 레이아웃, 의미적 정합성을 보장하지 못하며, 기존의 코드 실행 테스트만으로는 시각적 출력의 충실도를 평가하기 어렵습니다. 본 연구는 이러한 문제를 해결하기 위해, 코드의 정확성, 시각적 품질, 구성적 우수성을 종합적으로 평가할 수 있는 통일된 학습 신호와 고품질의 공개 데이터셋의 필요성에서 출발합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Multimodal Code Data의 큐레이션 및 Policy Optimization을 위한 Rubric-based 프레임워크인 PrismaForge를 제안합니다. PrismaForge는 Instruction당 하나의 Rubric을 생성하며, 이 Rubric은 Code Level과 Visual Level 기준으로 분해되어 데이터 필터링과 Reinforcement Learning Reward로 활용됩니다 [Figure 2]. 특히, Elastic Rubric Scorer는 도메인 공유(Domain-shared) 기준과 샘플 특정(Sample-specific) 기준을 결합하여 다양한 Task에 유연하게 대응하며, Code Rubric과 Vision Rubric을 별도로 평가하여 코드 검사나 Holistic Judge로는 놓치기 쉬운 시각적 오류를 효과적으로 포착합니다 [Figure 3].
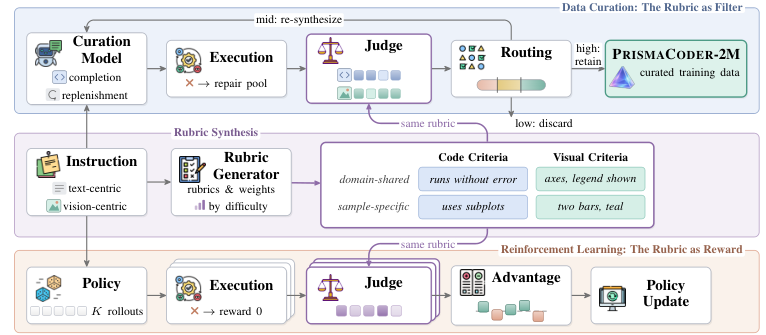
Figure 2 — PrismaForge 파이프라인 개요
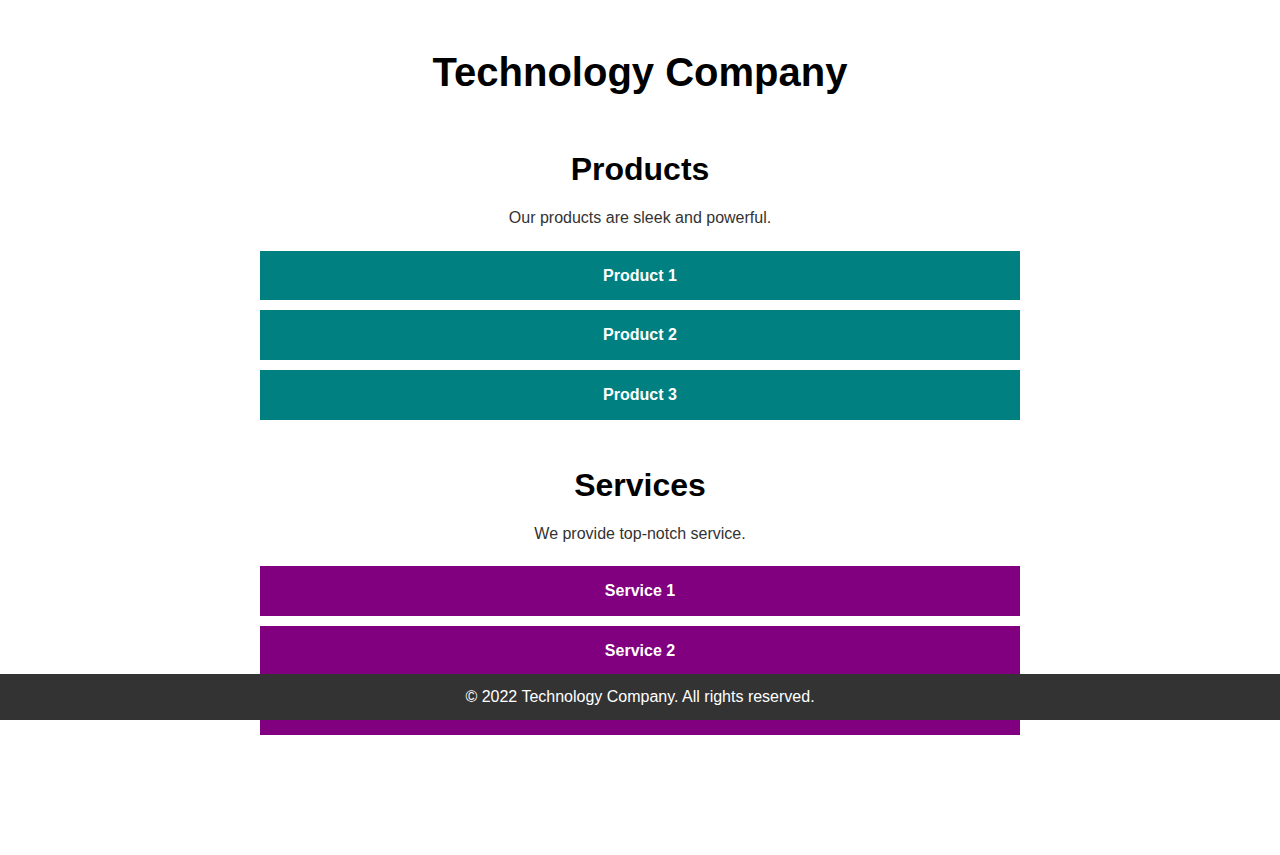
Figure 3 — Rubric 기반 스코어링의 효과
PrismaForge를 통해 큐레이션된 PrismaCoder-2M은 현재까지 가장 광범위하고 큰 규모의 오픈 Multimodal Code Intelligence 데이터셋으로, 12개 이상의 카테고리와 10개 프로그래밍 언어를 포괄합니다 [Table 1, Figure 4]. 이 데이터셋을 기반으로 훈련된 PrismaCoder-9B 및 PrismaCoder-35B 모델은 광범위한 벤치마크에서 기존 오픈 소스 모델들을 크게 능가하며, 여러 측면에서 선도적인 독점 시스템에 필적하는 성능을 달성합니다. 예를 들어, ChartMimic 벤치마크에서 PrismaCoder-35B는 82.05의 Overall Score를 달성하여 대부분의 독점 모델을 능가했습니다 Table 8. 또한, WebCode2M의 Visual Score에서 PrismaCoder-9B는 90.41을 기록하며 기존 오픈 모델 대비 20점 이상 높은 성능을 보였습니다 Table 14. ChemDraw 벤치마크에서는 PrismaCoder-35B가 97.56의 Tanimoto Similarity를 달성하며 모든 출력의 유효성을 보장했습니다 Table 13. 분석 결과, Rubric-guided Curation은 Direct-Judge Selection보다 모든 벤치마크에서 우수한 성능을 보였으며, 최대 Vega-Lite에서 24점 높은 점수를 기록했습니다 [Figure 5]. 또한, Rubric Score는 인간의 판단과 높은 일치도를 보여 Krippendorff's α가 0.86–0.92, Kendall's τb가 0.64–0.67에 달했습니다 [Figure 7, Table 20].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 데이터, 파이프라인, 모델을 완전하게 공개함으로써 오픈 Multimodal Code Intelligence 분야의 발전을 크게 앞당겼습니다. PrismaForge는 Code Level 및 Visual Level 기준으로 분해된, Fine-grained Rubric을 통해 문제를 진단하고 일반화하는 평가 신호를 제공하며, 이를 통해 Multimodal Code Data를 효과적으로 큐레이션하고 Reinforcement Learning을 안정화합니다. 이 파이프라인으로 구축된 PrismaCoder-2M 데이터셋과 PrismaCoder-9B/35B 모델은 현재 오픈 소스 분야의 State-of-the-Art 성능을 크게 뛰어넘으며, 선도적인 독점 시스템과 경쟁할 수 있는 수준에 도달했습니다. 이러한 연구는 Multimodal Code Intelligence 분야에서 고품질 데이터 구축의 중요성을 강조하고, 연구자들이 시각 코딩 능력에 더 쉽게 접근하고 발전시킬 수 있도록 하는 중요한 기반을 제공합니다.
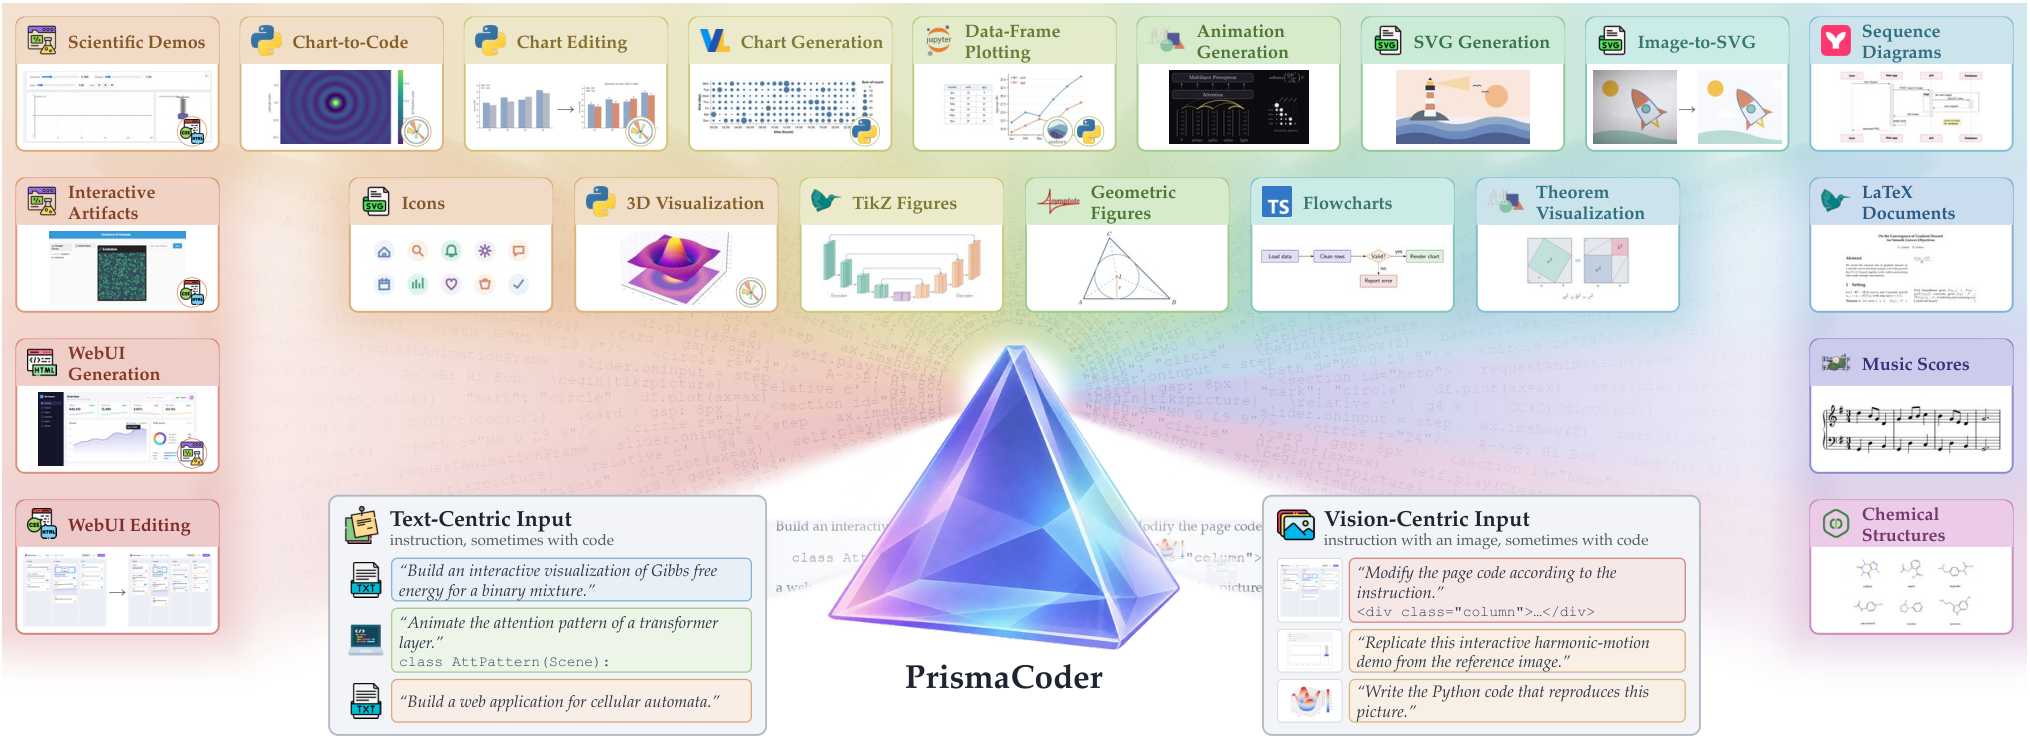
Figure 1 — PrismaCoder 커버 시나리오 및 포맷
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
- [논문리뷰] Beacon: Knowing When and How to Perform Agentic Visual Reasoning
- [논문리뷰] OpenThoughts-Agent: Data Recipes for Agentic Models
- [논문리뷰] Combinatorial Synthesis: Scaling Code RLVR via Atomic Decomposition and Recombination
- [논문리뷰] Solvita: Enhancing Large Language Models for Competitive Programming via Agentic Evolution
Review 의 다른글
- 이전글 [논문리뷰] PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
- 현재글 : [논문리뷰] PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
- 다음글 [논문리뷰] Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
댓글