[논문리뷰] PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
링크: 논문 PDF로 바로 열기
저자: Patrick Haller, Filipe Laitenberger, Alan Akbik
1. Key Terms & Definitions
- Recurrent State: Linear-attention Language Models (LLMs)에서 Transformer의 Key-Value (KV) cache를 대체하는 고정된 크기의 context representation입니다. 각 head마다 하나의 state matrix가 존재하며, inference system은 decoding 중인 각 sequence마다 이 state의 사본을 저장합니다.
- State Quantization: Recurrent state를 더 낮은 precision (예: 4-bit)으로 저장하여 memory footprint를 줄이는 기술입니다. 이는 동일한 accelerator에서 더 많은 sequence를 동시에 처리할 수 있도록 합니다.
- Decode Buffer: Periodic rounding 중에 사용되는 작은 저장소로, 마지막 rounding 이후 생성된 tokens의 keys와 values를 임시로 보관합니다. 이를 통해 state는 매 token이 아니라
dP(decode period) token마다 한 번씩 업데이트됩니다. - Periodic Rounding: 기존의 매 token마다 state를 rounding하는 방식 대신,
dP개의 token이 생성될 때마다 한 번씩 state를 rounding하는 기법입니다. 이는 recurrent state에 누적되는 rounding error를 감소시킵니다. - Delta Value (ut): Gated delta rule에서
St = at * St-1 + kt * ut^T수식에 나타나는ut값으로,kt에 대해 decayed state가 아직 반환하지 않은vt의 부분을βt로 scaling한 것입니다. Recurrent state 내 큰 값들이 column을 형성하는 원인이 됩니다.
2. Motivation & Problem Statement
Linear-attention Language Models는 고정된 크기의 recurrent state를 사용하여 Transformer의 Key-Value cache를 대체하지만, 여러 concurrent sequence를 처리할 때 이 state가 상당한 memory를 차지하게 됩니다. 이러한 memory 제약으로 인해 더 많은 sequence를 동일한 accelerator에 탑재하기 위해서는 state를 더 낮은 precision으로 저장하는 state quantization이 필수적입니다. 기존의 4-bit state quantizer들은 매 생성 token마다 state를 rounding할 경우 accuracy 손실이 발생하며, 이를 해결하기 위해 bit width를 8-bit로 높이거나 model fine-tuning이 필요하다는 한계를 보고했습니다. 본 연구는 기존 방법론들이 겪는 4-bit state quantization의 accuracy 손실 문제를 post-hoc (fine-tuning 없이) 해결하고, memory 효율성을 높이며, decoding 성능을 유지하는 새로운 접근 방식이 필요함을 지적합니다. 특히, 기존 quantizer들은 rounding 주기가 짧고 (매 token) recurrent state의 내재적인 channel structure를 충분히 활용하지 못했습니다.
3. Method & Key Results
본 논문은 post-hoc 4-bit state quantizer인 PACE (Periodic And Channel-aligned state Encoding)를 제안합니다. PACE는 세 가지 핵심 구성 요소를 통해 기존의 한계점을 극복합니다. 첫째, Periodic Rounding with a Decode Buffer를 도입하여 state를 매 token 대신 dP (decode period)개의 token마다 한 번씩 rounding합니다 [Figure 2]. 이 방법은 rounding 사이에 더 많은 decay가 발생하여 각 rounding error가 state에 덜 남아있게 함으로써 누적 error Eh = eh / (1 - ah^(2*dP))를 감소시킵니다. dP가 길어질수록 retained error는 감소하며, head의 decay가 클수록 error는 증가한다는 점을 활용합니다. 둘째, Channel-Aligned Scale Groups를 사용합니다 [Figure 2]. 저자들은 gated-delta state의 큰 entry들이 delta value (ut)의 특정 channel들이 많은 token에 걸쳐 크게 유지됨에 따라 column 형태로 모여있음을 발견했습니다 [Figure 3]. PACE는 이 관찰을 기반으로 각 quantization scale group을 하나의 column (key axis를 따라)에서 형성하여, 기존의 value axis를 따라 그룹화하는 방식보다 outlier에 의한 quantization step size 확장을 방지합니다. 셋째, Head-Level Precision Allocation을 적용합니다 [Figure 2]. PACE-4/8 variant는 rounding error를 가장 오랫동안 유지하는 head들의 ¼을 8-bit precision으로 유지하고, 나머지는 4-bit로 처리하여 accuracy를 최적화합니다.
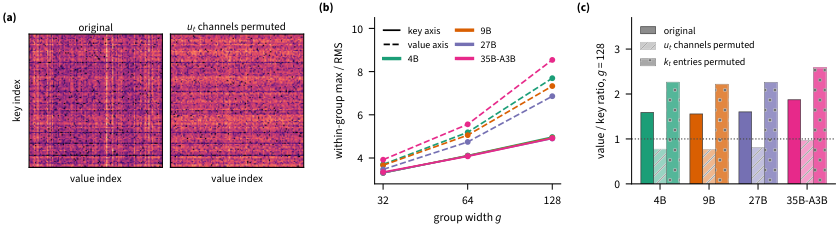
Figure 3 — Recurrent State의 Column 구조
주요 실험 결과는 다음과 같습니다:
- Periodic Rounding의 효과: dP=8 (8개의 token마다 rounding)을 사용할 경우, 모든 4-bit 미만 bit width에서 per-token rounding 대비 accuracy 손실이 감소합니다. 이는 특히 Qwen3.5-4B 모델에서 INT4, dP=1이 IFEval 61.4%를 기록한 반면, INT4, dP=8은 73.0%로 향상된 것을 통해 확인할 수 있습니다.
- 성능 및 메모리 효율성:
- PACE-4/8 (mixed 4-bit 및 8-bit heads)는 DAMP INT8과 비교했을 때 세 개의 더 큰 모델 (Qwen3.5-9B, 27B, Qwen3.6-35B-A3B)에서 유사한 accuracy를 보이면서도, DAMP INT8의 약 2/3 수준의
resident memory를 사용합니다. 예를 들어, Qwen3.5-27B 모델에서 PACE-4/8은 6.82 resident bits/value로 87.3%의 평균 점수를 기록하며, DAMP INT8의 9.90 resident bits/value에서의 87.4%와 거의 동등한 성능을 보였습니다 [Table 1]. - PACE-4는 Q-Mamba DSQ와 동일한
resident bits에서 모든 backbone에서 더 높은 점수를 달성했습니다 [Table 1]. Qwen3.5-27B에서 PACE-4는 5.03 resident bits/value로 평균 84.2%를 기록하며, Q-Mamba DSQ의 78.9%를 크게 상회했습니다.
- PACE-4/8 (mixed 4-bit 및 8-bit heads)는 DAMP INT8과 비교했을 때 세 개의 더 큰 모델 (Qwen3.5-9B, 27B, Qwen3.6-35B-A3B)에서 유사한 accuracy를 보이면서도, DAMP INT8의 약 2/3 수준의
- Throughput 유지: Periodic rounding은 decode buffer의 decoding speedup을 유지하며, periodic INT4 decoding은 batch 16 이상에서 per-token bf16 decoding보다 낮은 Time Per Output Token (TPOT)을 보였습니다 [Figure 6].
4. Conclusion & Impact
본 논문은 gated-delta 모델을 위한 post-hoc 4-bit state quantizer인 PACE를 성공적으로 제안했습니다. PACE는 state를 일정 주기마다 (periodic) rounding하고, 그 사이에 생성된 token들을 decode buffer에 유지하는 방식과, delta value의 channel 구조를 활용한 channel-aligned scale groups를 통해 기존 4-bit quantization의 accuracy 손실 문제를 효과적으로 해결했습니다. 연구 결과, 8 token의 rounding 주기는 8-bit 미만의 모든 bit width에서 accuracy 손실을 감소시켰으며, 이는 rounding 주기와 head의 decay 간의 관계에 대한 이론적 bound와 일치합니다. 또한, recurrent state의 큰 entry들이 delta value channel에 따라 column을 형성한다는 발견은 key-axis 기반의 channel-aligned quantization 방법론의 효과를 입증했습니다. 최종적으로, PACE-4/8은 DAMP INT8에 버금가는 accuracy를 제공하면서도 약 2/3의 resident memory만을 필요로 하며, PACE-4는 동일 메모리에서 Q-Mamba DSQ보다 우수한 성능을 보였습니다. 이 연구는 linear-attention 모델의 efficient inference를 가능하게 하여, 특히 제한된 컴퓨팅 자원을 가진 환경에서의 LLM 배포에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DLite: History-free Speculative Decoding for Agentic AI
- [논문리뷰] GroundAnything: Reconciling Parallel Decoding with Precise Visual Grounding at Flash Speed
- [논문리뷰] STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
- [논문리뷰] SlimWise: Decoupling Expert Pruning Across Prefill and Decode for Efficient MoE Serving
- [논문리뷰] AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines
Review 의 다른글
- 이전글 [논문리뷰] Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
- 현재글 : [논문리뷰] PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
- 다음글 [논문리뷰] PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
댓글