[논문리뷰] Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
링크: 논문 PDF로 바로 열기
저자: Yanzhe Chen, Ziyi Yang, Jifeng Zhu, Qiming Huang, Ruihe An, Peiyao Xu, Hesen Yang, Runda Liu, Chang Gong, Zhijun Cao, Zechen Bai, Wenzheng Zeng, Yiqi Lin, Guoqiang Liang, Kevin Yuchen Ma, Kevin Qinghong Lin, et al.
1. Key Terms & Definitions
- Multimodal Agents (MMAs): Reasoning, memory, tools, and feedback를 통해 상호작용하며, 주로 컴퓨터 환경에서 작동하는 agent를 지칭합니다.
- Robotic Systems (RSs): 물리적 dynamic 하에서 sensing과 actuation을 결합하는 시스템입니다.
- Multimodal Embodied Agents (MMEAs): Multimodal task reasoning을 physical action과 결합하고, 그 결과로부터의 feedback을 통해 의사결정을 수정하는 goal-directed system입니다.
- PAPAV Framework: MMEA의 핵심 기능을 Perceive, Anticipate, Plan, Act, Verify의 다섯 가지 재귀적 함수로 정의한 capability-centric framework입니다.
- Task Loop: Agent가 한 번에 한 단계씩 task를 진행하는 cycle을 의미하며, PAPAV 프레임워크의 5가지 기능이 이 루프 내에서 작동합니다.
2. Motivation & Problem Statement
본 논문은 multimodal agent가 컴퓨터 활용(computer-use) 환경에서 로봇 활용(robot-use) 환경으로 전환될 때 발생하는 변화에 대한 핵심 질문을 해결하고자 합니다. 기존 Multimodal Agents (MMAs)는 주로 소프트웨어 인터페이스에 의존하며 구조화된 상태 및 직접적인 디지털 feedback을 활용했지만, Robotic Systems (RSs)는 알려진 운영 환경에 맞춰진 고정된 제약 조건에 의존했습니다. 이러한 기존 접근 방식의 한계는 open-ended physical interaction에서 agent가 덜 예측 가능하고 오류 수정이 어려워지는 환경에 직면한다는 점입니다. 특히, 기존 설문조사 분류는 컴퓨터 활용 agent는 computational architecture와 digital interaction에, embodied AI 및 로봇 자율성 설문조사는 physical task와 execution에 중점을 두어, 두 도메인 간의 동일한 기능이 물리적 결과에 따라 어떻게 변하는지에 대한 통일된 비교 기준이 부족합니다. 이 연구는 이러한 간극을 해소하고, 복잡한 물리적 환경에서 reliable한 agent를 설계하며, task 성공뿐만 아니라 5가지 핵심 capability 전반에 걸친 진행 상황을 측정하기 위한 공통 기반을 제공합니다.
3. Method & Key Results
저자들은 Multimodal Embodied Agents (MMEAs)의 핵심 역량을 분석하기 위해 PAPAV라는 unified capability-centric framework를 제안합니다. 이 프레임워크는 Perceive, Anticipate, Plan, Act, Verify의 다섯 가지 재귀적 기능적 역할을 정의하며, 각 기능은 architecture가 아닌 task loop 내에서의 기여도를 중심으로 정의됩니다. 이를 통해 MMAs, RSs, MMEAs의 공통점과 차이점을 기능적 관점에서 비교할 수 있습니다. [Figure 1] [Figure 4]
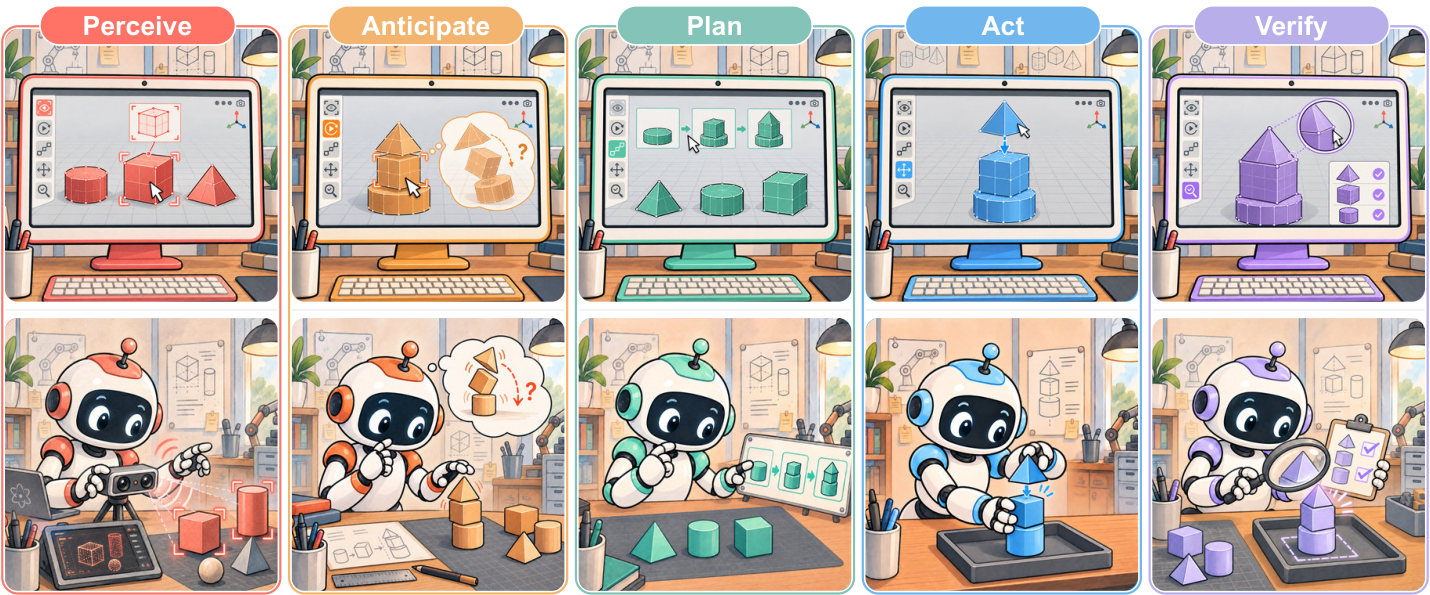
Figure 1 — 제안된 PAPAV 프레임워크의 개요
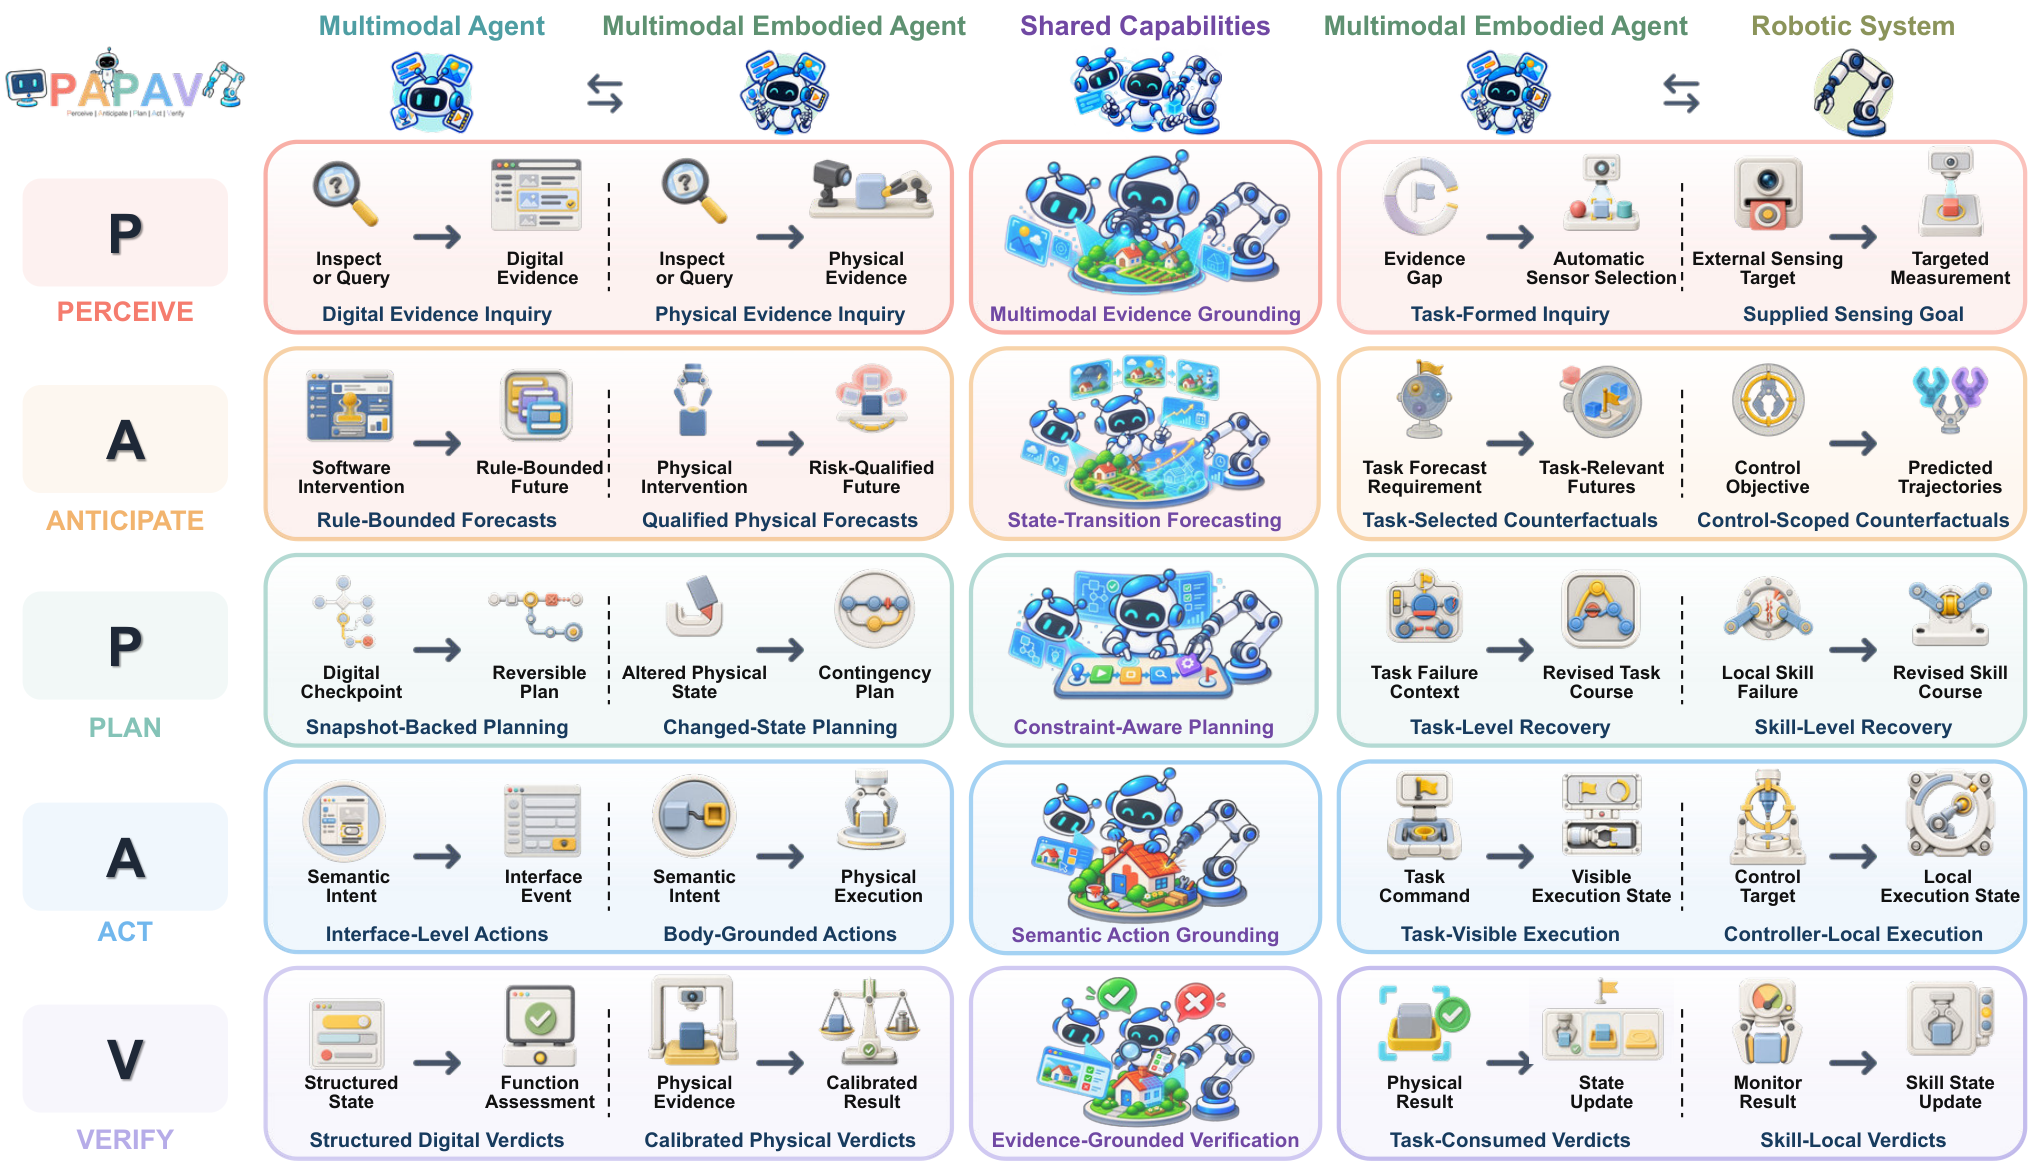
Figure 4 — PAPAV 프레임워크의 기능별 비교
PAPAV 프레임워크는 MMEA가 물리적 환경에서 마주하는 5가지 주요 제약 사항(partial observability, limited simulatability, irreversibility, real-time coupling, unverifiable outcomes)을 중심으로 각 capability의 구현 방식이 어떻게 변화하는지 분석합니다. 예를 들어, Perceive 기능에서 MMEA는 partial observability 하에 object-centric memory나 active-perception policies를 활용하여 task-relevant belief를 유지하고 수정해야 합니다. Anticipate 기능에서는 limited simulatability로 인해 완전하고 신뢰할 수 있는 물리적 시뮬레이터가 없으므로, 예측은 uncertainty, risk, applicability에 의해 qualified되어야 합니다. Plan 기능에서는 physical irreversibility로 인해 spatial, temporal, safety constraints를 만족하는 action selection 및 ordering이 필수적이며, 실행 후 변경된 물리적 상태로부터의 recovery planning이 중요합니다. Act 기능은 compact한 agent-facing operation 대신 body-grounded execution을 요구하며, task process가 실행 진행 상황에 계속 접근할 수 있도록 하는 bidirectional execution contract가 필요합니다. 마지막으로 Verify 기능은 physical interaction에서 독립적이고 완전히 관찰 가능한 success signal이 부족하기 때문에, task-general belief와 goal-specific criteria를 비교하여 physical verdict를 제공해야 합니다.
저자들은 64개의 벤치마크(MMEA 10개, MMA 23개, RS 31개)를 분석하여 PAPAV capability coverage를 평가했습니다 [cite: 1, Table 2]. 분석 결과, Act capability는 MMEA 100%, MMA 70%, RS 94%로 가장 강력한 explicit coverage를 보였습니다 [cite: 1, Table 2]. 반면, Anticipate와 Verify capability는 각각 8%와 5%만이 명시적으로 평가되어, 대부분의 경우 task 성공 뒤에 implicitly evaluated되는 것으로 나타났습니다 [cite: 1, Table 2]. Plan capability는 MMEA 벤치마크의 70%에서 명시적으로 평가되었지만, MMA와 RS 벤치마크에서는 각각 70%와 42%에서 implicit하게 평가되거나 아예 평가되지 않았습니다 [cite: 1, Table 2]. 이는 현재 벤치마크들이 agent의 실제 행동(Act)에 집중하고 있으며, 예측(Anticipate) 및 검증(Verify)과 같은 critical한 추론 과정에 대한 진단적 평가가 부족함을 시사합니다. 이러한 결과는 PAPAV 프레임워크가 agent design 및 benchmark 개발에 필요한 capability bottleneck을 식별하는 데 효과적임을 보여줍니다 [cite: 1, Figure 10].
4. Conclusion & Impact
본 논문은 Multimodal Embodied Agents (MMEAs)가 computer-use 환경에서 robot-use 환경으로 전환될 때 발생하는 변화를 PAPAV (Perceive, Anticipate, Plan, Act, Verify) 프레임워크를 통해 포괄적으로 분석했습니다. 결론적으로, embodiment는 task loop를 보존하지만, partial observability, limited simulatability, irreversibility, real-time coupling, unverifiable outcomes와 같은 5가지 물리적 제약 조건을 부과하여 agent의 의사결정 과정을 더욱 복잡하게 만듭니다. 이는 agent가 스스로 belief를 유지하고, 예측을 보정하며, commit을 승인하고, 실행을 모니터링하며, 물리적 결과에 따라 결과를 검증하는 방식에 대한 신뢰성을 중요하게 만듭니다.
이 연구는 해당 분야에 두 가지 중요한 시사점을 제공합니다. 첫째, PAPAV 프레임워크는 MMAs, RSs, MMEAs 간의 기능적 비교를 위한 통일된 기반을 제공하여, 아키텍처나 구현 방식에 관계없이 agent의 핵심 역량을 명확하게 이해하는 데 기여합니다. 둘째, 64개 벤치마크에 대한 분석을 통해, 현재 평가가 주로 Act capability에 집중되어 있으며 Anticipate 및 Verify와 같은 핵심 추론 capability가 간과되고 있음을 밝혀냈습니다 [cite: 1, Figure 10]. 이는 향후 reliable한 물리적 agent를 설계하고, task 성공뿐만 아니라 전반적인 interaction loop에 걸친 진행 상황을 측정하기 위해 capability-level 테스트와 end-to-end task를 결합하는 새로운 벤치마크 설계의 필요성을 강조합니다. 궁극적으로 이 연구는 embodied AI 분야의 발전과 실제 환경에서의 agent 배포를 위한 체계적인 가이드라인을 제시합니다.
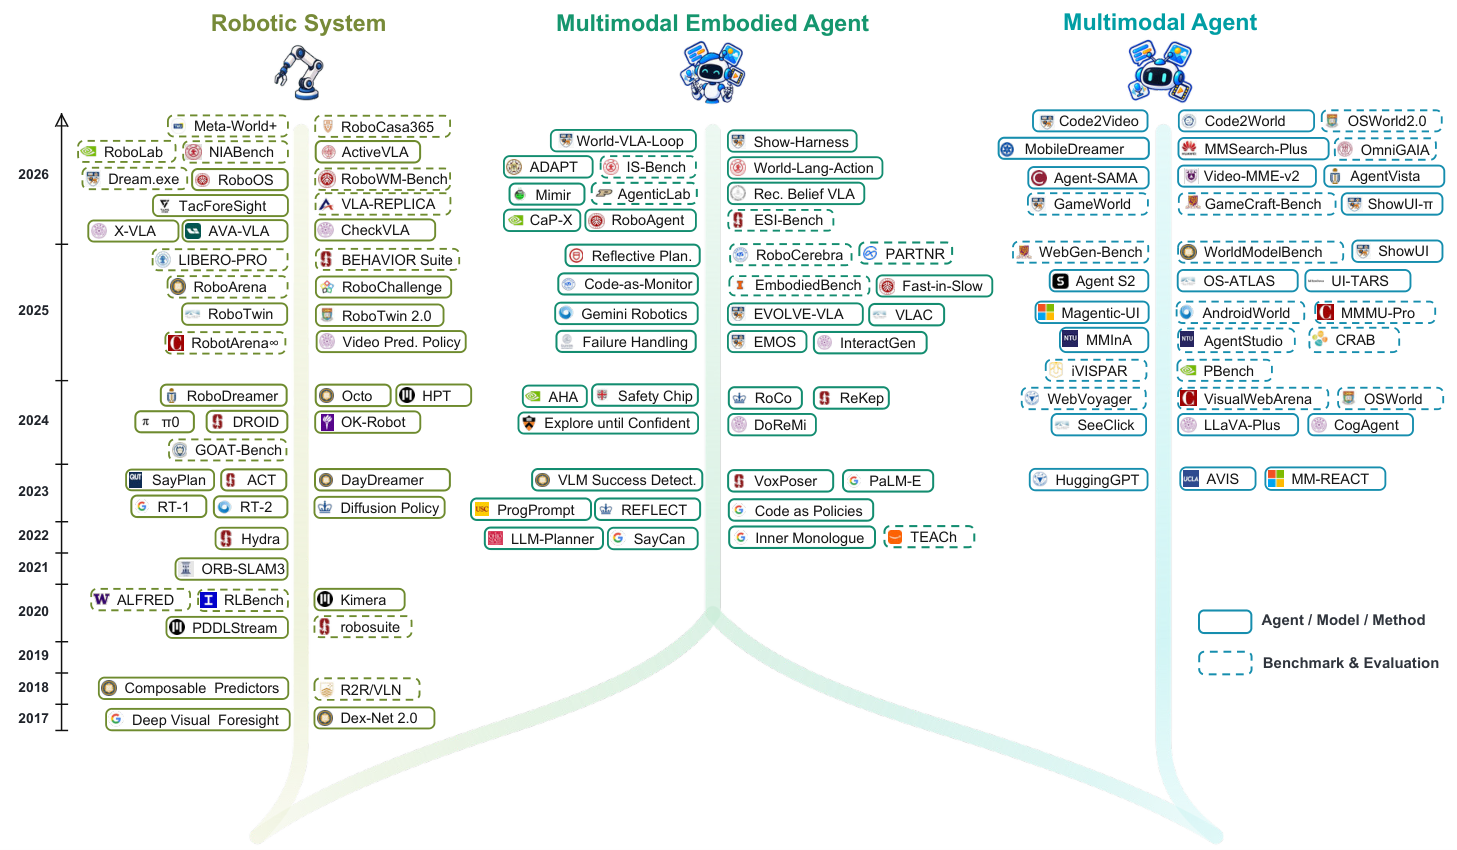
Figure 2 — 대표 연구의 연대별 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
- [논문리뷰] OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
- [논문리뷰] CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering
- [논문리뷰] CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design
- [논문리뷰] GUI-Primitives: Diagnosing Spatial Reasoning Failures in Vision-Language GUI Grounding
Review 의 다른글
- 이전글 [논문리뷰] Memory-Centric Continual Learning for AI Agents
- 현재글 : [논문리뷰] Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use
- 다음글 [논문리뷰] PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
댓글