[논문리뷰] CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering
링크: 논문 PDF로 바로 열기
메타데이터
저자: Prince Zizhuang Wang, Chenhao Liang, Zelong Xu, Aojie Yuan, Xiaolin Zhou, Haiyue Zhang, Yue Zhao, Xiyang Hu, Shuli Jiang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- CUA-SWE: 소프트웨어 공학 작업에서 컴퓨터 사용(Computer-Use) 능력을 평가하기 위해 설계된 벤치마크이자 환경 및 평가 파이프라인.
- Hybrid CUA: 기존의 소스 코드 수정뿐만 아니라, 스크린샷 시각화 및 GUI 기반 상호작용을 통해 소프트웨어를 제어하고 검증하는 에이전트 운용 방식.
- Patch Correctness ($V_u$): 제안된 코드 변경이 작업 요구사항을 만족하고, 기존 기능을 유지하며, 허용된 수정 범위 내에 있는지를 검증하는 결정론적 테스트 프로토콜.
- Specification Basis: 작업 요구사항이 소스 코드에 명시적인지(Source-specified) 아니면 실행 중인 애플리케이션의 시각적 정보나 외부 인터페이스에 의존하는지(Application-material-dependent)를 구분하는 기준.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 소프트웨어 공학 에이전트가 코드 수정과 실행 결과 확인이라는 고립된 환경에서만 연구되는 한계를 해결하고자 한다 [Figure 1]. 실제 개발 과정에서는 애플리케이션을 직접 실행하고 GUI를 통해 시각적으로 문제를 진단하며, 상호작용을 통해 코드 변경의 효과를 검증하는 과정이 필수적이다. 기존의 Code-only 접근 방식은 런타임 환경에서만 발생하는 시각적 오류나 복잡한 사용자 인터페이스 기반의 상호작용 실패를 감지하고 복구하는 데 한계가 있다. 따라서 저자들은 시각적 GUI 피드백과 소스 코드 레벨의 수정 능력을 결합한 통합적인 개발 환경이 필요하다고 정의한다 [Figure 2].
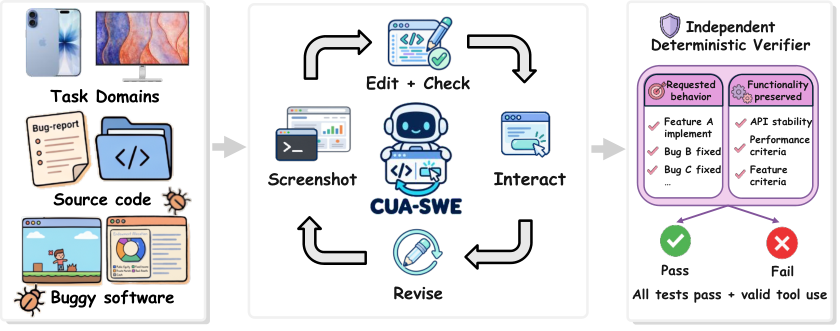
Figure 1 — CUA-SWE 벤치마크 개요
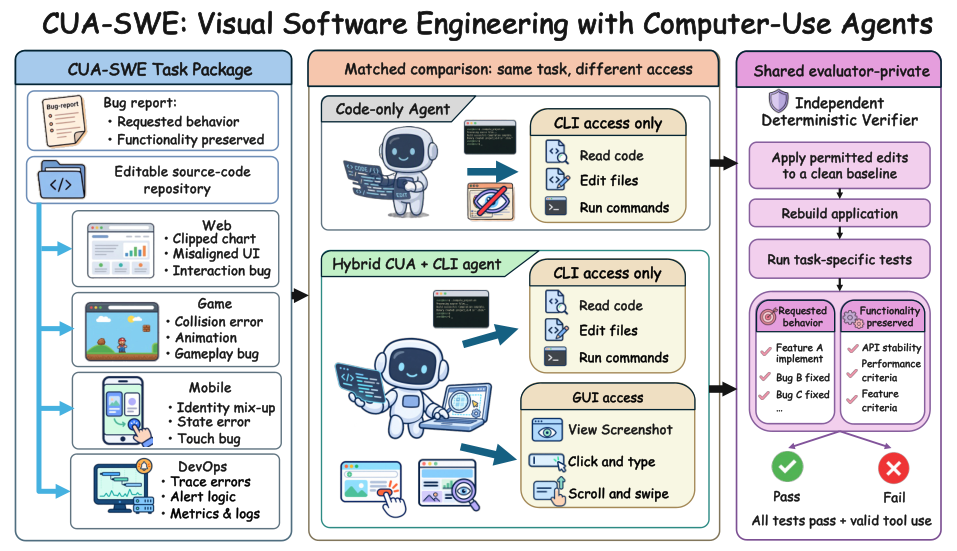
Figure 2 — 개발 및 평가 파이프라인
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Web, Game, DevOps, Mobile 등 4개 소프트웨어 도메인을 아우르는 105개의 작업으로 구성된 CUA-SWE 벤치마크를 제안한다. 에이전트는 제공된 Editable Codebase를 수정하고, 마우스와 키보드 입력 등을 통해 실행 중인 애플리케이션을 제어하며, 런타임 피드백을 통해 문제를 진단한다 [Figure 3]. 제안된 Hybrid CUA 모델은 GUI 시각적 정보와 코드 실행 환경을 결합함으로써, 정보가 제한된 환경에서도 복구 성능이 유의미하게 향상됨을 입증하였다 [Figure 4]. 실험 결과, Hybrid CUA는 복잡한 시각적 의존성이 있는 작업에서 Code-only 에이전트 대비 높은 Task Success 비율을 기록하였으며, 특히 런타임 상태를 GUI를 통해 재확인해야 하는 작업군에서 강력한 성능 우위를 보였다 [Figure 5]. 구체적으로, 통합 인터페이스를 사용한 에이전트는 추론 단계에서의 오류를 시각적 단서를 통해 수정함으로써 Patch Correctness를 대폭 개선하였다.
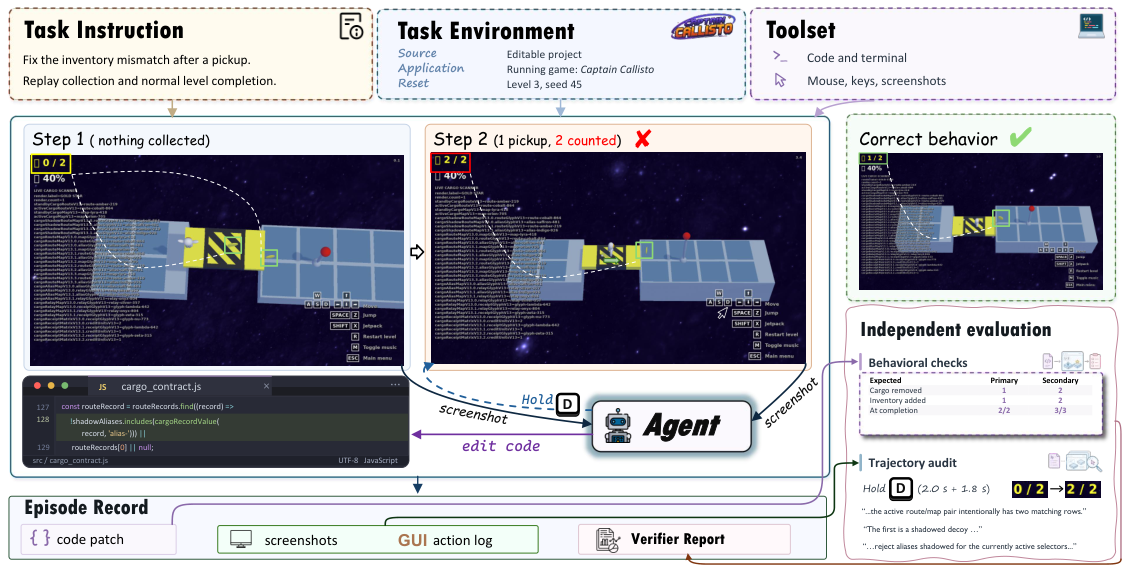
Figure 3 — 작업 수행 예시: 게임
4. Conclusion & Impact (결론 및 시사점)
본 논문은 시각적 GUI 피드백과 소스 코드 수정을 결합한 CUA-SWE 환경을 통해 에이전트의 실질적인 소프트웨어 공학 능력을 정량적으로 평가하였다. 연구 결과, 시각적 환경과 상호작용할 수 있는 에이전트가 그렇지 않은 모델보다 복잡한 개발 요구사항을 이해하고 해결하는 데 훨씬 효과적임을 확인하였다. 이 연구는 미래의 자율적 소프트웨어 에이전트가 사람이 사용하는 도구와 인터페이스를 인간처럼 다루며 개발을 수행하는 방향으로 나아가는 중요한 이정표를 제시한다. 본 벤치마크는 학계와 산업계 모두에서 컴퓨터 사용 능력을 갖춘 지능형 에이전트의 성능 향상을 견인할 수 있는 표준화된 평가 지표로 활용될 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OSWorld2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks
- [논문리뷰] ProgramDistill: From Interactive Web Apps to Verifiable Reference-Guided SWE Tasks
- [논문리뷰] Φ-Bench: Can Large Language Models Engineer the Infrastructure That Powers Them?
- [논문리뷰] RealSWE: A Compositional Evaluation of Coding Agents under Realistic User Requests
- [논문리뷰] HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?
Review 의 다른글
- 이전글 [논문리뷰] Breaking Babel: A Self-Evolving Multi-Agent System for Long-Form Subtitle Translation
- 현재글 : [논문리뷰] CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering
- 다음글 [논문리뷰] DAGent: Evaluate-then-Grow Planning for Deep Research Agents
댓글