[논문리뷰] DAGent: Evaluate-then-Grow Planning for Deep Research Agents
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hanwen Liu, Yuanfu Sun, Qiaoyu Tan, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Evaluate-then-Grow: 전체 계획을 사전에 수립하지 않고, 노드별 완료 상태를 평가(Evaluate)한 뒤 다음 확장 단계를 결정(Grow)하는 점진적 Planning 기법입니다.
- DAGent: Deep Research를 위해 DAG(Directed Acyclic Graph) 구조를 기반으로 설계된 Multi-Agent Framework로, 효율적인 하위 작업 분할과 실행을 지원합니다.
- DAGRPO: GRPO(Group Relative Policy Optimization)를 DAG 구조에 맞게 최적화한 강화학습 기법으로, 토폴로지 기반 크레딧 할당과 구조적 규제를 통해 성능을 개선합니다.
- QueryDoc: 각 노드 실행 후 생성되는 구조화된 요약 데이터로, 후속 노드로 전달되는 Compact한 Context입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
- 본 논문은 기존의 Plan-then-Patch 전략이 가진 취약성을 해결하고, 복잡한 Deep Research 작업의 효율성을 극대화하기 위해 제안되었습니다.
- 기존 연구들은 작업 수행 전 전체 DAG를 고정하거나(Static planning), 실행 중 실패 발생 시에만 수정하는 방식에 의존하여, 초기 이해도가 낮은 시점에 너무 큰 계획을 고정하는 비효율을 겪습니다.
- 이러한 방식은 불필요한 연산 낭비를 초래하고, 작업의 복잡도가 증가할수록 정확도(Accuracy)를 저하시키는 결과를 낳습니다.
- 이에 저자들은
[Figure 1]에서 제시된 바와 같이, 증거 기반으로 계획을 확장하는 새로운 패러다임이 필요함을 역설합니다.
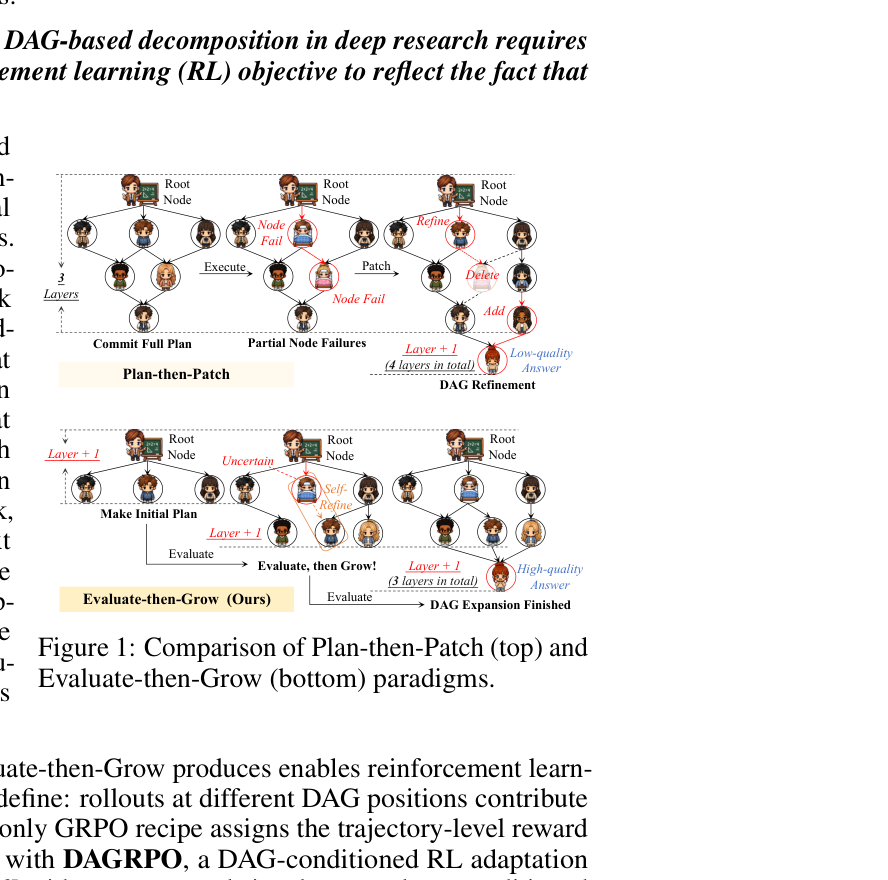
Figure 1 — 본 논문의 핵심 방법론인 계획 방식의 차이를 직관적으로 보여주는 비교 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
- 본 논문은 Evaluate-then-Grow planning과 계층적 Context 전달 체계를 통해 효율적인 Deep Research를 수행하는 DAGent 프레임워크를 제안합니다.
- Orchestrator는 각 노드의 완료 후 confidence 및 uncertainty 신호를 분석하여 다음 단계의 노드를 점진적으로 확장하며, Selective Propagation을 통해 노드별 Context 부담을 최소화합니다.
- DAGRPO 기법은
[Figure 2]하단에 나타난 바와 같이, DAG 토폴로지를 활용하여 최종 정답 도출에 기여한 경로의 노드에 더 높은 크레딧을 할당하고, 구조적 준수(Structural compliance) 규제를 통해 Orchestrator의 계획 품질을 제고합니다. - 실험 결과, DAGent는 BrowseComp-Plus, GAIA, xbench-DeepSearch 벤치마크에서 Qwen3-235B-A22B 기준으로 기존 최강 베이스라인 대비 각각 5.3 / 5.8 / 2.0 포인트 높은 Pass@1 정확도를 기록했습니다.
- 또한 Qwen3-8B 규모에서 DAGRPO는 기존 Outcome-only GRPO 베이스라인 대비 평균 3.0 포인트 이상의 향상을 보이며, 연산 자원 효율성 면에서도 Plan-then-Patch 대비 낮은 Token 및 Tool-call Footprint를 달성했음을 입증했습니다.
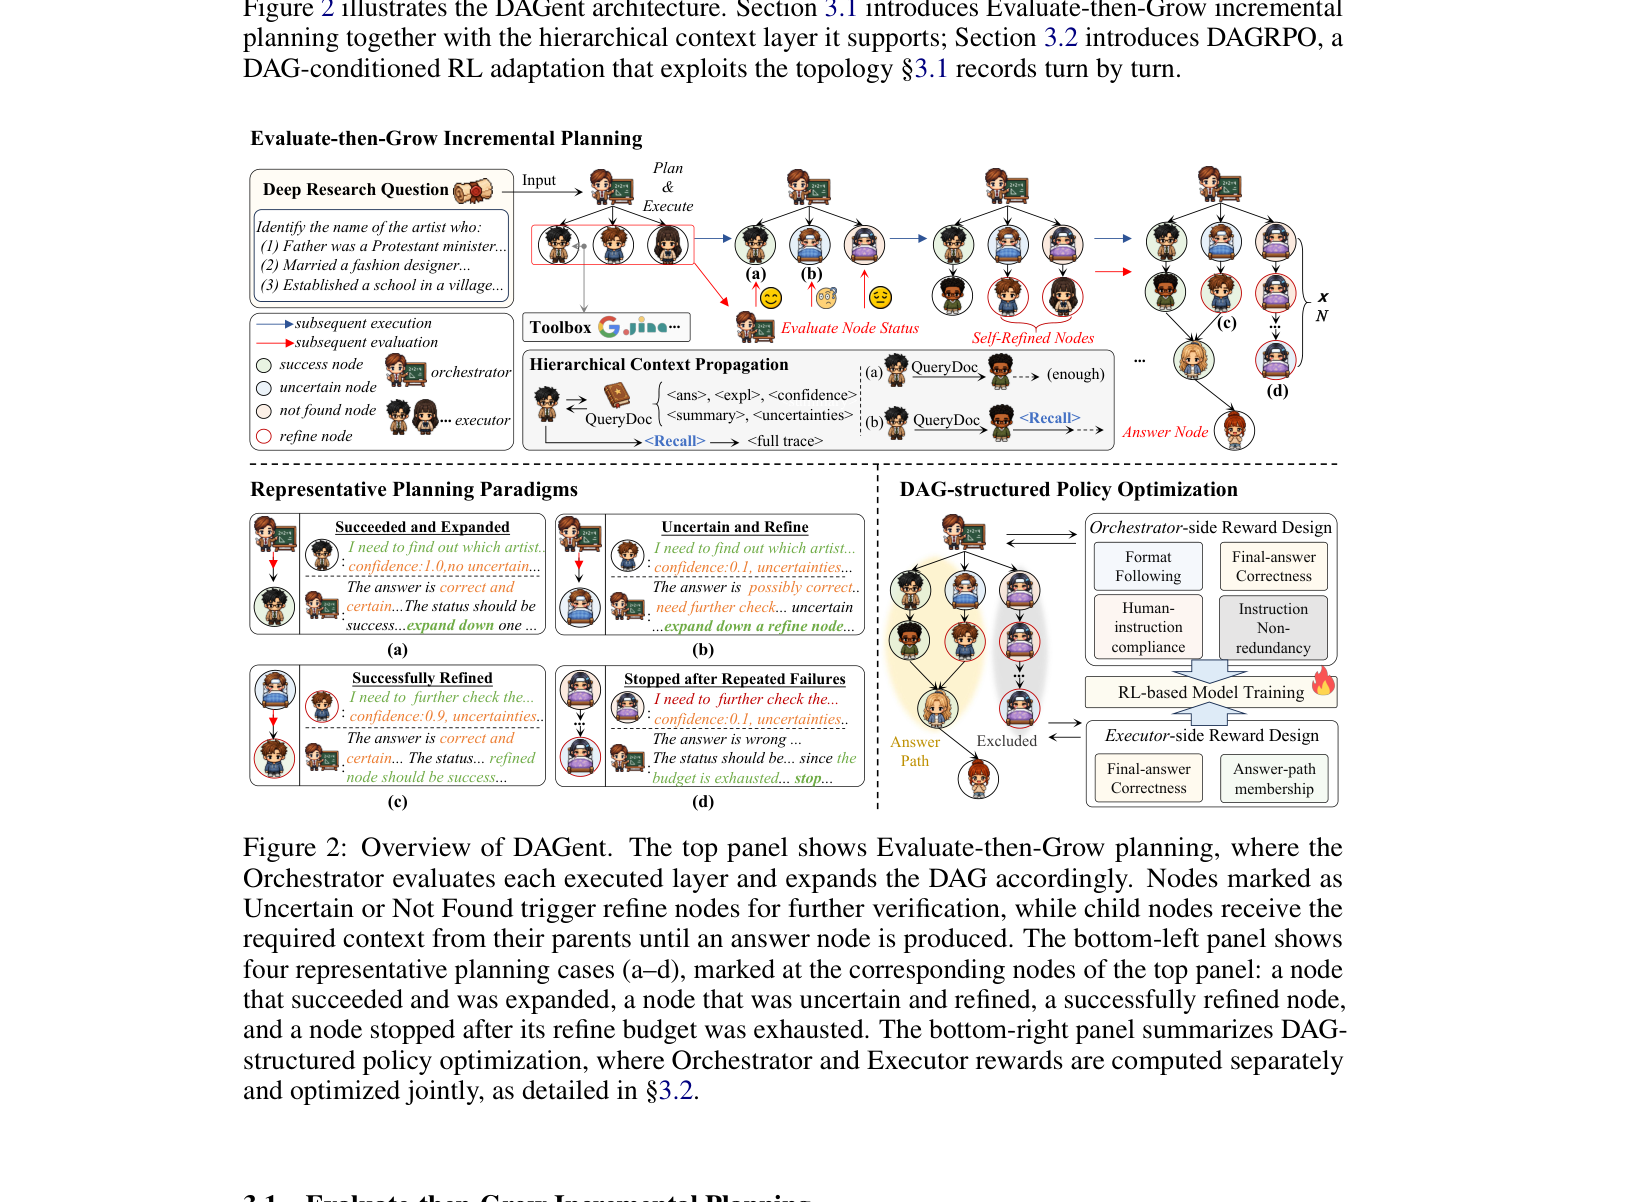
Figure 2 — DAGent의 전체적인 프레임워크 아키텍처 및 계층적 Context 흐름 설명
## 4. Conclusion & Impact (결론 및 시사점)
- 본 연구는 Deep Research를 위한 DAG 기반 에이전트의 점진적 계획 및 강화학습 최적화 전략의 우수성을 입증하였습니다.
- 제안된 Evaluate-then-Grow 전략과 DAGRPO 기법은 에이전트가 복잡한 탐색 과정에서 연산 자원을 더욱 전략적으로 분배하도록 유도합니다.
- 이 연구 결과는 향후 대규모 정보 탐색 및 합성을 수행하는 에이전트 아키텍처 설계에 있어, 사전 계획의 경직성에서 벗어나 구조적 토폴로지를 학습에 적극적으로 활용하는 중요한 이정표가 될 것으로 기대됩니다.
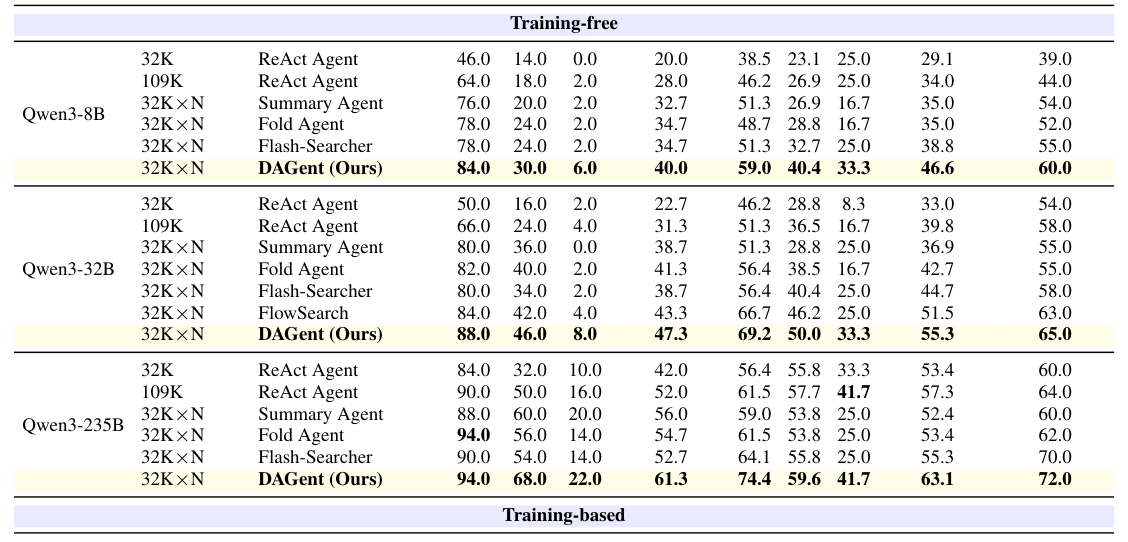
Table 1 — 다양한 backbone 및 베이스라인 대비 제안 모델의 성능 우위를 입증하는 핵심 실험 결과 테이블
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
- [논문리뷰] AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
- [논문리뷰] OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
- [논문리뷰] CERA-MoA: Co-Evolving Routing Mechanisms with Continually Learning LLM Agents
- [논문리뷰] From Proprietary to Open-Source: Bridging the Distribution Gap via Multi-Agent Protocol Distillation in Agentic Search
Review 의 다른글
- 이전글 [논문리뷰] CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering
- 현재글 : [논문리뷰] DAGent: Evaluate-then-Grow Planning for Deep Research Agents
- 다음글 [논문리뷰] DC-SAE: Deep Compression Semantic Autoencoder for Faster Diffusion Convergence
댓글