[논문리뷰] IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jian Yang, An Huang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Sparse Mixture-of-Experts (MoE): 모델의 전체 파라미터는 크지만, 토큰당 일부 전문가(expert)만 활성화하여 계산 효율성을 극대화하는 아키텍처.
- Stable SplitNorm: 모델의 안정성을 유지하면서도 깊은 레이어의 활용도를 높이기 위해, residual stream의 정규화 방식을 서브레이어별로 다르게 설계한 기법.
- μP (Muon-compatible Parameterization): 모델의 폭(width)과 깊이(depth)를 확장할 때 최적의 하이퍼파라미터를 안정적으로 전이(transfer)할 수 있게 하는 파라미터화 방식.
- MOPD (Multi-Teacher On-Policy Distillation): 서로 다른 도메인이나 태스크에 특화된 여러 개의 frozen expert 모델로부터 지식을 하나의 학생 모델로 통합하여 성능을 강화하는 기법.
- Agentic CLI Systems: 사용자의 명령을 수행하기 위해 외부 도구, 파일 시스템, 인터랙티브 환경과 반복적으로 상호작용하는 시스템.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM 기반 에이전트가 외부 환경(특히 CLI)과 상호작용할 때 발생하는 비효율성과 확장성 문제를 해결하기 위해 IQuest-Q1을 제안한다. 기존의 에이전트 모델들은 범용적인 CLI 환경에서 안정적인 도구 사용과 긴 호흡의 reasoning 및 실행 능력을 동시에 확보하는 데 한계가 있었다 [Figure 1]. 또한, 모델 규모를 확장함에 따라 발생하는 최적화 및 안정성 이슈는 에이전트의 실질적인 성능 향상을 가로막는 주요 병목 지점이었다. 이를 해결하기 위해 저자들은 아키텍처 수준에서의 안정적 확장성과, 에이전트 환경에 특화된 다단계 학습 파이프라인을 설계하였다 [Figure 2].
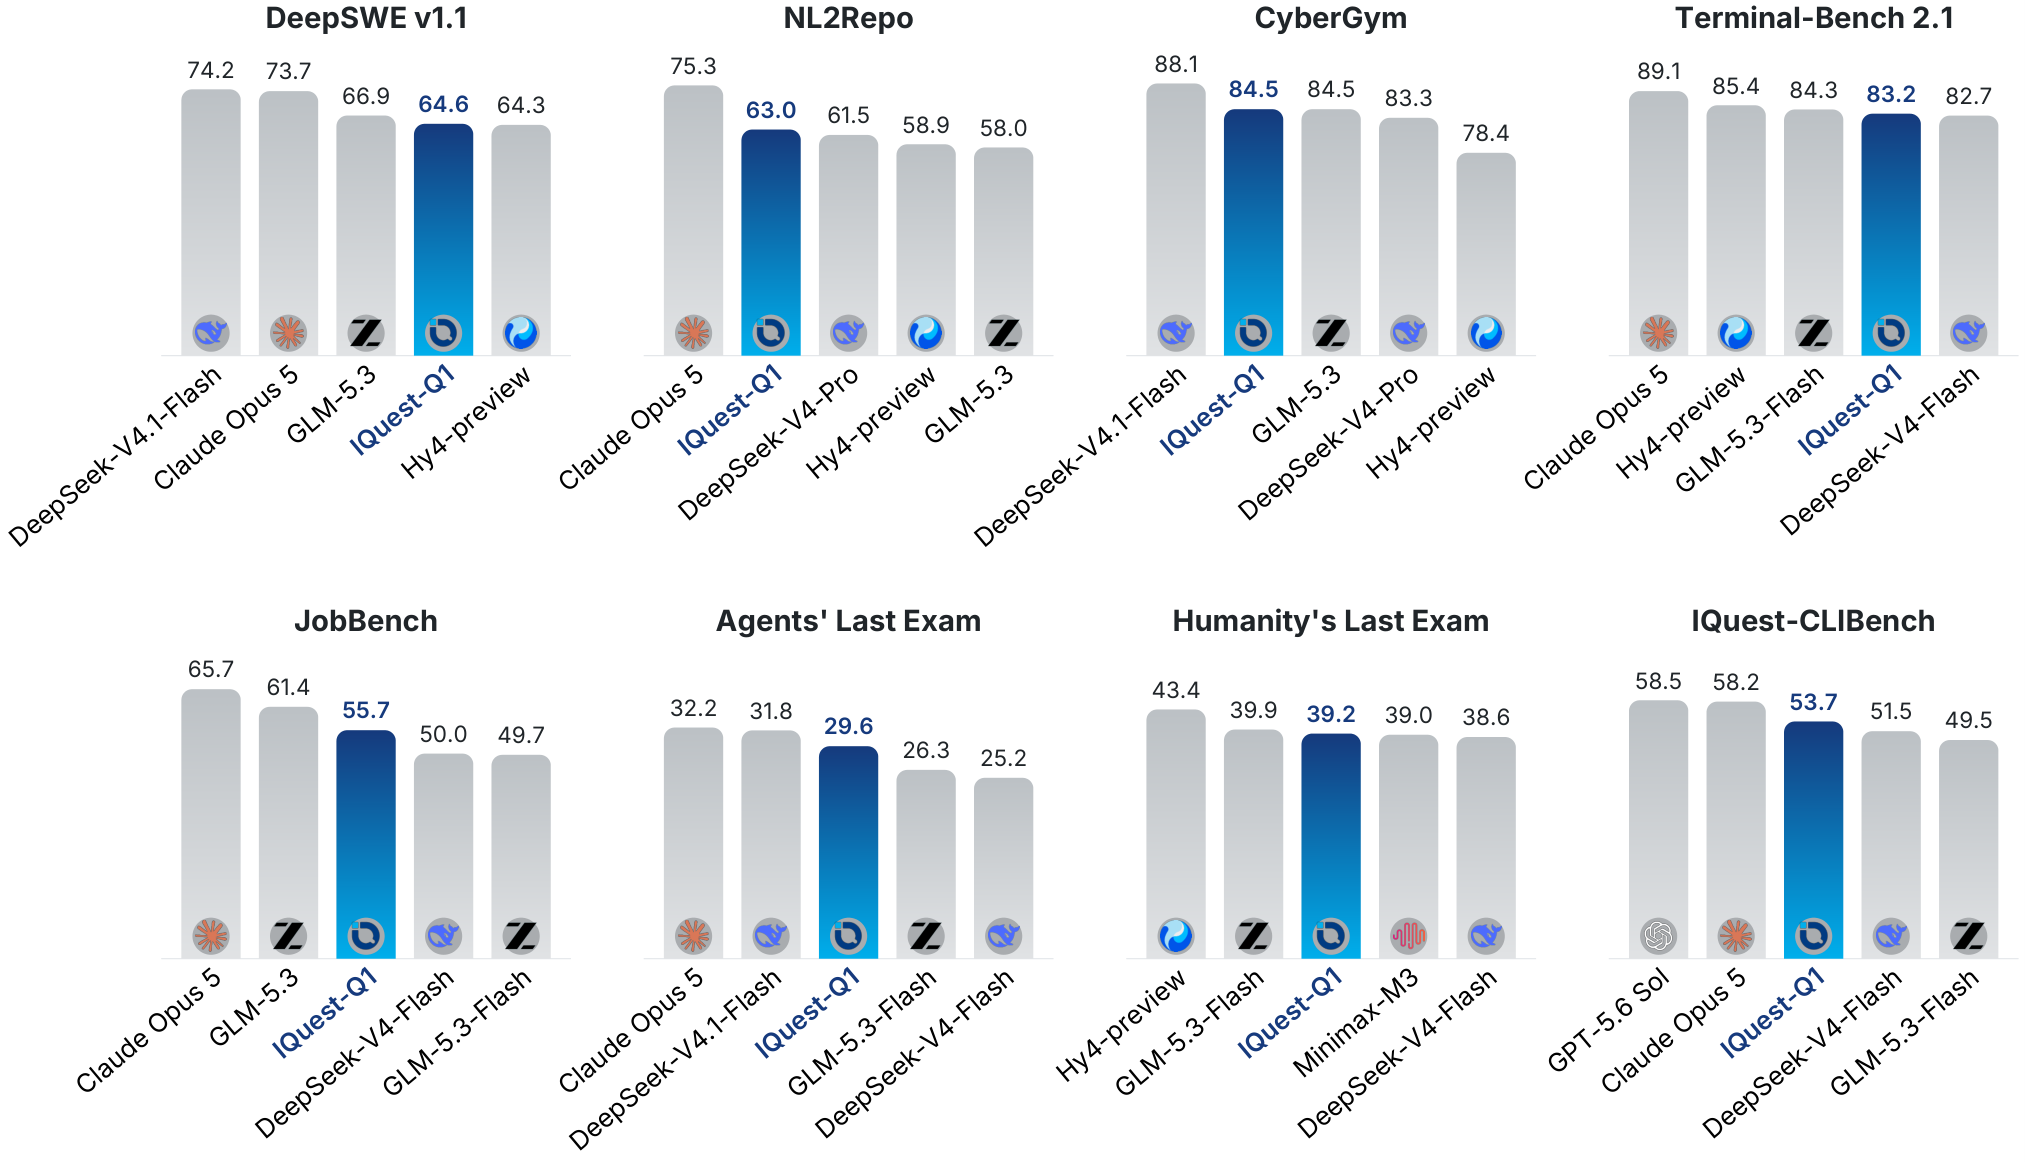
Figure 1 — 벤치마크 성능 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 IQuest-Q1을 위해 Stable SplitNorm, Muon 최적화, 그리고 μP 파라미터화를 결합한 320B 파라미터 규모의 sparse MoE 모델을 구축하였다. 이 모델은 Recursive Multi-token Prediction을 통해 학습 효율을 높였으며, 두 단계의 pre-training curriculum을 통해 데이터 mixtures를 최적화하였다 [Figure 3]. 학습 파이프라인은 SFT, 도메인 특화 RL, 그리고 MOPD를 포함하며, 특히 Environment-Centered Reinforcement Learning을 통해 실질적인 태스크 수행 능력을 강화하였다 [Figure 6]. 정량적 분석 결과, IQuest-Q1은 기존 baseline 대비 약 1.93배 높은 scaling efficiency를 보이며, 훈련 비용을 약 52% 절감하면서 동일한 수준의 손실 값에 도달하였다 [Figure 4(a)]. 또한, 8개의 에이전트 및 추론 벤치마크(DeepSWE, CyberGym, Humanity’s Last Exam 등)에서 우수한 성능을 입증하며, 개발 과정에서 스스로를 개선하는 human-on-the-loop RSI 프로세스를 성공적으로 구현하였다 [Figure 1].
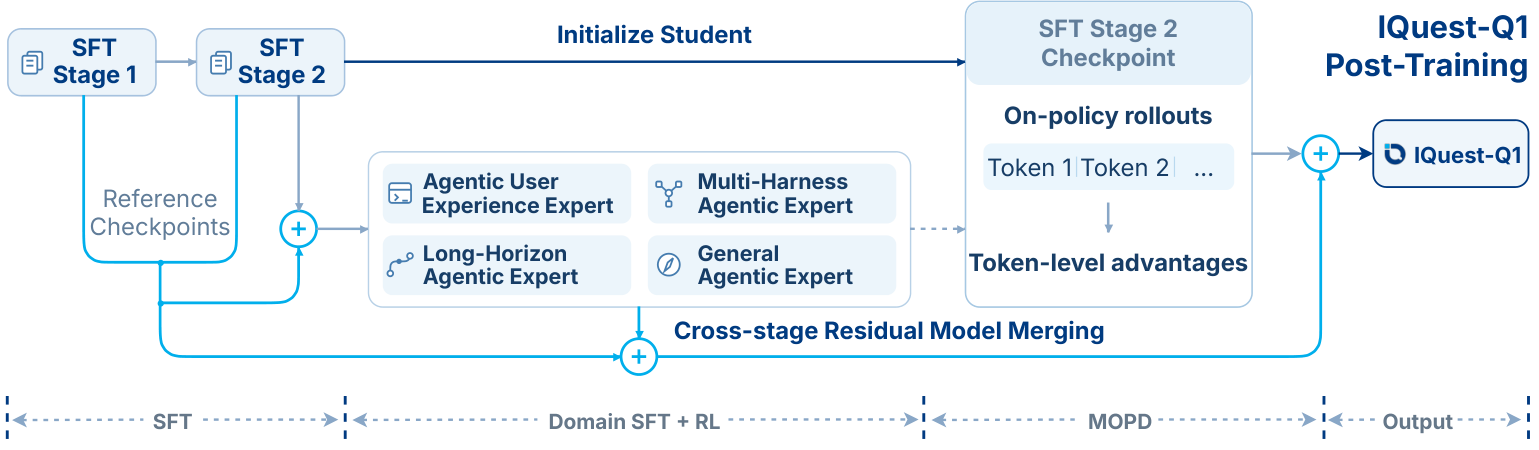
Figure 6 — Post-Training 파이프라인
4. Conclusion & Impact (결론 및 시사점)
본 논문은 에이전트 시스템에 최적화된 고성능 foundation model인 IQuest-Q1을 성공적으로 개발하여 공개하였다. IQuest-Q1은 안정적인 확장성을 보장하는 아키텍처와 환경 중심의 post-training 전략을 통해 에이전트 성능의 새로운 기준을 제시한다. 이 연구는 모델의 개발 과정 자체가 모델 자신의 성능을 향상시키는 Recursive Self-Improvement의 실제 사례를 제공하며, 향후 오픈소스 에이전트 연구 및 복잡한 CLI 환경에서의 실질적인 자동화 기술 발전에 중요한 기여를 할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Kimi K3: Open Frontier Intelligence
- [논문리뷰] MiMo-V2-Flash Technical Report
- [논문리뷰] NVIDIA Nemotron 3: Efficient and Open Intelligence
- [논문리뷰] MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
- [논문리뷰] Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
Review 의 다른글
- 이전글 [논문리뷰] HyperDrone: Simulation-to-Reality Transfer at Millions of Frames per Second
- 현재글 : [논문리뷰] IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
- 다음글 [논문리뷰] Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models
댓글