[논문리뷰] WeVisOne-VL: Unified Visual Perception from Objects to Pixels
링크: 논문 PDF로 바로 열기
메타데이터
저자: Tianming Liang, Junyi Pan, Yuxi Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- WeVisOne-VL: 객체 수준의 인식(Detection)부터 픽셀 수준의 세분화(Segmentation, Matting)까지 통합 수행하는 Vision-Language Model입니다.
- Structured Next-token Prediction: Visual Perception 작업을 고정된 텍스트/좌표 토큰 시퀀스로 변환하여 언어 모델이 추론하게 하는 방식입니다.
- WDE (WeVisOne-VL Data Engine): 1억 개 이상의 이미지와 36억 개의 Bounding-box를 활용하여 다양한 시각 작업 간의 일관된 감독 신호(Supervision)를 생성하는 데이터 엔진입니다.
- Box-guided Query Decoder: VLM이 생성한 Bounding box 좌표와
<OBJ>토큰의 hidden state를 사용하여 입력 이미지에서 픽셀 단위의 dense prediction을 수행하는 경량화된 모듈입니다. - GRPO (Group Relative Policy Optimization): RL 과정에서 Grounding reward를 기반으로 모델의 localization 성능을 최적화하고 할루시네이션을 억제하는 정책 최적화 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 VLM들이 객체 수준의 인식이나 복잡한 환경에서의 시각적 추론에서 여전히 낮은 신뢰도를 보인다는 문제를 해결하고자 합니다. 기존 모델들은 미세한 픽셀 정보를 다루는 데 한계가 있거나, 특정 카테고리 외에는 할루시네이션(Hallucination)이 빈번하게 발생하여 실제 산업 현장에 적용하기 어렵습니다 [Figure 1]. 이러한 한계를 극복하기 위해 저자들은 객체 수준의 Localization부터 세밀한 픽셀 단위의 Matting까지 하나의 자연어 인터페이스로 통합하는 모델을 제안합니다.
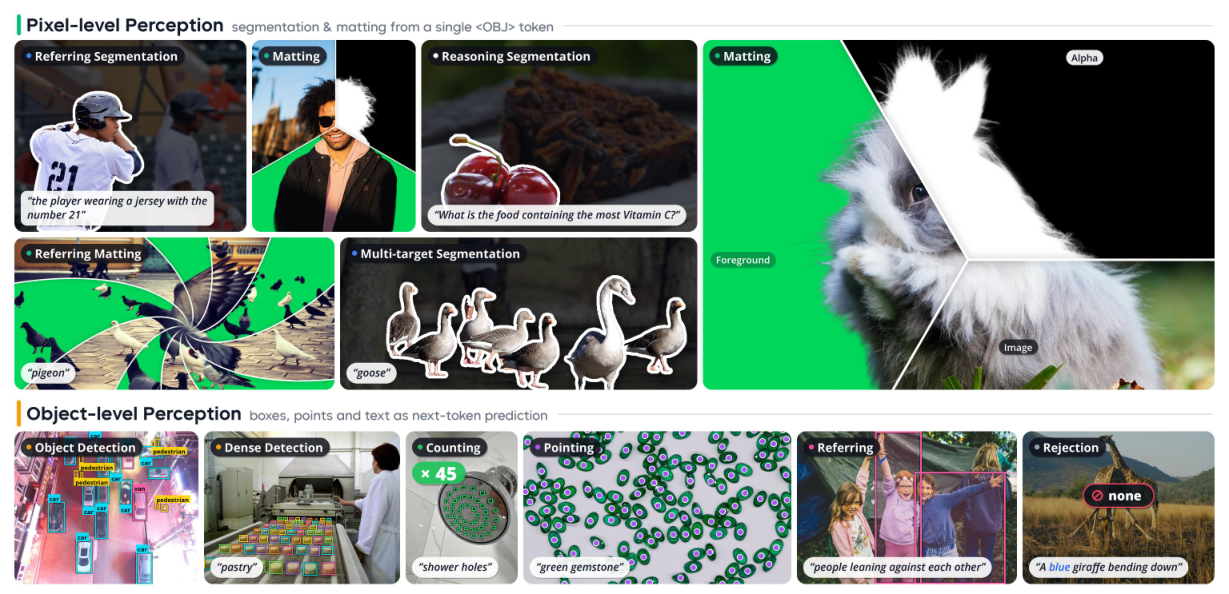
Figure 1 — 통합 인식 능력 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Qwen3-VL 백본에 경량화된 Pixel Decoder를 통합하여 객체와 픽셀 수준의 인식을 일원화하는 아키텍처를 제안합니다 [Figure 4]. WDE는 구조화된 지식 그래프를 활용하여 객체 개념을 검색하고, Detector와 VLM의 협력을 통해 고품질의 Bounding-box 및 Mask 데이터를 생성합니다 [Figure 2]. 모델은 3단계의 Curriculum Supervised Fine-Tuning(SFT)을 통해 기본 성능을 확보한 뒤, Mixed-Task Reinforcement Learning(RL)을 거쳐 Grounding 정확도를 극대화합니다 [Table 1]. 실험 결과, WeVisOne-VL은 30개 이상의 벤치마크에서 기존의 전용 모델 및 범용 모델 대비 우수한 성능을 입증했습니다. 특히, 빽빽한 물체가 있는 상황에서도 높은 Recall을 유지하며, 타겟이 없는 경우(Absent queries) 정확하게 거부하는 로버스트한 성능을 보여주었습니다.
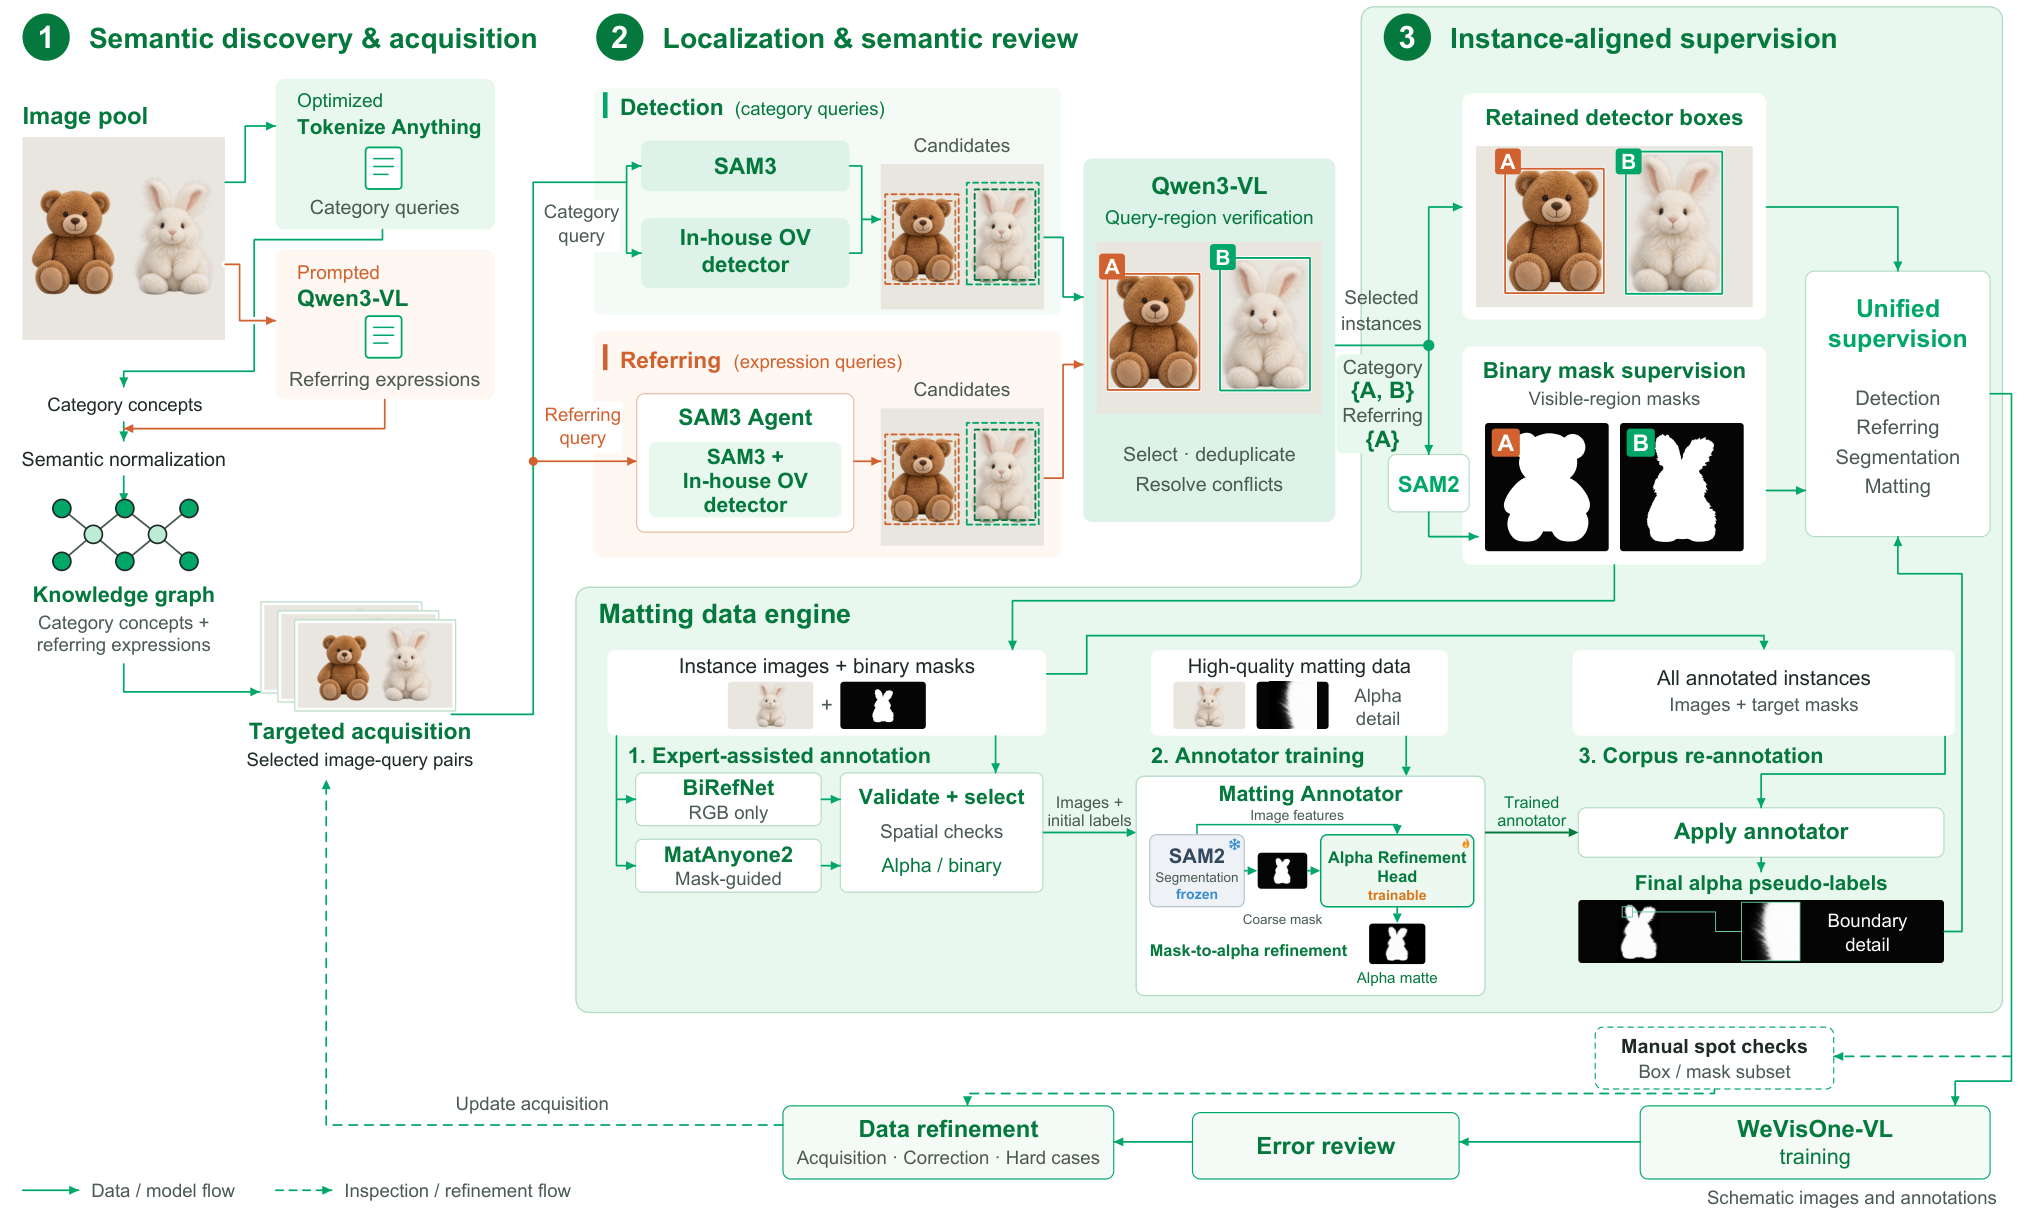
Figure 2 — WDE 구조 및 작동 원리
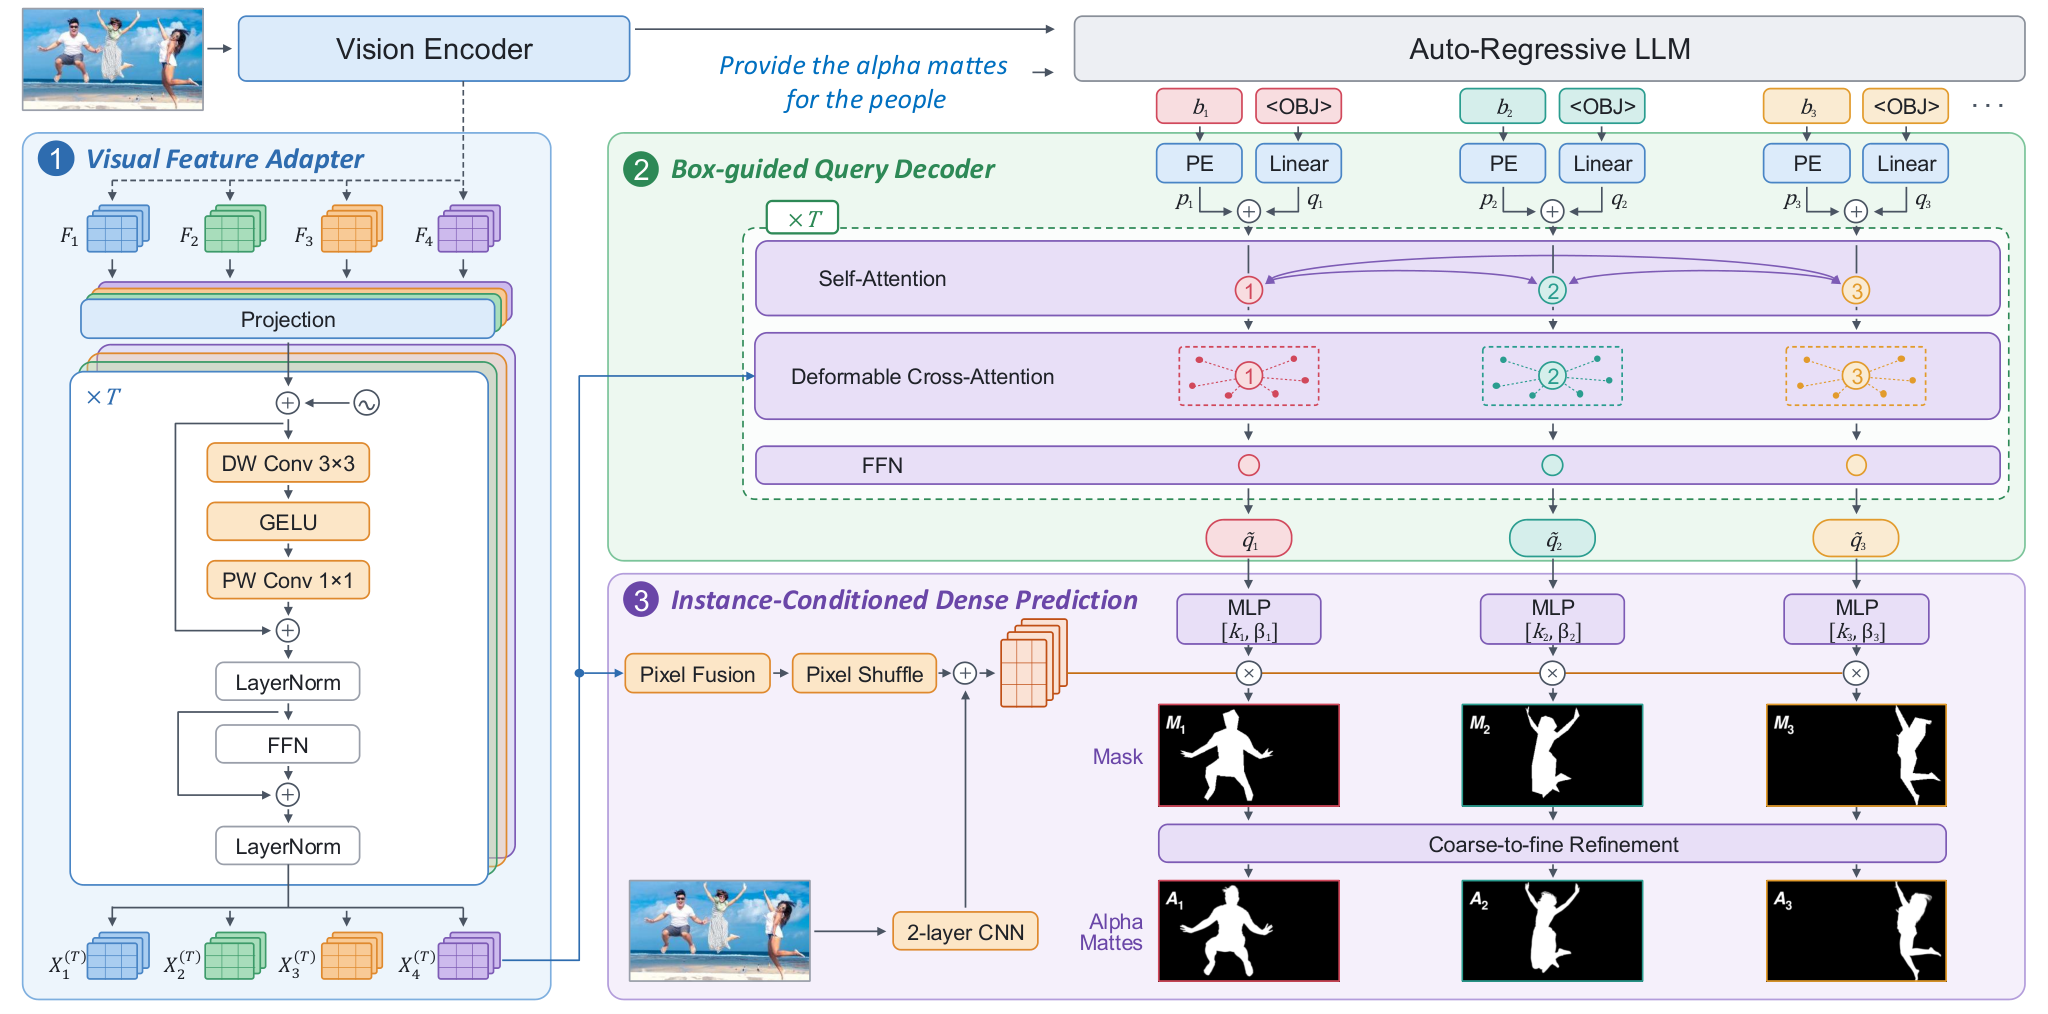
Figure 4 — 경량화된 픽셀 디코더 구조
4. Conclusion & Impact (결론 및 시사점)
본 연구는 통합된 비전 인식을 위해 데이터 엔진 설계부터 모델 아키텍처, RL 파이프라인까지 포괄적인 솔루션을 제공합니다. 이 모델은 다양한 시각적 작업을 하나의 VLM으로 처리함으로써 효율성과 성능을 동시에 달성했습니다. 본 연구에서 제안된 오픈소스 WeVisOne-VL은 실세계 환경에서 보다 신뢰할 수 있는 시각적 시스템 구축을 가속화할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldReward: Reward Modeling for Camera-Conditioned World Models
- [논문리뷰] Evidence-RL: Towards Evidence-intensive Visual Reasoning
- [논문리뷰] Deferred Exposure of Future Trajectories for Verifiable Reasoning in Autonomous Driving VLMs
- [논문리뷰] CADENA: Stepwise CAD Reverse Engineering
- [논문리뷰] Evidence Attribution in Visual Document Understanding without Coordinates or Region Labels
Review 의 다른글
- 이전글 [논문리뷰] Verus-Insight: Towards Explainable Artifact Detection in AI-Generated Videos
- 현재글 : [논문리뷰] WeVisOne-VL: Unified Visual Perception from Objects to Pixels
- 다음글 [논문리뷰] What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
댓글