[논문리뷰] DISC: Domain-Integrated Similarity Cost for Time-Series Dataset
링크: 논문 PDF로 바로 열기
저자: Yen-Ku Liu, Hongjie Chen, Franck Dernoncourt, Ryan Rossi
1. Key Terms & Definitions
- DISC (Domain-Integrated Similarity Cost): 시간-시계열 데이터셋 간의 유사도를 측정하기 위해 다양한 유사도 Metric을 학습 가능한 방식으로 통합하는 프레임워크이다.
- Source-Target Transfer: Pretrained 모델을 Source 데이터셋으로 Fine-tuning한 후 Target 데이터셋에 적용하여 Downstream Task 성능을 평가하는 프로세스이다.
- Pearson Correlation: Source-Target 유사도 Score와 Downstream Forecasting Error 간의 선형 관계를 측정하는 통계적 지표로, 양의 값이 높을수록 Alignment가 강함을 나타낸다.
- Base Mixture: 표준화된 Metric 값들로부터 학습된 주요 유사도 Score이며, Metric의 절대적 크기 정보를 활용한다.
- Prior Mixture: Source-wise Metric Rank를 기반으로 학습된 보조적인 유사도 신호로, Metric 값의 상대적 위치 정보를 제공한다.
2. Motivation & Problem Statement
Time-series Dataset의 성장과 Foundation Model의 발전으로 Dataset 간의 비교가 Time-series Workflow의 핵심 부분으로 자리 잡았으나, 기존의 단일 유사도 Metric들은 Downstream Utility에 대한 Alignment가 부족하다는 것이 본 연구의 핵심 문제이다. Source-Target Transfer 전에 Model Adaptation을 위한 Similarity Estimates는 모든 후보 쌍에 대한 Exhaustive Source-Target Evaluation 없이 Transfer 관련 Dataset 관계를 요약할 수 있어야 한다. 기존에 제안된 많은 Time-series Dataset Similarity Metric들은 서로 다른 Dataset 관계(예: Marginal Distribution, Temporal Shape, Representative Pattern 등)를 포착하며, Downstream Task에 대한 유용성이 Task마다 상이하다는 한계점이 있다. Figure 1은 Wasserstein distance (WSD), Match-and-Deform (MAD), DBA+LCSS, MMD 등 개별 Similarity Metric들이 Dataset 관계를 다르게 해석하며, 단일 Metric으로는 Downstream Behavior를 일관되게 예측하기 어렵다는 것을 시각적으로 보여준다. 특히, Figure 1의 Semantically Mismatched 그룹인 covid_deaths, m1_quarterly, tourism_quarterly의 경우, WSD, MAD, DBA+LCSS는 비교적 유사하다고 평가하지만, MMD는 이들을 멀리 떨어져 있다고 평가하여 단일 Metric의 한계를 명확히 드러낸다. 이러한 Metric-level의 차이는 Dataset Similarity가 Transfer Assessment, Dataset Visualization, Benchmark Curation 등에 활용될 때 중요한 문제로 작용하며, 단일 Metric이 모든 Task에 걸쳐 지배적일 것이라는 기대를 어렵게 만든다.
3. Method & Key Results
본 논문은 Time-series Dataset Similarity 문제를 해결하기 위해, Domain-Integrated Similarity Cost (DISC)라는 학습 가능한 통합 프레임워크를 제안한다. DISC는 Calibration Transfer Observation을 활용하여 다른 Downstream Task를 위해 Complementary Similarity Metric들을 선택, 가중치 부여, 그리고 결합하는 방법을 학습한다. DISC의 전체 Overview는 Figure 2에 제시되어 있으며, 이는 후보 Similarity Metric들 {sm(X,Y)}m∈ℳ를 Task-specific한 Base Mixture B(X,Y)와 Prior Mixture P(X,Y)로 학습하는 과정을 보여준다. Base Mixture는 표준화된 Metric 값 zm(X,Y)에서 도출되며, Prior Mixture는 Source-wise Metric Rank rm(X,Y)에서 도출된다. 최종 DISC Score Sθ(X,Y)는 학습된 Gate G(X,Y)가 Prior Mixture를 사용하여 Base Mixture를 조절하는 방식으로 계산된다: Sθ(X,Y)=B(X,Y)G(X,Y). 이 Gated Integration 설계는 DISC가 유용한 Cost Value를 제공하는 Metric들을 강조하는 동시에, Rank 기반 정보를 보충적인 Source-wise Evidence로 활용할 수 있도록 한다. 실험은 Out-of-Distribution (OOD) 및 Transfer Learning (TL) Forecasting Setting에서 Time-MoE와 Lag-Llama 두 가지 Foundation Model을 사용하여 수행되었으며, 총 4가지 Downstream Task Setting에 걸쳐 DISC의 성능을 평가했다. 결과적으로, DISC는 보고된 Split에서 4가지 Task Setting 전반에 걸쳐 평균 Test Pearson Correlation을 약 10% 향상시켰다. 특히, Table IV에 따르면 DISC는 모든 4가지 Task에서 Best Single Metric보다 높은 Pearson Correlation (R) 값을 달성했다. 구체적으로, OOD-Lag-Llama Task에서는 Best Single Metric인 DBA-DTW의 R이 0.618이었던 반면, DISC는 0.697을 기록하며 12.84%의 상대적 개선을 보였다. 또한, TL-Time-MoE Task에서는 Best Single Metric인 PCA-ED의 R이 0.537이었으나, DISC는 0.617로 14.75% 향상되었다. 평균적으로 DISC는 Best Single Metric의 평균 R인 0.543을 0.598로 끌어올려 10.29%의 상대적 개선을 이루었다. 이러한 정량적 결과는 DISC의 학습된 Metric 통합이 단일 Metric을 수동으로 선택하는 것보다 Downstream Transfer Behavior에 더 강력한 Proxy를 제공함을 명확히 보여준다. Figure 3는 DISC Score와 Downstream Forecasting Error 간의 긍정적인 상관관계를 Source-level에서 시각적으로 제시하며, DISC가 Downstream Behavior에 중요한 Source-Target Dataset 차이를 더 잘 구별함을 입증한다.
4. Conclusion & Impact
본 논문은 Time-series Dataset Similarity를 위한 학습 가능한 프레임워크인 DISC를 성공적으로 제안했다. DISC는 Calibration된 Base Mixture와 Rank-conditioned Prior Modulation을 통해 Dataset-level 및 Reducer-based Similarity Configuration을 통합하여, Downstream Task에 걸쳐 Source-Target 관계를 더 잘 분리하는 통합 유사도 Score를 생성한다. 실험 결과, DISC는 4가지 Forecasting Task에서 Best Single Metric보다 모든 Task Column에서 높은 성능을 보였으며, 평균적으로 Pearson Correlation을 10.29% 증가시켰다. 이 연구는 Source-Target Transfer Alignment가 Task-Dependent하며, 고정된 단일 Metric으로는 신뢰할 수 있는 예측을 제공하기 어렵다는 중요한 시사점을 제시한다. 또한, 짧거나 평탄하거나 다양성이 낮은 Sampled Window가 단일 Metric의 Correlation을 약화시킬 수 있음을 보여주었다. DISC는 Calibration Transfer Observation과 이기종 Similarity Signal을 Task-aware한 Time-series Source-Target Transfer Assessment Score로 전환하는 실용적인 방법론을 제공하며, 이는 학계 및 산업계에서 Foundation Model의 효율적인 활용 및 Transfer Learning 성능 개선에 크게 기여할 것으로 기대된다.
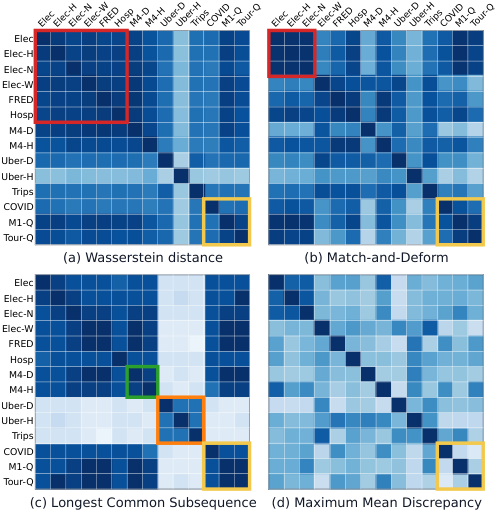
Figure 1 — 단일 유사도 Metric별 데이터셋 거리
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
- [논문리뷰] The fixed-point bundle method over product-of-simplex domains arising from game equilibria
- [논문리뷰] TenetBench: A Clause-Anchored Russian Corpus for Evaluating Language Models against Professional Codes of Ethics
- [논문리뷰] Speculative Diffusion is a Tale of Two Tradeoffs
Review 의 다른글
- 이전글 [논문리뷰] Co-adaptive Rule Routing and Constraining for Structured Knowledge Retrieval
- 현재글 : [논문리뷰] DISC: Domain-Integrated Similarity Cost for Time-Series Dataset
- 다음글 [논문리뷰] DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
댓글