[논문리뷰] DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
링크: 논문 PDF로 바로 열기
저자: Zixian Gao, Lixin Xiu, Penghao Luo, Xiangcheng Cao, Ziqi Cai, Zhen Li, Erwin Wu, Kaipeng Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Live Broadcast Production: 모델이 원본 카메라 피드를 받아들이고, 과거 정보만을 활용하여 실시간으로 방송에 내보낼 장면을 선택(directing)하고 이에 대한 해설(commentary)을 생성하는 통합 태스크를 의미한다.
- Streaming Video-Language Model (SVLM): 실시간으로 들어오는 비디오 스트림을 처리하며, 즉각적인 의사결정 및 응답 생성을 목적으로 설계된 비디오 언어 모델이다.
- Hold-or-Switch Director: DirCast의 핵심 구성 요소로, 현재 화면을 유지할지(
hold) 또는 다른 화면으로 전환할지(switch)를 먼저 결정한 후, 전환할 경우 어떤 카메라로 전환할지 선택하는 이중 결정 메커니즘이다. 이는 인간 감독의 잦은 샷 유지 패턴을 모방한다. - Program Memory: 장기 컨텍스트(long-term context) 관리를 위한 DirCast의 방법론으로, 저해상도 카메라 피드들은 몇 초 후 만료되고, 실제로 방송에 나간 고해상도 장면, 이벤트, 그리고 발화된 해설만 메모리에 유지하여 스트림 길이에 관계없이 연산 비용을 제한한다.
- Event-Anchored Targets: 훈련 과정에서 킬(kill)과 같은 게임 이벤트 발생 시, 실제 인간 감독의 선택 외에도 킬러(killer)나 희생자(victim)의 카메라를 올바른 디렉팅 결정으로 간주하도록 모델을 학습시키는 기법이다. 이는 모델이 중요한 액션을 포착하도록 유도한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
라이브 e스포츠 방송은 인간 감독과 해설자가 미래를 알 수 없는 상황에서 카메라 선택과 해설에 대한 초 단위의 결정을 내려야 하는 고도로 복잡한 작업이다. 이러한 작업의 난이도로 인해 전문적인 방송은 주요 대회에만 국한되며, 대다수의 지역 및 아마추어 경기는 고정된 카메라와 해설 없이 스트리밍되는 실정이다. 기존의 Streaming Video Language Models (SVLMs)은 인간 감독이 이미 제작한 방송에 대한 해설에만 초점을 맞춰왔으며, 시청자에게 보여줄 장면을 직접 선택하는 복잡한 directing 태스크는 간과했다. 문제는 directing과 commentary가 긴밀하게 연결되어 있다는 점이다. 감독의 결정은 해설자가 보고 설명할 내용을 직접적으로 결정하며, 잘못된 카메라 전환은 연쇄적인 오류를 유발할 수 있다. 또한, 실시간으로 10개의 동시 카메라 피드를 고해상도로 처리하는 것은 장시간 스트림에 대해 관리 불가능한 context를 생성하며, 인간 방송 데이터만으로 훈련할 경우 모델이 자체 directing error로 인해 발생할 수 있는 새로운 상태에 대비하지 못하는 exposure bias 문제가 발생하여, 부자연스러운 화면 전환이나 긴 침묵을 야기할 수 있다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 DirCast를 제안하며, 이는 단일 Streaming Video Language Model로 Dota 2 라이브 경기에서 directing과 commentary를 동시에 수행한다. DirCast는 매초 새로운 게임 이벤트와 10개의 저해상도 카메라 피드를 읽고, hold-or-switch director head를 통해 현재 샷을 유지할지 또는 다른 카메라로 전환할지 결정한다 [Figure 2]. 선택된 고해상도 피드는 스트림에 추가되며, 그 이후에 commentary가 생성되어 director의 결정에 기반한 commentary를 보장한다. 모델의 memory는 저해상도 피드가 몇 초 후 만료되는 동안 온에어 뷰와 발화된 단어만 유지하는 program-only context를 통해 관리되어 스트림 길이와 관계없이 cost를 일정하게 유지한다. 훈련 중에는 perturbed program rollouts를 통해 모델이 자체 mistake에서 회복하도록 학습시키고, event-anchored targets를 통해 킬 발생 시 killer나 victim의 카메라를 올바른 directing decision으로 인식하도록 유도한다. 추론 시에는 human crew의 cut rate 및 speaking rate에 맞춰 동적으로 threshold를 조정하여 자연스러운 rhythm을 유지한다.
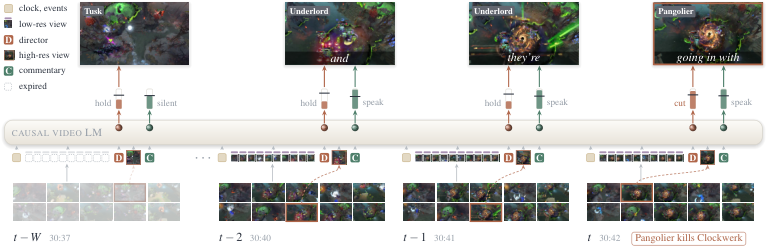
Figure 2 — 제안 모델의 전체 아키텍처
실험 결과, DirCast는 directing과 commentary 모두에서 우수한 성능을 보였다. Directing 측면에서 DirCast는 Top-1 agreement에서 27.0%를 달성하여 rule-based 및 zero-shot directors 중 가장 강력한 Action rule의 25.4%를 능가했다 [Table 1]. 또한, kills의 89.1%를 화면에 담아 human director의 50.3%보다 높은 coverage를 보였다 [Table 1]. Zero-shot vision language models (VLMs) 및 GPT-5는 human director와의 agreement가 낮았고, cut rate가 너무 높거나 낮아 부자연스러운 program을 생성했다. Commentary 측면에서 DirCast는 Proact-VL protocol에 따라 GPT-4o와의 비교에서 29.21%의 win rate를 기록하며, 기존의 강력한 streaming commentators 중 최고 성능인 LiveCC-7B-Base의 19.38%를 크게 앞섰다 [Table 2]. DirCast는 human casters와 평균 0.30 seconds의 TimeDiff로 가장 유사하게 발언을 시작했으며, Live delivery scores 및 PAUC에서도 최고점을 기록했다 [Figure 3, Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 live esports broadcast production이라는 새로운 task를 제시하고, 단일 streaming video language model인 DirCast를 통해 directing과 commentary를 실시간으로 통합하여 해결 가능함을 입증했다. DirCast의 hold-or-switch director와 program-only context는 효율적인 자원 관리와 장시간 스트림 처리 능력을 제공하며, perturbed programs 및 event-anchored targets를 통한 학습은 모델이 실제 환경에서 발생할 수 있는 오류에 강건하게 대응하도록 한다. 이 연구는 rule-based 및 zero-shot directors는 물론 GPT-5와 같은 최신 VLM을 능가하는 directing performance를 달성했으며, 기존의 streaming commentators보다 우수한 commentary quality를 보였다. DirCast는 esports 분야에서 전문적인 broadcast production을 automated하고 확장하여, 현재 human crew의 제한으로 인해 접근성이 낮은 수많은 경기에 대한 고품질 중계 제공의 가능성을 열었다는 점에서 중요한 시사점을 가진다.
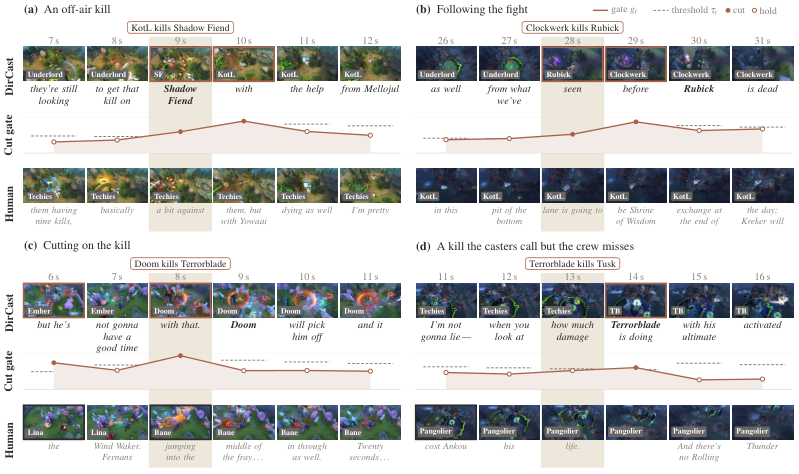
Figure 4 — DirCast의 성공적인 킬 장면 연출 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Act with Intent: Distilling Behavior Intent for Vision-Language-Action Models
- [논문리뷰] A Pathway to General-Purpose Scientific AI: Multimodal Comprehension of Scientific Images
- [논문리뷰] Loud or Silent? A Reusable Framework for Per-Modality Failure Analysis in Multimodal Clinical AI
- [논문리뷰] LeapTalk: Breaking the Latency-Quality Trade-off in Talking Head Generation
- [논문리뷰] ICDAR 2026 Competition on Information Extraction from Atomic Layer Deposition/Etching (ALD/E) Scientific Figures
Review 의 다른글
- 이전글 [논문리뷰] DISC: Domain-Integrated Similarity Cost for Time-Series Dataset
- 현재글 : [논문리뷰] DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
- 다음글 [논문리뷰] DraMaze: A Multi-Agent Pipeline with Future-Aware Memory for Diverse Microdrama Script Generation
댓글