[논문리뷰] Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
링크: 논문 PDF로 바로 열기
저자: Jiayue Pu, Ang Gao, Jinyi Bai, Qipeng Wang, Tongyu Wen, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Recursive Self-Improvement (RSI): AI 시스템이 경험과 피드백을 활용하여 자체적인 모델 파라미터, 메모리, 도구, 워크플로우를 수정하고, 나아가 이러한 수정 메커니즘 자체까지 재귀적으로 개선하는 프로세스입니다.
- S1–S4 (Improvement Cycle): RSI의 핵심 단계인 Improvement Diagnosis (S1), Proposal Generation (S2), Proposal Evaluation (S3), Update Implementation (S4)를 지칭합니다.
- RI (Recursive Improvement): RSI 프로세스의 기반이 되는 시스템 설정이나 메커니즘 자체가 반복적으로 수정되고 재사용되는 현상을 의미합니다.
- Trustworthiness Themes: RSI의 신뢰성을 담보하기 위해 고려해야 할 4대 요소인 Genuine and Sustained Improvement, Behavioral Constraints (Alignment & Fairness), System Security (Resilience, Privacy, Data Governance), Transparency and Controllability를 정의합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 대규모 모델 기반의 RSI가 시스템 효율성을 극대화할 수 있음에도 불구하고, 이 과정에서 발생하는 심각한 신뢰성 결여 문제를 체계적으로 진단하기 위해 수행되었습니다. 모델이 스스로를 수정하는 과정에서 이전의 정렬(Alignment) 상태가 붕괴하거나, 평가 프로세스의 결함으로 인해 성능 저하가 발생할 수 있습니다. 또한, 기존의 정적 검증 방식은 RI가 적용된 동적 업데이트 메커니즘을 적절히 통제하지 못하는 한계가 있습니다. 이러한 문제들을 명확히 하기 위해 저자들은 RSI의 운영 정의와 프로세스 프레임워크를 수립하고, 신뢰성 보장을 위한 종합적인 평가 체계를 제안합니다 [Figure 1].
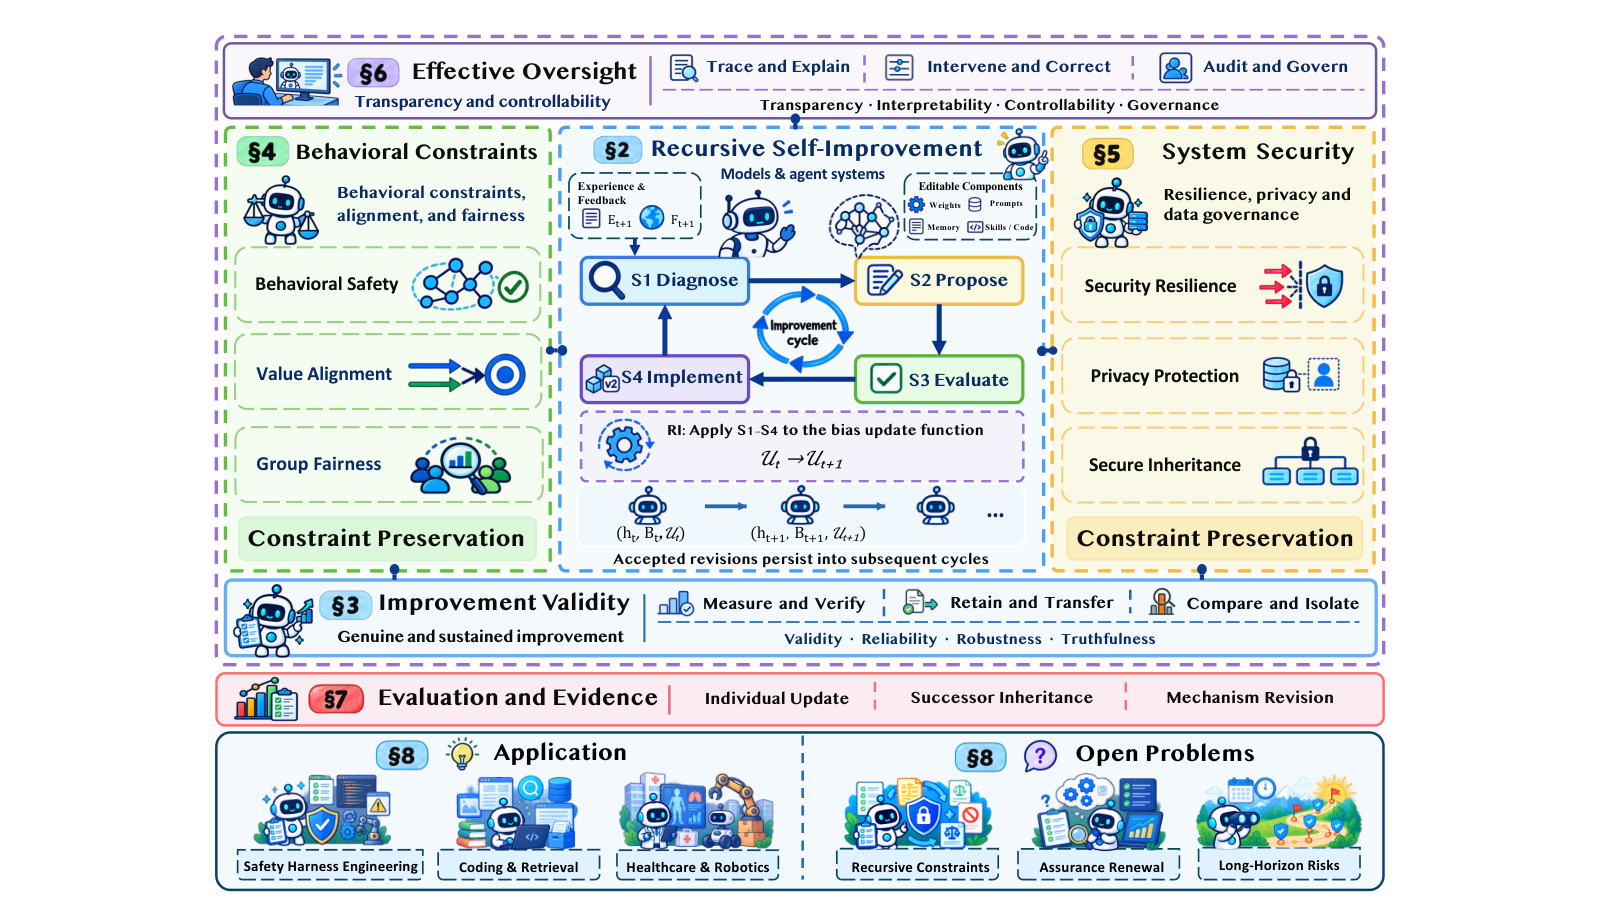
Figure 1 — RSI 프로세스 및 신뢰성 프레임워크 개요
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들은 RSI를 네 단계의 S1–S4로 구조화하고, 세 가지 관점(Improvement Validity, Constraint Preservation, Effective Oversight)에서 각 단계별 리스크를 분석합니다.
- Improvement Validity: 단순한 성능 향상이 아닌 지속 가능한(Sustained) 성능 개선을 보장하기 위한 증거 확보 기법을 제시합니다.
- Constraint Preservation: 업데이트 과정에서도 시스템의 안전성 가이드라인과 Alignment가 유지되도록 하는 정렬 메커니즘의 중요성을 강조합니다.
- Effective Oversight: RI가 시스템 내부 메커니즘까지 변경할 때 인간의 감독(Human Oversight)이 무력화되지 않도록 하는 투명성 확보 방안을 논의합니다 [Figure 1]. 주요 분석 결과, 단순히 개별 업데이트의 성공 여부만 확인해서는 부족하며, 세대 간(Successor-level) 영향력과 Meta-Improvement의 안정성을 반드시 함께 평가해야 함을 정량적/정성적 근거를 통해 입증했습니다.
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 RSI를 수행하는 모델이 직면한 신뢰성 위기를 4대 핵심 테마로 정리하고, 이를 평가하기 위한 통합적 방법론을 제시함으로써 학계와 산업계에 중요한 이정표를 마련했습니다. RSI 기술이 고도화됨에 따라 단순한 기능 구현을 넘어, 장기적인 시스템 안전성을 확보하는 것이 기술적 성패의 핵심이 될 것임을 시사합니다. 향후 연구는 재귀적으로 수정되는 시스템의 제어 가능성(Controllability) 확보와 도메인 특화된 신뢰성 검증 프레임워크 구축에 집중해야 합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Reproducing, Analyzing, and Detecting Reward Hacking in Rubric-Based Reinforcement Learning
- [논문리뷰] Reward Hacking in the Era of Large Models: Mechanisms, Emergent Misalignment, Challenges
- [논문리뷰] Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization
- [논문리뷰] Toward Recursive Self-Improvement in Physical AI
- [논문리뷰] Memory-Centric Continual Learning for AI Agents
Review 의 다른글
- 이전글 [논문리뷰] Trust Mechanisms for Offline Generative AI at the Edge: A Connectivity-Regime Framework and an Empirical Study on a Raspberry Pi 5
- 현재글 : [논문리뷰] Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges
- 다음글 [논문리뷰] Work Agents: Systems, Capabilities, and Optimization
댓글