[논문리뷰] CodeCap-Bench: Can Code Serve as a Good Video Caption?
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jiafu Tang, Yifan Xu, Eric Tang, Junjie Zhao, Shipeng Luo, Te Sun, Haoxuan Hu, Yiyan Ji, Xinlong Chen, Zihao Wang, Yang Shi, Yuanxing Zhang, Pengfei Wan, Jiaheng Liu et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Code Captioning: 비디오의 시각적 콘텐츠, 공간 구조, 시간적 역학(Temporal Dynamics)을 그래픽 원시 요소(Graphical Primitives)와 함수를 사용하여 실행 가능한 프로그램으로 표현하는 패러다임입니다.
- CodeCap-Bench: 구조화된 2D 비디오(인터페이스, 게임, 과학적 시각화 등) 323개에 대해 코드 캡셔닝 성능을 체계적으로 평가하기 위한 다단계 벤치마크 프레임워크입니다.
- Visual Similarity: 참조 비디오와 코드에서 렌더링된 비디오 간의 전반적인 시각적 외관, 모션 패턴을 V-JEPA 2.1 모델을 통해 측정하는 지표입니다.
- Object-level Spatio-temporal IoU: 주요 객체의 위치와 존재 시간을 SAM 3.1을 활용한 세그멘테이션 결과와 참조 주석 간의 일치도로 측정하는 지표입니다.
- Fine-grained Visual Information Retention: 정적/동적 포컬 포인트(Focal Point)가 코드에 의해 얼마나 충실하게 재현되었는지 GPT-6-sol을 통해 정량화하는 평가 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 자연어 기반 비디오 캡셔닝이 갖는 정밀한 공간 구조와 복잡한 시간적 동역학 표현의 모호함 및 장황함을 해결하기 위해 'Code as Video Caption' 패러다임을 제안한다. 기존의 자연어 기술 방식은 영상의 시각적 상세 정보를 보존하는 데 한계가 있으며, 이는 캡션의 모호성으로 이어진다. 저자들은 실행 가능한 코드가 시각적 요소를 더 정확하게 명시하고, 렌더링을 통해 검증 가능하다는 점에 주목한다 [Figure 1]. 그러나 현재 MLLM들이 이러한 코드를 얼마나 충실하게 생성할 수 있는지에 대한 체계적인 평가 도구가 부족하다는 문제점을 지적한다.
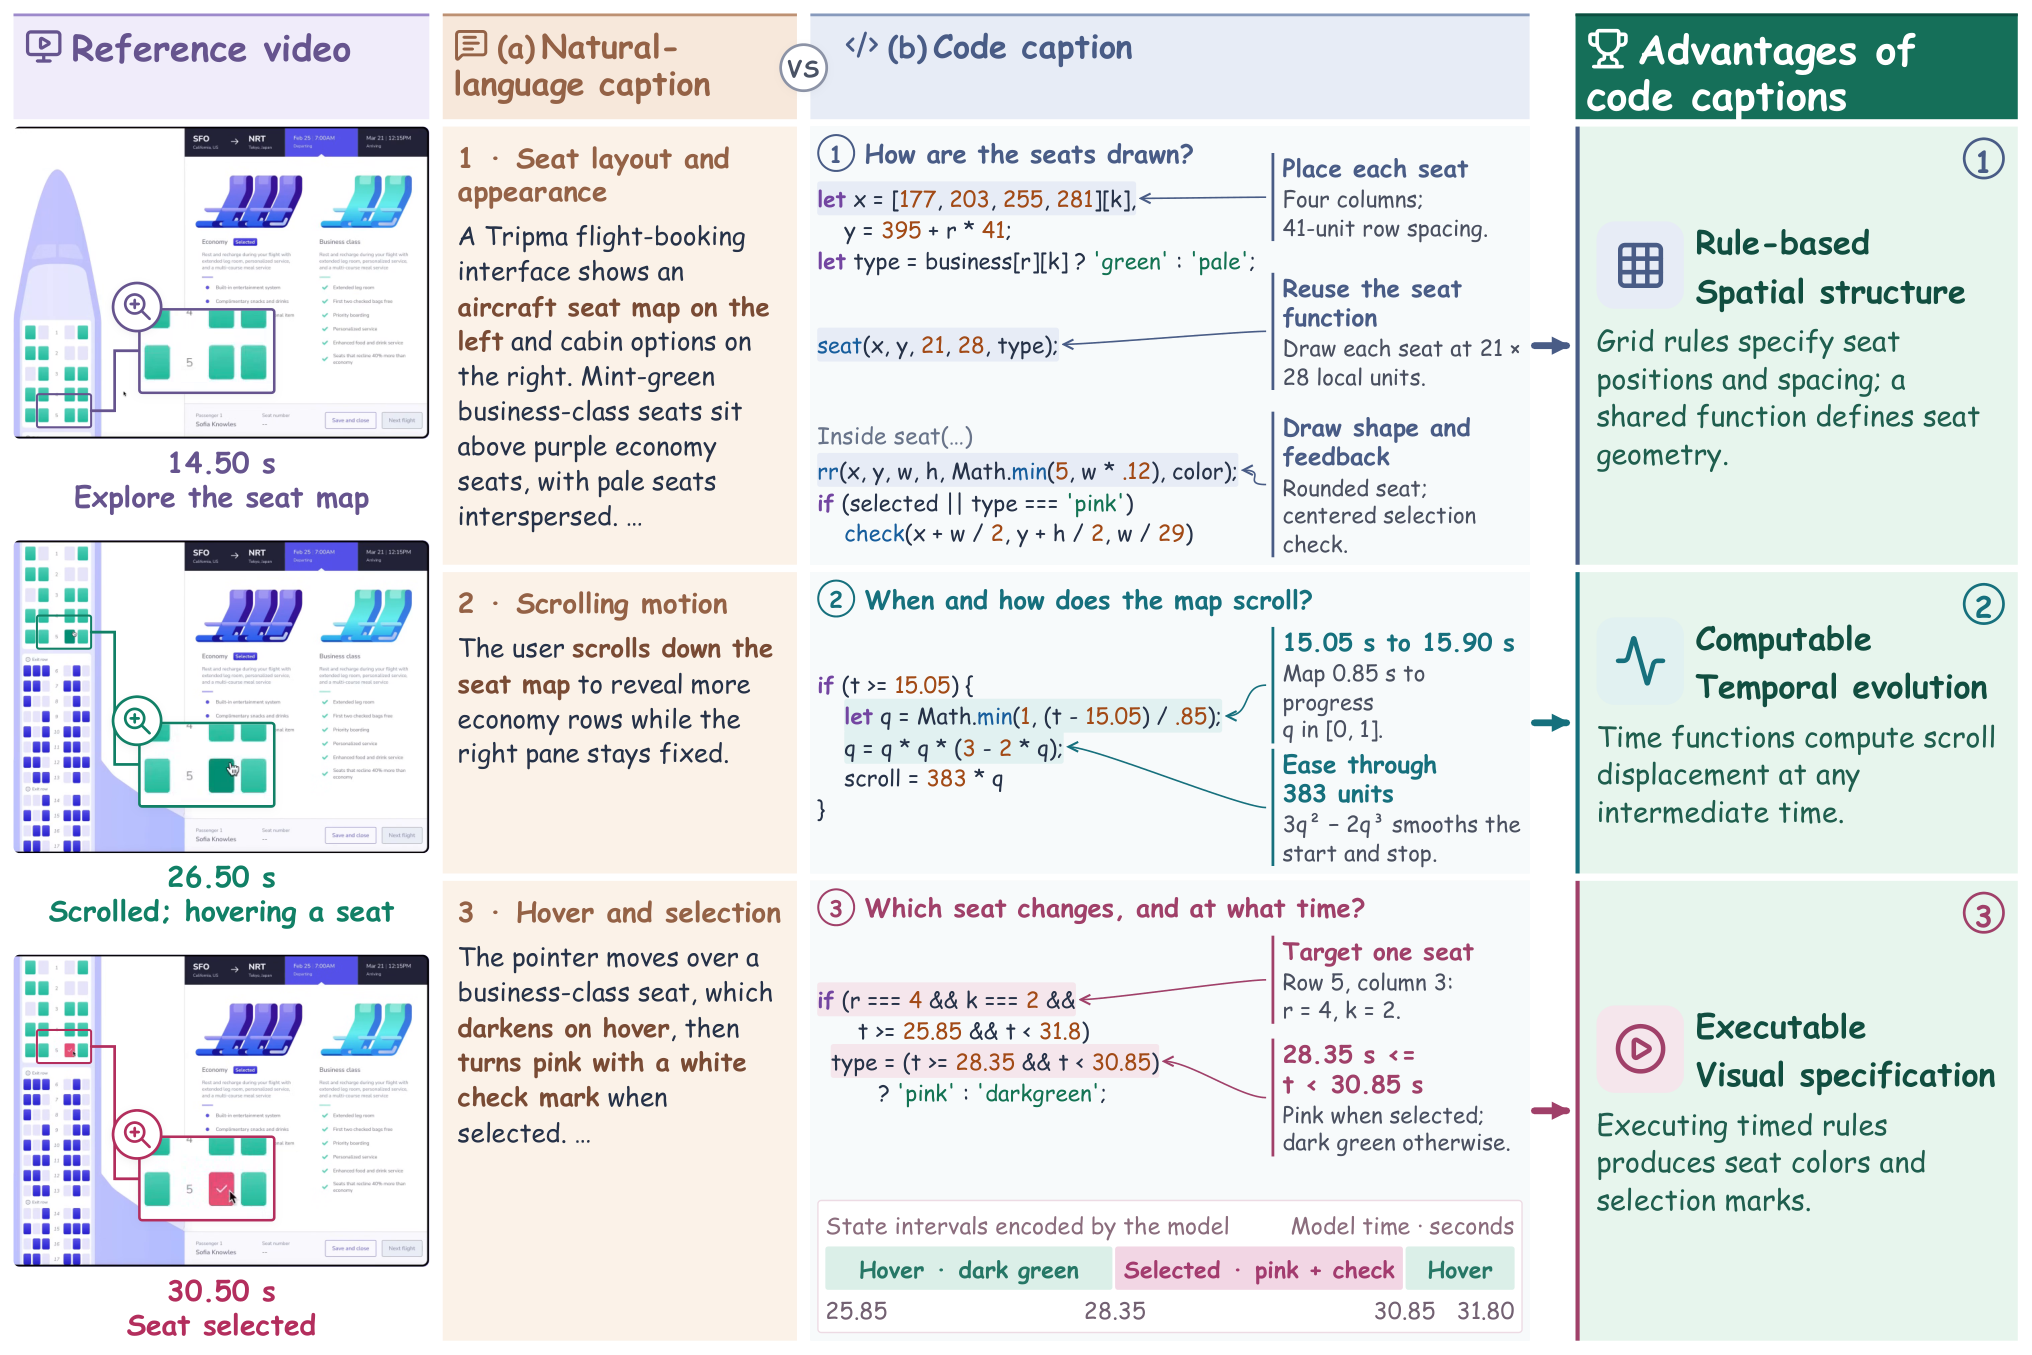
Figure 1 — 코드 캡셔닝 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 3단계 파이프라인(데이터 수집, 필터링, 정밀 주석)을 통해 구축된 CodeCap-Bench를 제안하며, 5개 범주의 323개 비디오 데이터셋을 활용해 모델의 캡셔닝 능력을 다각도로 검증한다 [Figure 2, Figure 3]. 제안된 평가 프레임워크는 렌더링된 비디오의 시각적 유사도, 객체별 IoU, 세부 정보 보존력을 측정한다. 실험 결과, GPT-6-astra 모델이 Agentic 및 Non-agentic 환경 모두에서 가장 높은 성능을 보였으며, 특히 GPT-6-astra는 Codex harness를 활용했을 때 73.24의 정보 보존 점수와 75.37%의 Object-level Spatio-temporal IoU를 기록하며 우위를 점했다 [Table 1]. 또한, 코드 캡션은 기존 자연어 캡션 대비 질문 응답 정확도에서 최대 10.38%p 향상된 성능을 보였고, 비디오 재구성 지표인 AS(Appearance Similarity)와 KSS(Keyframe Structural Similarity)에서도 월등한 결과를 나타냈다 [Table 3].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 비디오 캡셔닝을 위한 보완적 표현 수단으로서 실행 가능한 코드의 유효성을 성공적으로 입증하였다. 실험 결과, 코드 캡션은 자연어 기반 기술보다 비디오의 시각적 상세 정보와 시간적 관계를 더욱 정밀하게 보존함을 확인하였다. 본 연구가 도입한 CodeCap-Bench는 향후 MLLM의 코드 생성 능력과 시각적 이해도를 연결하는 연구의 기초적인 벤치마크로 활용될 것으로 기대된다. 또한, 모델의 사고 노력(Thinking Effort)과 코드 생성 효율성 간의 관계를 분석함으로써 향후 구조적 비디오 이해 연구를 위한 중요한 정량적 데이터를 제공한다.
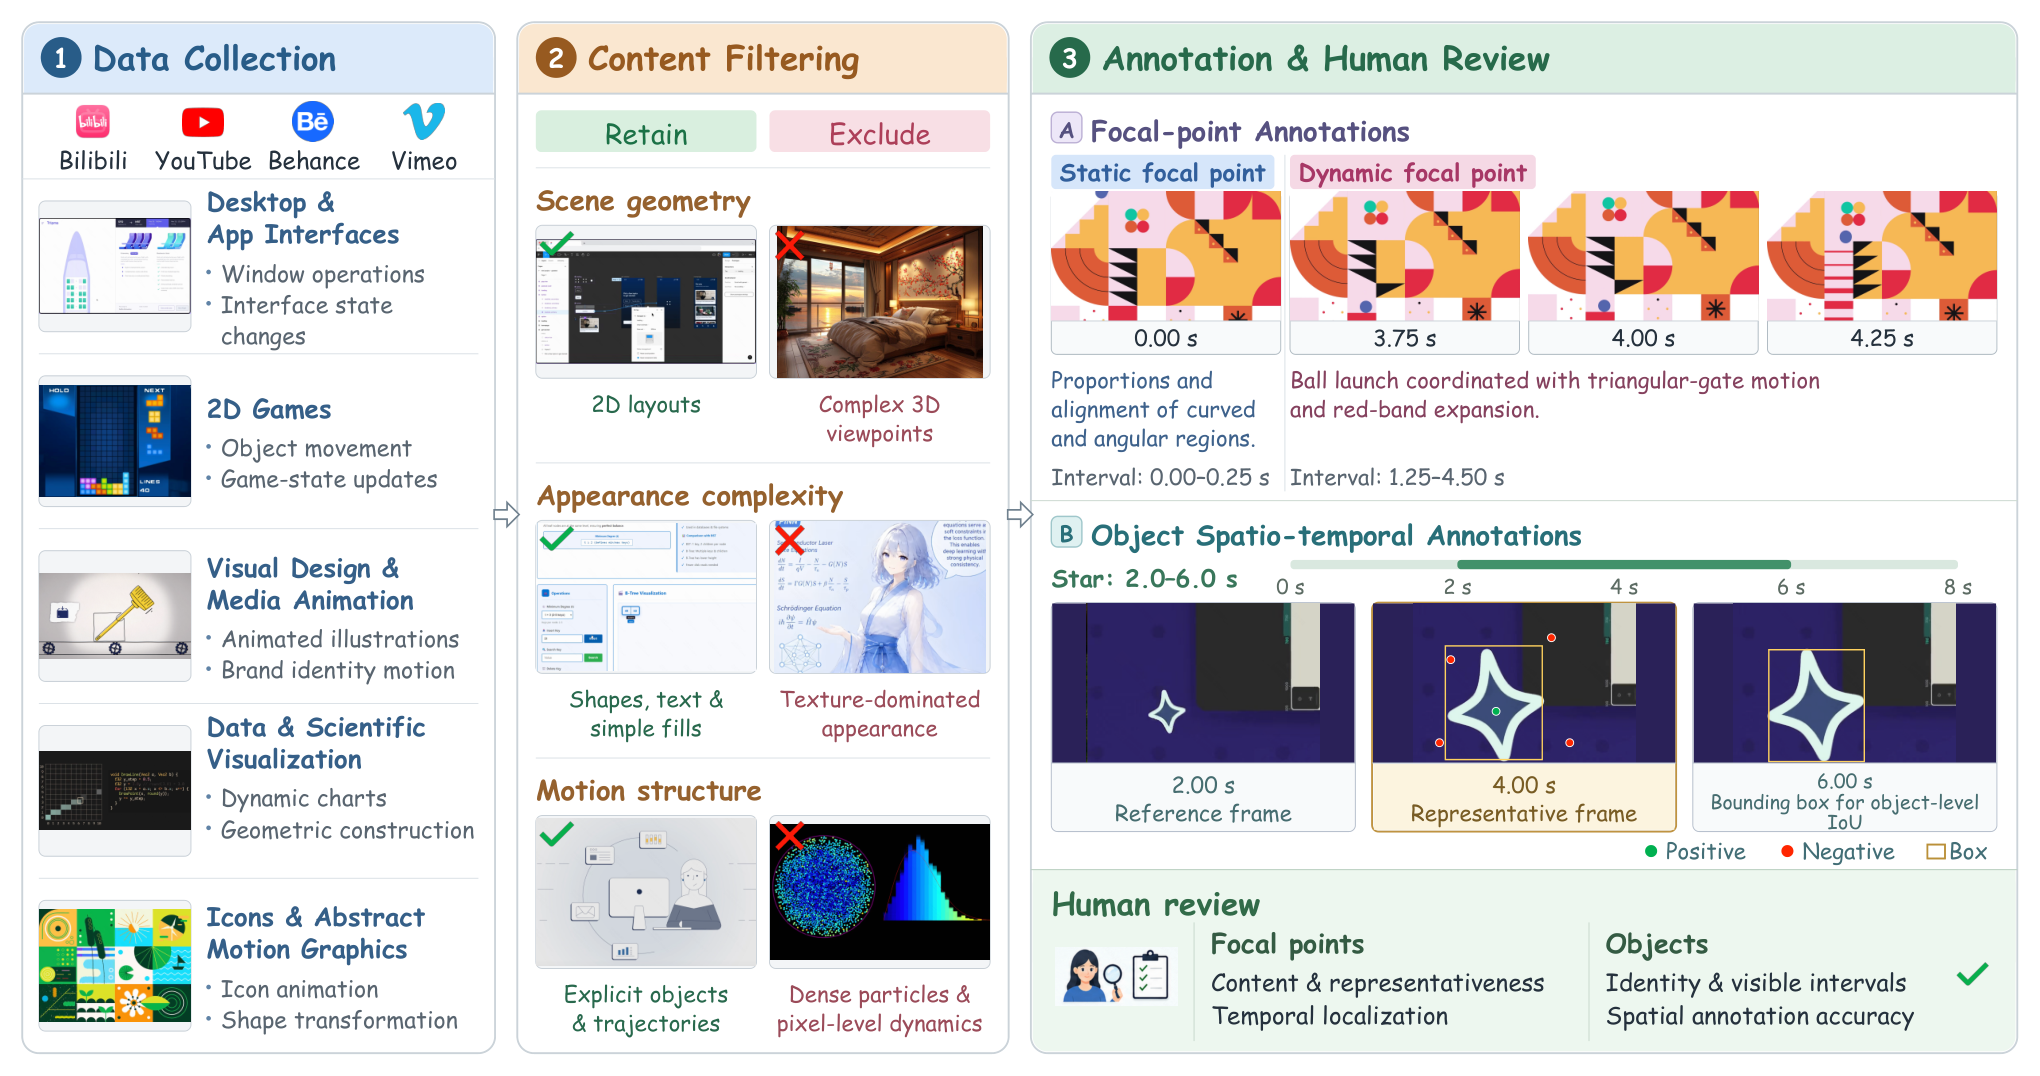
Figure 2 — 데이터 구축 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Towards Universal Video MLLMs with Attribute-Structured and Quality-Verified Instructions
- [논문리뷰] Advances and Frontiers of LLM-based Issue Resolution in Software Engineering: A Comprehensive Survey
- [논문리뷰] ABC-Bench: Benchmarking Agentic Backend Coding in Real-World Development
- [논문리뷰] SWE-EVO: Benchmarking Coding Agents in Long-Horizon Software Evolution Scenarios
- [논문리뷰] Probing Scientific General Intelligence of LLMs with Scientist-Aligned Workflows
Review 의 다른글
- 이전글 [논문리뷰] ChronoReplay: One Answer Interface Is Not Enough for Streaming Spatial Intelligence
- 현재글 : [논문리뷰] CodeCap-Bench: Can Code Serve as a Good Video Caption?
- 다음글 [논문리뷰] Cross-modal Steering Vectors Exist Across Both Image and Text Generation
댓글