[논문리뷰] Cross-modal Steering Vectors Exist Across Both Image and Text Generation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Donghao Zeng, Nishant Subramani, Tamar Rott Shaham, Benno Krojer
1. Key Terms & Definitions (핵심 용어 및 정의)
- Unified Multimodal Models (UMMs): 텍스트와 이미지 토큰을 하나의 공유된 가중치 공간에서 autoregressive 방식으로 생성하는 모델을 지칭합니다.
- Steering Vectors: 모델의 중간 hidden states에 추가하여 특정 개념이나 행동을 인과적으로(causally) 조절할 수 있는 선형 방향(linear direction)을 의미합니다.
- Cross-modal Steering: 한 모달리티에서 추출된 steering vector를 변형 없이 다른 모달리티의 생성 과정에 적용하여 해당 모달리티의 출력을 조절하는 기법입니다.
- Concept Rate: LLM judge를 사용하여 생성된 출력이 steering이 의도한 방향(pole)으로 이동했는지 측정하는 평가지표입니다.
- Cross-modal Recovery: intra-modality(동일 모달리티 내) steering 성능 대비 cross-modal(교차 모달리티) steering 성능의 비율을 나타내며, 전이 학습의 효과를 정량화합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 UMMs 내부에서 텍스트와 이미지라는 서로 다른 모달리티가 어떻게 상호작용하는지, 그리고 특정 개념이 모달리티를 초월하여 공유되는지 탐구합니다. 기존 연구들은 텍스트와 이미지 표현 간의 심각한 모달리티 간극(modality gap)을 지적하며 이들 사이의 기제(mechanism)가 대체로 분리되어 있다고 보았습니다 [Figure 1]. 그러나 이러한 표현적 거리와는 별개로, 생성 모델의 행동을 제어하는 인과적 방향성이 모달리티를 넘어 존재할 수 있는지에 대해서는 명확히 밝혀지지 않았습니다. 저자들은 이 문제를 해결하기 위해 한 모달리티에서 학습된 steering vector가 다른 모달리티에서 zero-shot으로 전이되는지를 확인하고자 합니다.
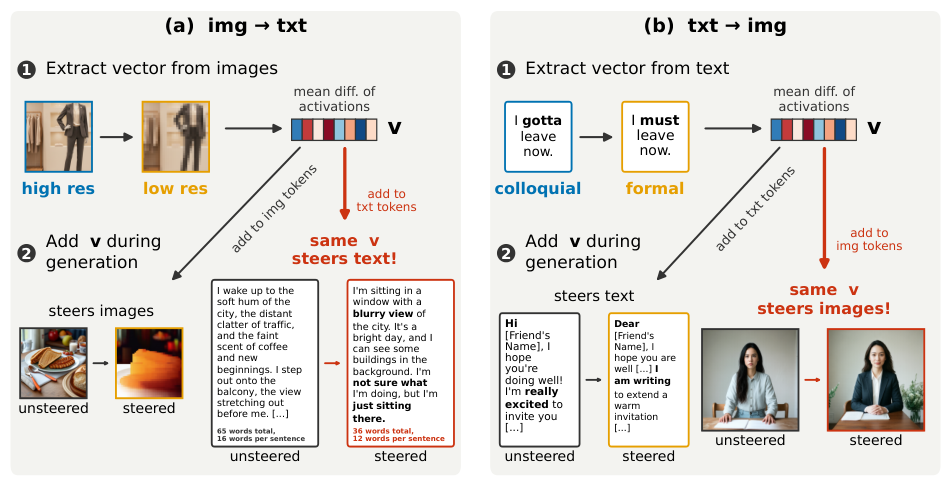
Figure 1 — Cross-modal steering 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 최소 쌍(minimal pairs) 데이터를 사용하여 각 모달리티별로 steering vector를 추출하고, 이를 다른 모달리티의 생성 과정 중간 레이어에 적용하는 방법론을 제안합니다 [Figure 1]. 실험 결과, UniAR, Emu3.5, Liquid와 같은 UMMs에서 텍스트와 이미지 간의 성공적인 cross-modal steering이 확인되었습니다. 정량적으로 UniAR 모델의 경우, 중층(middle layer)에서 텍스트 벡터가 이미지 생성에 대해 84%의, 이미지 벡터가 텍스트 생성에 대해 74%의 steering 효과를 회복(recovery)하였습니다 [Table 1]. 특히, 텍스트에서 이미지로의 전이(txt→toimg)가 더 쉬운 경향을 보였으며, 이는 고정된 steering strength 환경에서도 두 모달리티 간의 기하학적 정렬이 존재함을 시사합니다 [Figure 3]. 또한 steering vector 간의 cosine similarity가 높을수록 전이 성능이 우수하다는 기하학적 상관관계를 도출하였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 모델의 내부 표현이 모달리티에 따라 분리되어 있더라도, 그 안에는 모달리티를 관통하는 공통의 인과적 제어 방향이 존재함을 입증하였습니다. 이러한 발견은 시각과 언어가 모델 내부에서 결합되는 방식을 이해하는 새로운 틀을 제공합니다. 향후 이 연구는 특정 모달리티에 국한되지 않는, 보다 일반적이고 강력한 멀티모달 제어 프레임워크를 구축하는 데 중요한 토대가 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] TUNA: Taming Unified Visual Representations for Native Unified Multimodal Models
- [논문리뷰] What Generation Knows: Unlocking Fine-Grained Understanding in Unified Multimodal Models
- [논문리뷰] MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
- [논문리뷰] Can Visual Generation Expand What Unified Multimodal Models Know?
- [논문리뷰] Base Models Can Reason By Taking a Cue From Training Data
Review 의 다른글
- 이전글 [논문리뷰] CodeCap-Bench: Can Code Serve as a Good Video Caption?
- 현재글 : [논문리뷰] Cross-modal Steering Vectors Exist Across Both Image and Text Generation
- 다음글 [논문리뷰] EmbeddingGemma 2: Unified and Efficient Multimodal Representations
댓글