[논문리뷰] Can Visual Generation Expand What Unified Multimodal Models Know?
링크: 논문 PDF로 바로 열기
저자: Wenkai Li, Wenyi Hong, Zhuoyi Yang, Jie Tang
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- KTP (Knowledge Transfer Probing): visual generation supervision을 통해 습득한 지식이 text-only QA에서 얼마나 잘 검색되는지 측정하는 제어된 프로토콜입니다.
- UMM (Unified Multimodal Model): visual understanding과 image generation 능력을 하나의 모델 내에서 결합한 모델입니다.
- Textual Accessibility: 모델이 이미지 입력 없이 text-only 질문에 대해 학습된 지식을 올바르게 답변할 수 있는 정도를 나타내는 지표입니다.
- Visual CoT (Visual Chain-of-Thought): 텍스트로 바로 답변하는 대신, 모델이 이미지를 생성하고 해당 시각적 정보를 추론 과정에 통합하여 최종 답변을 도출하는 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 UMM이 image generation을 통해 습득한 시각적 지식이 실제 언어 모델의 추론(textual answer)에 얼마나 효과적으로 전이되는지를 규명하고자 합니다. 기존 연구들은 visual-language co-training이 성능 향상에 기여함을 보였으나, 생성 단계에서 습득된 특정 지식이 텍스트로 변환(retrieval)될 때 발생하는 단절인 'modal aphasia' 현상을 충분히 설명하지 못했습니다. 저자들은 이러한 지식 접근의 불일치를 측정하기 위해, 사전 학습된 지식과의 간섭을 최소화한 가상의 entity-attribute triplet 기반의 데이터셋을 구축하여 [Figure 2]와 같이 통제된 실험을 수행하였습니다.
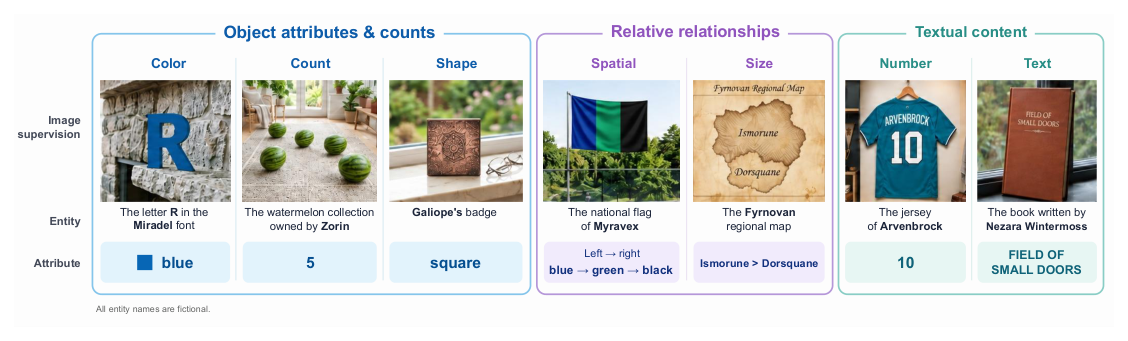
Figure 2 — 실험에 사용된 7가지 지식 카테고리와 entity-attribute triplet 예시를 체계적으로 보여줌
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 visual generation supervision 후 Textual Alignment와 Interleaved Image–Text Alignment라는 두 가지 보조 학습 전략을 적용하여 지식 전이를 강화합니다. 실험 결과, 단순 T2I training만으로는 textual accessibility가 매우 낮으나, Interleaved Image–Text Alignment를 통해 모델의 성능이 유의미하게 향상됨을 확인하였습니다. [Table 1]에 따르면, 직접적인 지식 전이(direct transfer) 조건에서 SenseNova-U1 모델은 size 카테고리에서 68.0%의 정확도를 보였으나, 다른 모델들은 대다수 카테고리에서 낮은 성능을 기록했습니다. 또한 [Table 2]를 통해 Interleaved alignment가 textual alignment보다 더 높은 평균 정확도를 제공하며, 특히 GLM-Omni 모델의 경우 shape 카테고리에서 12%에서 64%로의 큰 성능 개선을 보였습니다. 추가로 [Table 3]에 제시된 Visual CoT 도입 결과, GLM-Omni는 text-only 조건 대비 average 정확도를 26.86%에서 41.14%까지 크게 끌어올리며 시각적 정보가 추론에 강력한 매개체 역할을 함을 증명하였습니다.
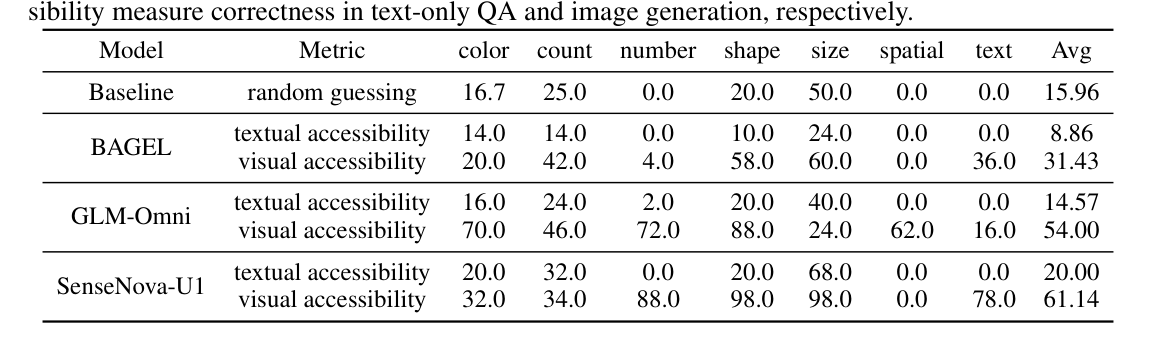
Table 1 — 각 모델별 카테고리별 시각적 및 텍스트적 접근성 지표를 정량적으로 비교함
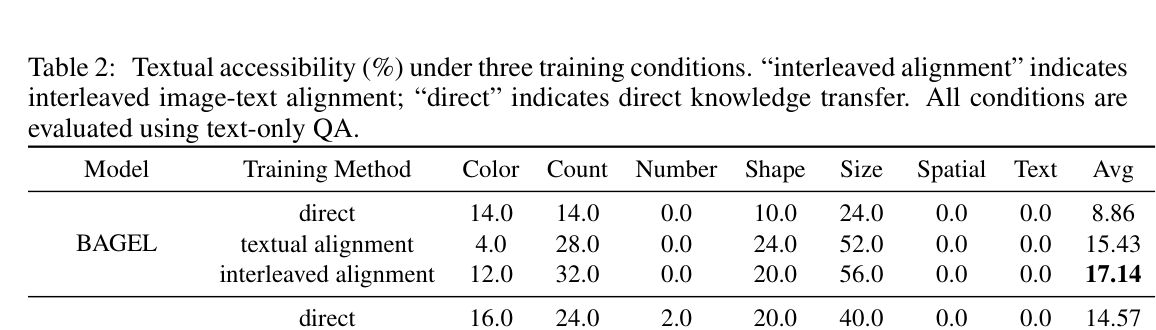
Table 2 — 세 가지 학습 조건에 따른 모델의 지식 전이 효율을 비교한 핵심 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 visual generation 학습이 UMM의 지식 확장에 기여할 수 있지만, 지식이 시각적으로 표현되는 것과 텍스트로 인출되는 것 사이에는 상당한 격차가 존재함을 입증했습니다. 저자들은 인터리브된 형태의 시각적·텍스트적 통합 학습이 이러한 격차를 줄이는 데 매우 효과적임을 확인하였습니다. 본 연구의 결과는 향후 UMM의 효율적인 지식 전이 아키텍처 설계와 데이터 조직화 방식에 중요한 가이드라인을 제시하며, 시각적 기반의 추론 능력 강화가 foundation model의 다중 모달 성능을 극대화하는 핵심 요소임을 시사합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards
- [논문리뷰] Adversarial Training for Pixel Diffusion
- [논문리뷰] Learning Native Reflection in Unified Models with Interleaved Reinforcement Learning
- [논문리뷰] Uncovering Understanding-Generation Synergy in Native Unified Multimodal Models: From Representation, Task to System
- [논문리뷰] ContextBias: Controlled Evaluation of Bias Persistence Under Context Shift in Text-to-Image Models
Review 의 다른글
- 이전글 [논문리뷰] BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
- 현재글 : [논문리뷰] Can Visual Generation Expand What Unified Multimodal Models Know?
- 다음글 [논문리뷰] Consistent Distribution Matching for Data-Free Diffusion Distillation
댓글