[논문리뷰] MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
링크: 논문 PDF로 바로 열기
저자: Houyuan Chen, Fanzhou Wang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Multi-Turn Image Editing: 일련의 사용자 지침에 따라 이미지를 점진적으로 수정하는 Task를 의미합니다. 이는 사용자가 연속적인 편집을 통해 시각적 콘텐츠를 지속적으로 개선할 수 있게 합니다.
- Autoregressive Diffusion: UMM(Unified Multimodal Model) 내에서 각 편집이 이전 단계의 결과에 기반하여 순차적으로 이루어지는 인과적(causal) 방식으로 시각적 콘텐츠를 생성하는 Diffusion Model 접근 방식입니다.
- Unified Multimodal Models (UMMs): 텍스트 및 이미지와 같은 다양한 양식을 통합하여 시각적 이해, 생성 및 편집 작업을 수행하는 모델입니다.
- Single-Turn Distribution Matching Distillation (Single-Turn DMD): Multi-Turn Image Editing에서 발생하는 시각적 품질 저하를 상쇄하기 위해 제안된 방법론으로, 단일 턴 편집 Teacher 모델의 출력 분포를 Student 모델의 Rollout 출력 분포와 일치시킴으로써 품질 기준을 제공합니다.
- Teacher-Forcing Guidance: 참조 궤적(reference trajectories)에 대한 Teacher Forcing 기법을 통해 Cross-Turn Content Consistency를 장려하는 훈련 기법입니다. 이는 Warmup 및 Distillation 과정에서 적용됩니다.
- Exposure Bias: 훈련 시에는 참조 이력(reference histories)에 조건화되지만, 추론 시에는 자체 생성된 불완전한 이력에 재귀적으로 조건화되면서 발생하는 불일치 현상입니다. 이는 오류 누적을 유발합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Multi-Turn Image Editing은 일련의 지침에 따라 이미지를 점진적으로 수정함으로써 사용자에게 보다 효과적인 인터랙티브 시각 콘텐츠 생성을 가능하게 합니다. 그러나 기존 방법들은 몇 번의 편집 턴(turn)만 거쳐도 눈에 띄는 "Drift" 현상을 자주 보이며, 이는 두 가지 측면에서 나타납니다. 첫째, 시각적 품질(Visual Quality)이 불안정해져 Artifacts가 누적되고 디테일이 저하됩니다. 둘째, 이미지 콘텐츠(Image Content)가 일관성을 잃어, 보존되어야 할 영역이나 이전 편집 내용이 의도치 않게 변경되는 문제가 발생합니다. 이러한 문제의 근본 원인은 "Exposure Bias"로, 모델이 훈련 시에는 일관된 참조 이력에 조건화되지만, 실제 추론 시에는 자체적으로 생성한 불완전한 이력에 재귀적으로 조건화되기 때문에 오류가 누적되기 때문입니다. 본 논문은 이러한 Exposure Bias와 그로 인한 Multi-Turn Editing의 불안정성 및 불일치성 문제를 해결하고자 합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Autoregressive Diffusion 기반의 UMM(Unified Multimodal Model)을 활용한 Multi-Turn Image Editing에서 안정성(Stability)과 일관성(Consistency)을 확보하기 위한 새로운 훈련 패러다임인 MT Forcing을 제안합니다. MT Forcing은 크게 두 가지 핵심 구성 요소로 이루어져 있습니다 [Figure 2].
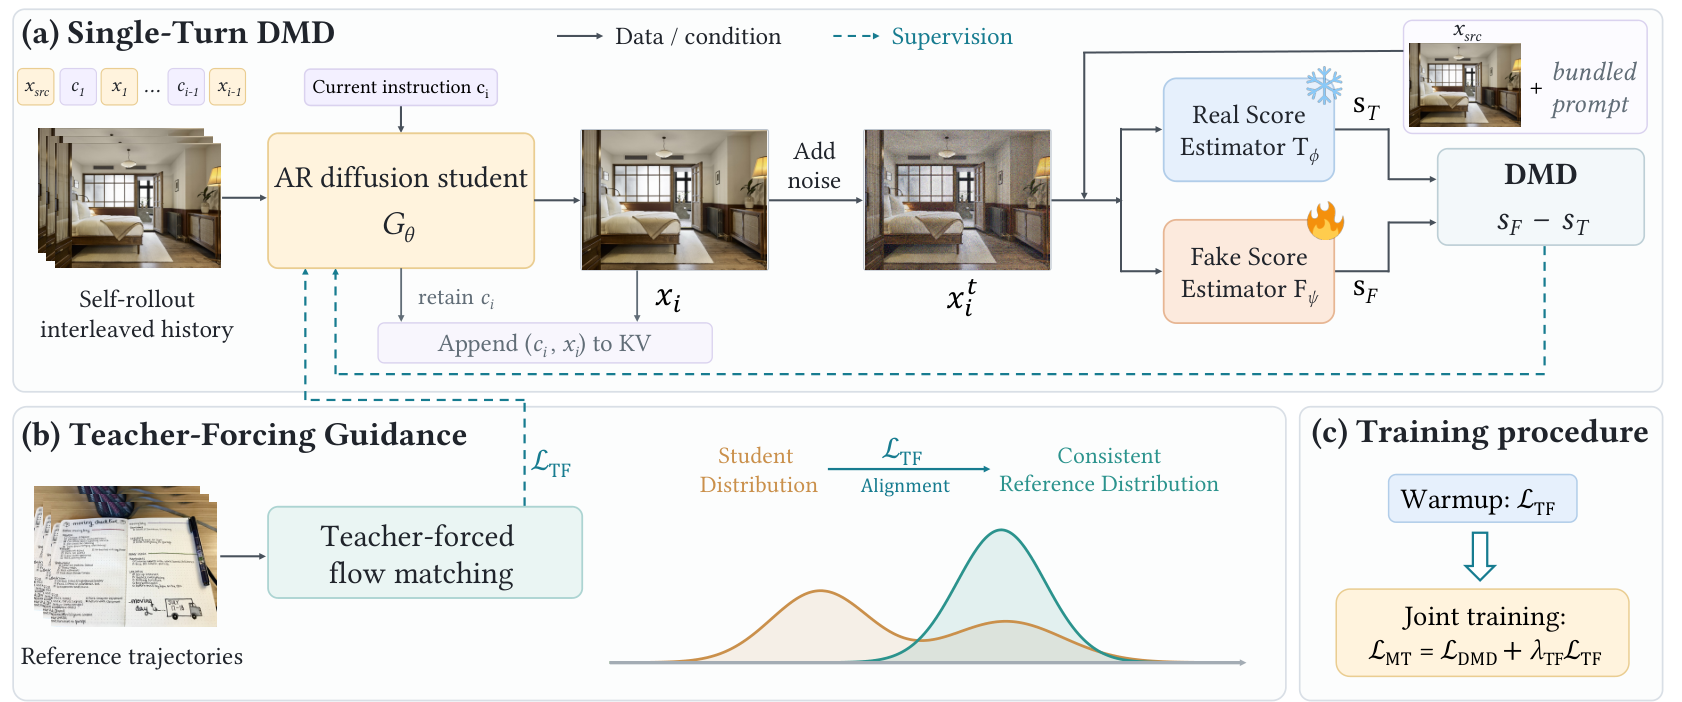
Figure 2 — MT Forcing 방법론 상세
첫째, 시각적 품질 Drift를 해결하기 위해 Single-Turn Distribution Matching Distillation (Single-Turn DMD)을 도입합니다 [Figure 2a]. 이 방법은 모든 누적된 지침(cumulative instructions)을 단일 편집 의도(bundled prompt)로 재구성하여 원본 이미지에 직접 적용하는 단일 턴 편집 Teacher 모델을 사용합니다. Teacher는 교차 턴 오류 누적(cross-turn error accumulation) 없이 고품질의 출력을 제공하며, Student 모델의 Rollout 출력 분포가 이 Teacher의 단일 턴 출력 분포와 일치하도록 DMD Loss를 통해 학습됩니다. 이 과정에서 Student는 추론 시 발생하는 불완전한 이력(imperfect histories) 하에서도 시각적 품질을 유지하도록 훈련되어 Exposure Bias를 완화합니다.
둘째, Cross-Turn Content Consistency를 향상시키기 위해 Teacher-Forcing Guidance를 제안합니다 [Figure 2b]. 이는 일관된 참조 궤적(consistent reference trajectories)에 대한 Teacher Forcing 기법을 활용하며, 두 단계로 적용됩니다. 먼저, Teacher-Forcing Warmup 단계에서 사전 학습된 편집기(pretrained editor)를 참조 Multi-Turn Context에 적응시키기 위해 Supervised Fine-tuning을 수행합니다. 이어서 Teacher-Forcing Regularization 단계에서는 Distillation 과정 중에도 낮은 가중치로 이 참조 기반 Supervision을 유지하여, Marginal Distribution Matching만으로는 보장하기 어려운 이력 의존적 행동(history-dependent behavior)과 Cross-Turn Consistency를 보존합니다. 이 두 구성 요소는 상호 보완적으로 작동하여 MT Forcing의 전체 훈련 절차를 구성합니다 [Figure 2c].
광범위한 실험 결과는 MT Forcing의 우수성을 입증합니다. MT Forcing은 SenseNova-U1 및 SenseNova-U1.5 기반 모델에 적용되었을 때, 모든 턴에서 기존 Baseline 모델들보다 뛰어난 성능을 보였습니다 [Figure 5]. 특히, Instruction Following (IF), Content Consistency (CC), 및 Drift Robustness Score (DRS) 세 가지 Metric에서 Turn 4 이후부터 현저히 개선된 성능을 나타냈습니다. Turn 8에서는 SenseNova-U1에서 IF가 7.45포인트, CC가 6.82포인트 향상되었으며, SenseNova-U1.5에서는 IF가 4.65포인트, CC가 4.46포인트 개선되었습니다. SenseNova-U1.5에서 DRS는 4.20에서 4.35 사이를 유지하며 Baseline의 4.09에서 3.03으로 하락하는 것과 대조를 이루었습니다. 또한, 연속적인 편집 출력 간의 기하학적 정렬을 측정하는 새로운 Metric인 Pixel 값은 SenseNova-U1.5에서 8-턴 평균이 6.34에서 0.74로 88.4% 감소하여 Content Preservation이 크게 개선되었음을 보여줍니다 [Table 1, cite: 1]. Ablation Study 결과, Single-Turn DMD와 Teacher-Forcing Guidance 모두 단독으로 Baseline보다 성능을 향상시키지만, 두 요소를 결합한 Full MT Forcing이 9.66 IF, 8.40 CC, 4.30 DRS, 0.74 Pixel로 가장 우수한 8-턴 평균 성능을 달성했습니다 [Table 2, cite: 1]. 이는 두 구성 요소의 상호 보완적인 이점을 시사합니다 [Figure 6].
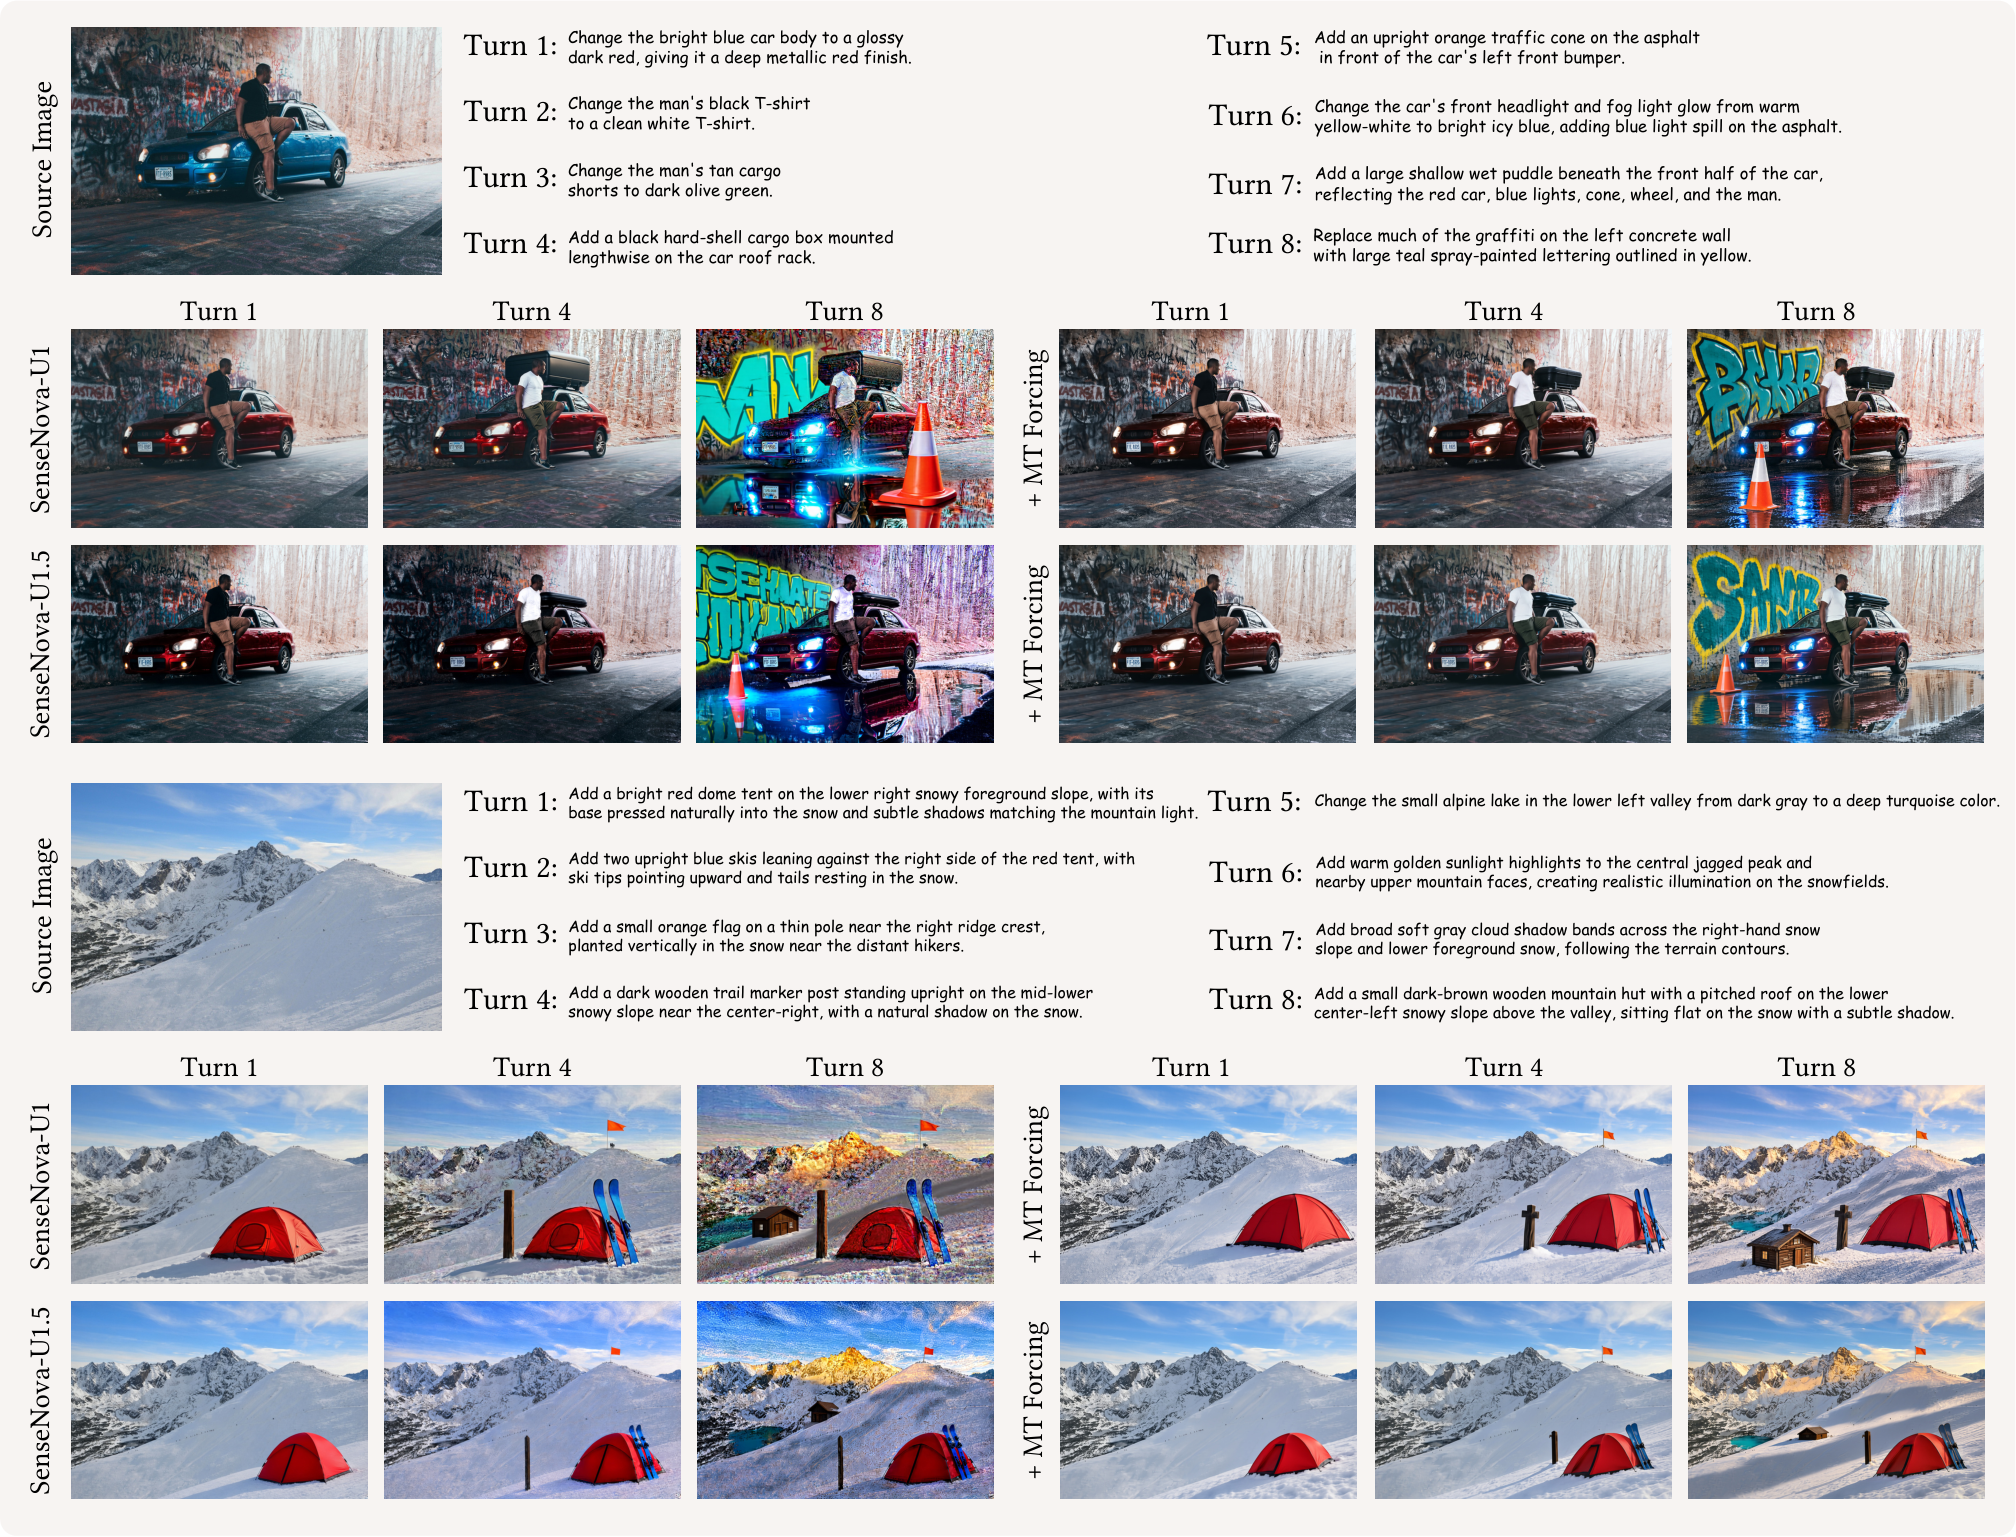
Figure 5 — 정성적 비교 결과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Autoregressive UMM을 이용한 Multi-Turn Image Editing에서 안정성 및 일관성 문제를 해결하기 위한 훈련 패러다임인 MT Forcing을 제안합니다. MT Forcing은 Single-Turn DMD를 통해 Teacher의 고품질 단일 턴 편집 의도를 Student Rollout에 전이시켜 시각적 품질 저하를 방지하고, Teacher-Forcing Guidance를 통해 참조 이력에 대한 Supervision으로 Content Consistency를 강화합니다. 광범위한 실험을 통해 MT Forcing은 Instruction Following, Content Consistency, Drift Robustness 등의 Metric에서 Baseline 대비 상당한 개선을 이루었으며, 특히 후반 턴으로 갈수록 그 이점이 더욱 두드러졌습니다. 이 연구는 기존 Multi-Turn Image Editing의 주요 한계점인 Drift 현상을 효과적으로 완화하여, 학계 및 산업계에서 보다 안정적이고 일관된 Interactively Visual Content Creation을 가능하게 하는 새로운 방법론을 제시합니다. 이는 미래의 Multi-Turn Image Editing 시스템 개발에 중요한 시사점을 제공합니다.
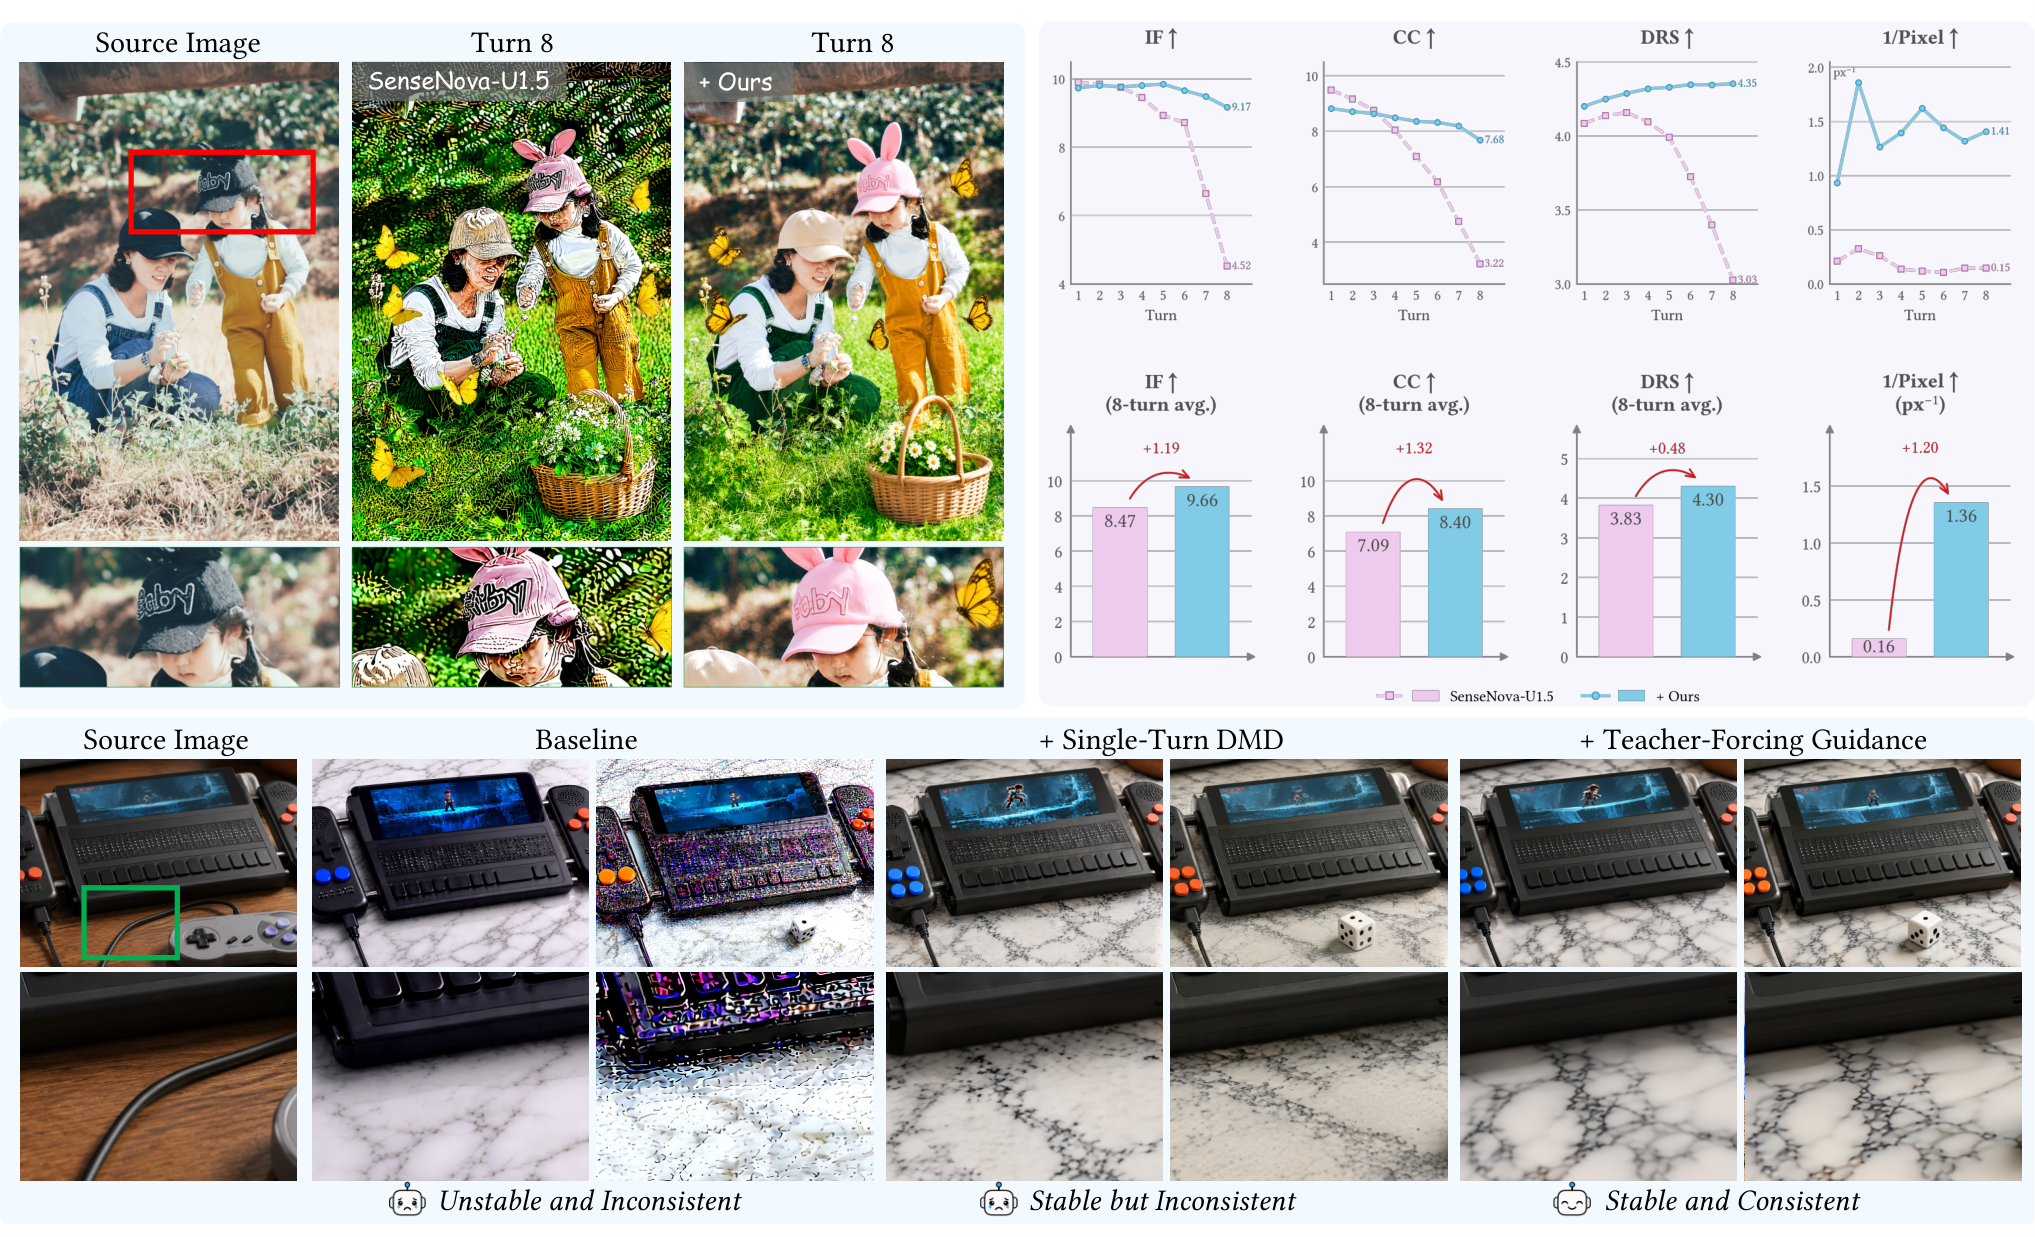
Figure 1 — MT Forcing 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MTEdit: Packed Trajectories Beat Rollouts for Multi-Turn Image Editing
- [논문리뷰] Can Visual Generation Expand What Unified Multimodal Models Know?
- [논문리뷰] AgentGarten: Code Worlds for Evolving Agents
- [논문리뷰] DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation
- [논문리뷰] Rollout-Marginal Distillation for Long-Horizon Autoregressive Video Generation
Review 의 다른글
- 이전글 [논문리뷰] Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
- 현재글 : [논문리뷰] MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
- 다음글 [논문리뷰] Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
댓글