[논문리뷰] Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
링크: 논문 PDF로 바로 열기
저자: Mengtan Zhang, Yuchuan Cui, Yu Ma, Zizhan Guo, Wei Ye, Rui Fan
1. Key Terms & Definitions (핵심 용어 및 정의)
- SSMDE (Self-Supervised Monocular Depth Estimation): 레이블이 없는 단일 영상 시퀀스를 활용하여 장면의 깊이 정보를 추정하는 학습 패러다임입니다.
- VFM (Vision Foundation Model): 대규모 데이터셋으로 사전 학습되어 일반적인 시각적 특징 추출 능력이 뛰어난 모델(예: DINOv2)을 의미합니다.
- Structural Representation: 장면의 기하학적 구조와 레이아웃을 인코딩하는 특징으로, 데이터셋 고유의 편향에서 벗어나 범용적인 깊이 추론을 가능하게 합니다.
- Contextual Representation: 객체 수준의 공간적 관계와 같은 의미론적 특징을 포함하며, VFM의 사전 학습된 지식을 기반으로 깊이 정보를 보완합니다.
- Anchored-Decoupled Feature Projectors: Contextual 특징은 VFM에 고정(Anchor)하고, Structural 특징은 이와 분리(Decouple)하여 학습하도록 설계된 모듈입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 SSMDE 모델들이 다양한 도메인의 데이터를 통합 학습할 때 성능이 저하되는 현상을 해결하는 것을 목표로 합니다. 저자들은 모델이 데이터셋 고유의 구조적 편향(structural biases)을 과도하게 인코딩하여, 이기종 데이터 환경에서 최적화 충돌이 발생함을 발견했습니다 [Figure 1]. 이러한 편향은 DepthNet의 중간 특징 활성화 맵에 이미 내재되어 있어 범용적인 기하학적 특징 추출을 방해합니다 [Figure 2]. 따라서, 데이터셋에 독립적인 일반화 가능한 구조적 특징을 명시적으로 학습할 수 있는 확장 가능한 프레임워크가 절실히 요구됩니다.
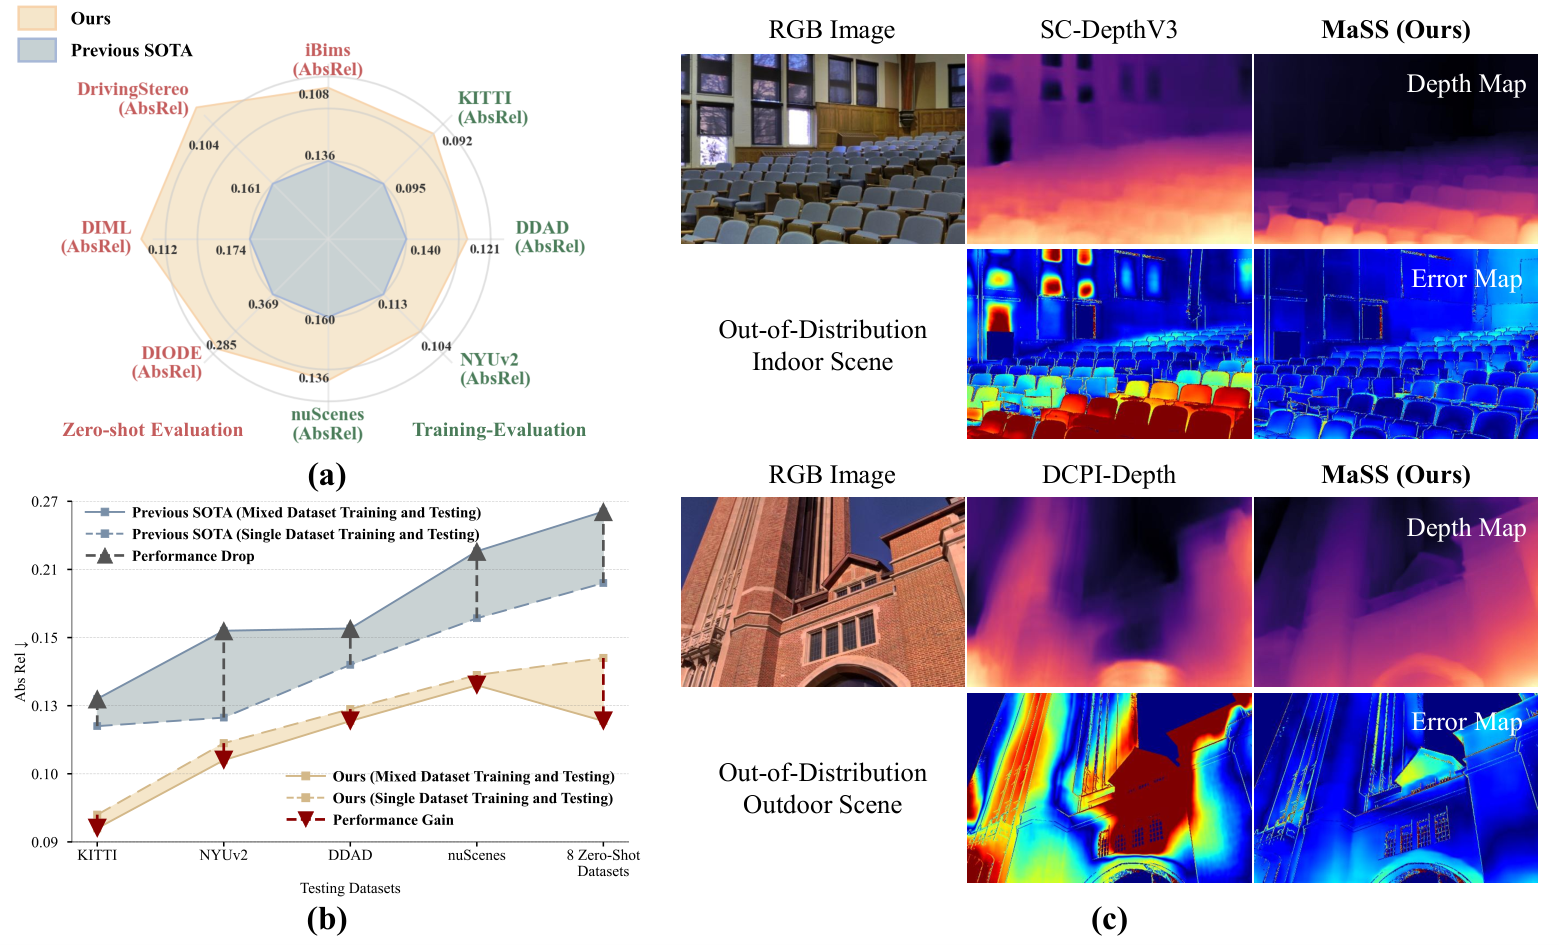
Figure 1 — MaSS의 성능 및 확장성 요약
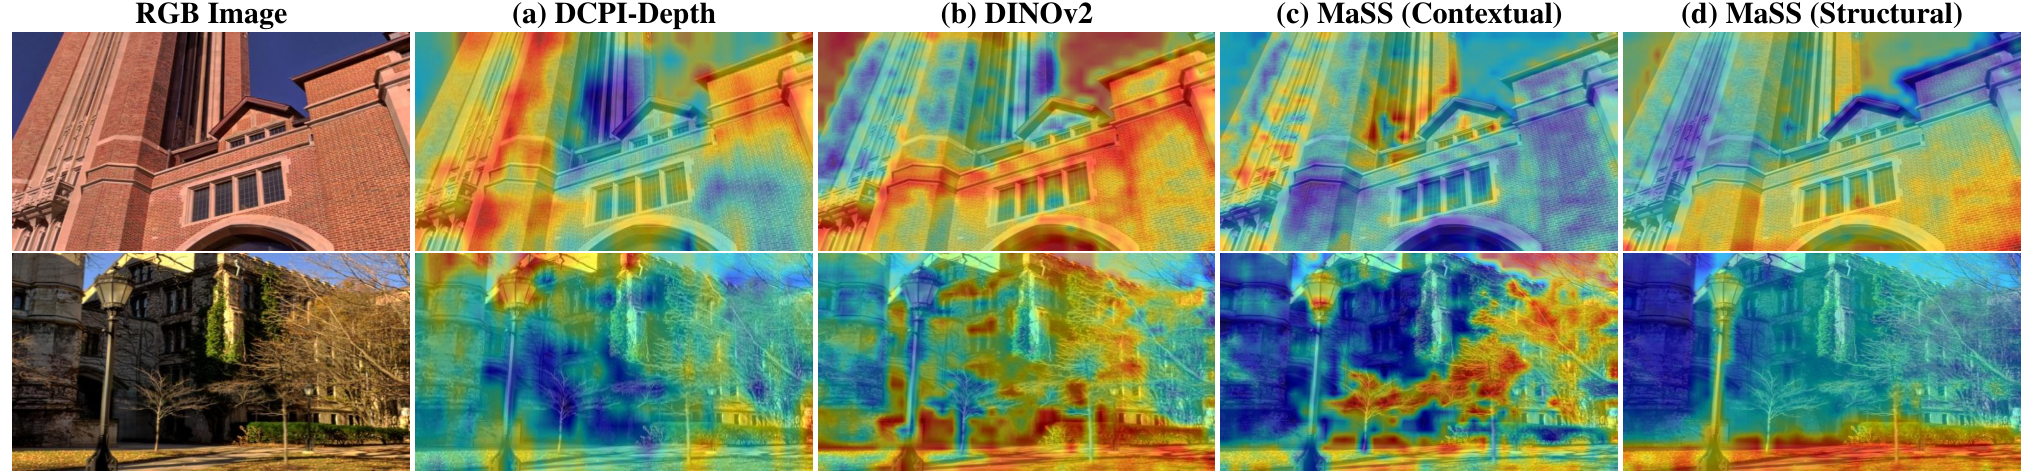
Figure 2 — 특징 활성화 맵 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 MaSS (Make Self-supervised depth learning Scalable) 프레임워크를 제안하여 Depth Encoder와 사전 학습된 VFM을 양방향 상호작용 아키텍처로 결합합니다 [Figure 3]. MaSS의 핵심은 Scene-Structure Discrimination 목적 함수를 통해 Structural Representation을 명시적으로 학습하는 것입니다. 이는 깊이 맵의 히스토그램 기반 구조적 불일치 메트릭을 사용하여 유사한 레이아웃의 장면을 클러스터링하는 대조 학습(Contrastive Learning)을 수행합니다. 제안된 방법론은 KITTI, DDAD, NYUv2, nuScenes 등의 데이터셋에서 이전 SoTA 모델들(예: SC-DepthV3, DCPI-Depth)을 크게 상회하는 성능을 보였습니다 [Table 1]. 특히, 혼합 도메인 학습(Mixed-dataset training) 설정에서 MaSS는 유일하게 데이터 다양성 증가로부터 긍정적인 성능 향상을 보였으며, 일반화 성능 또한 Zero-shot 환경에서 우수한 지표(Abs Rel, δ1)를 달성했습니다 [Table 1, Table 2].
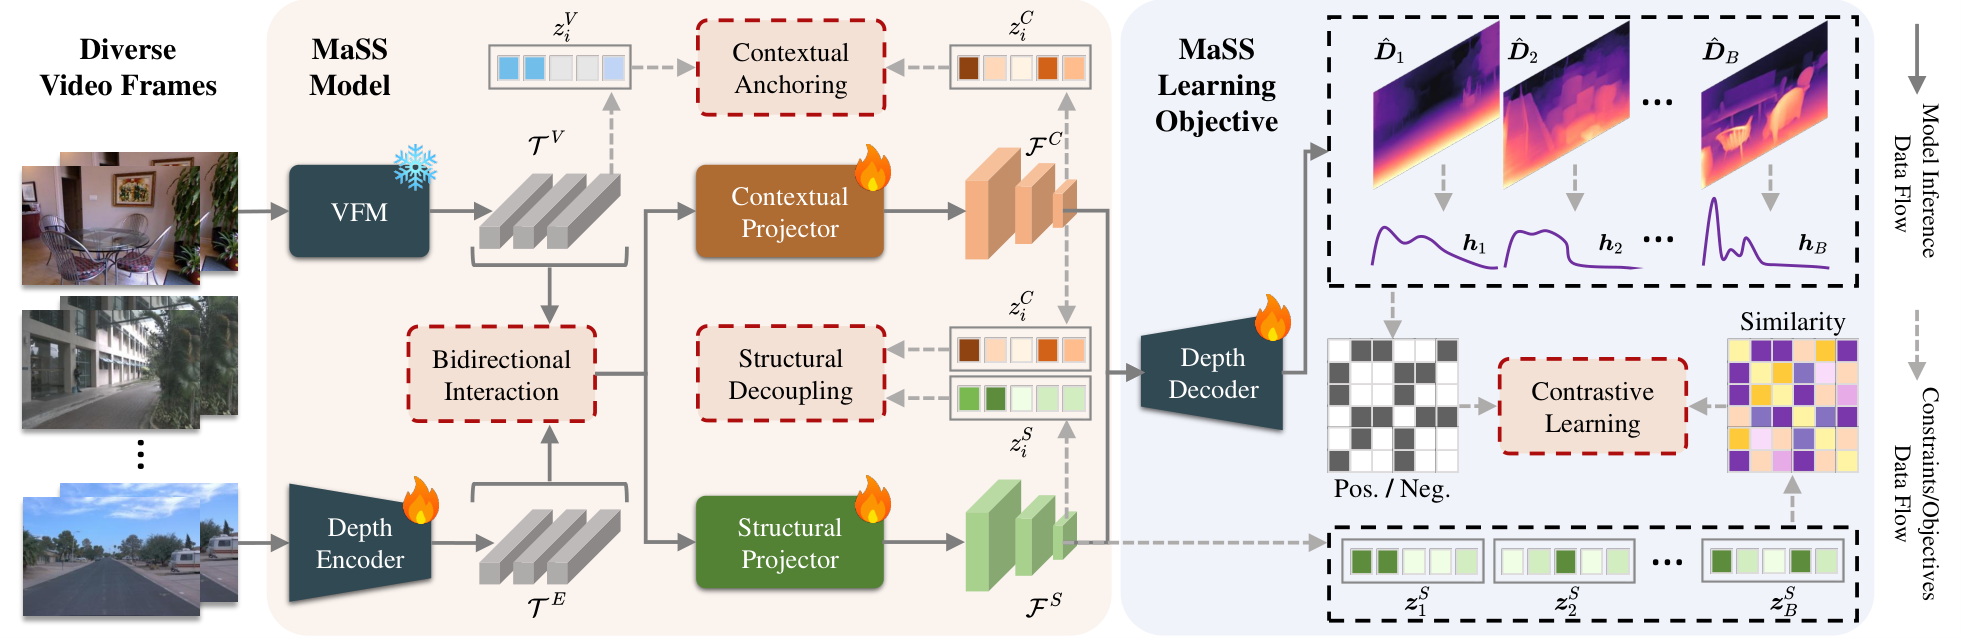
Figure 3 — MaSS 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 장면의 구조적 특징을 식별하는 학습이 SSMDE의 확장성과 일반화 성능을 극대화하는 열쇠임을 입증했습니다. MaSS는 기존 방식의 한계였던 도메인 간 최적화 충돌을 해결하고, 다양한 시나리오에 걸쳐 강건한 깊이 추론 능력을 보여주었습니다. 이 연구는 레이블이 없는 대규모 데이터셋을 효과적으로 활용하는 방향을 제시함으로써, 향후 자율 주행 및 로봇 비전 분야의 깊이 인식 Foundation Model 개발에 중요한 학술적/산업적 이정표를 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
- [논문리뷰] RaysUp: Ultra-light Universal Feature Upsampling via Geometry-Aware Ray Representation
- [논문리뷰] IDEAL: In-DEpth ALignment Makes A Discrete Representation AutoEncoder
- [논문리뷰] SOCO: Benchmarking Semantic Object Correspondence in Vision Foundation Models
- [논문리뷰] DecQ: Detail-Condensing Queries for Enhanced Reconstruction and Generation in Representation Autoencoders
Review 의 다른글
- 이전글 [논문리뷰] Learning from Fleet Experience: A Collective Learning Paradigm for Robots
- 현재글 : [논문리뷰] Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
- 다음글 [논문리뷰] MT Forcing: Towards Stable and Consistent Multi-Turn Image Editing with Autoregressive Diffusion
댓글