[논문리뷰] EmbeddingGemma 2: Unified and Efficient Multimodal Representations
링크: 논문 PDF로 바로 열기
메타데이터
저자: Henrique Schechter Vera, Sahil Dua, Jovan Andonov, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- EmbeddingGemma 2: Text, Image, Audio, Video 및 혼합 입력을 단일 벡터 공간으로 매핑하는 744M 파라미터 규모의 통합 멀티모달 임베딩 모델입니다.
- Per-Layer Embeddings (PLE): 모델의 각 레이어에 입력 토큰 정보를 직접 전달하는 기법으로, 본 논문에서는 별도의 Lookup Table 없이 Projection-only 방식을 통해 효율성을 극대화합니다.
- Matryoshka Representation Learning (MRL): 하나의 임베딩 벡터 내에 서로 다른 차원의 정보를 계층적으로 포함하여, 단일 모델로 다양한 차원(예: 768, 512, 256, 128)의 임베딩 출력을 지원하는 기술입니다.
- Quantization-Aware Training (QAT): 양자화로 인한 성능 저하를 최소화하기 위해 학습 과정에서 양자화 효과를 반영하여 모델을 최적화하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 멀티모달 임베딩 모델들이 가진 높은 컴퓨팅 비용과 제한적인 입력 처리 능력 문제를 해결하고자 합니다. 기존의 Specialist 모델들은 단일 모달리티에 최적화되어 있어 혼합 모달리티 입력의 상호작용을 파악하기 어렵고, 최근의 MLLM 기반 모델들은 지나치게 큰 파라미터 규모로 인해 Latency-sensitive한 환경이나 On-device 배포에 제약이 많습니다. 저자들은 744M 파라미터의 효율적인 아키텍처를 통해 다양한 모달리티를 통합하고, 높은 성능을 유지하면서도 배포 유연성을 제공하는 새로운 모델을 제안합니다 [Figure 1].
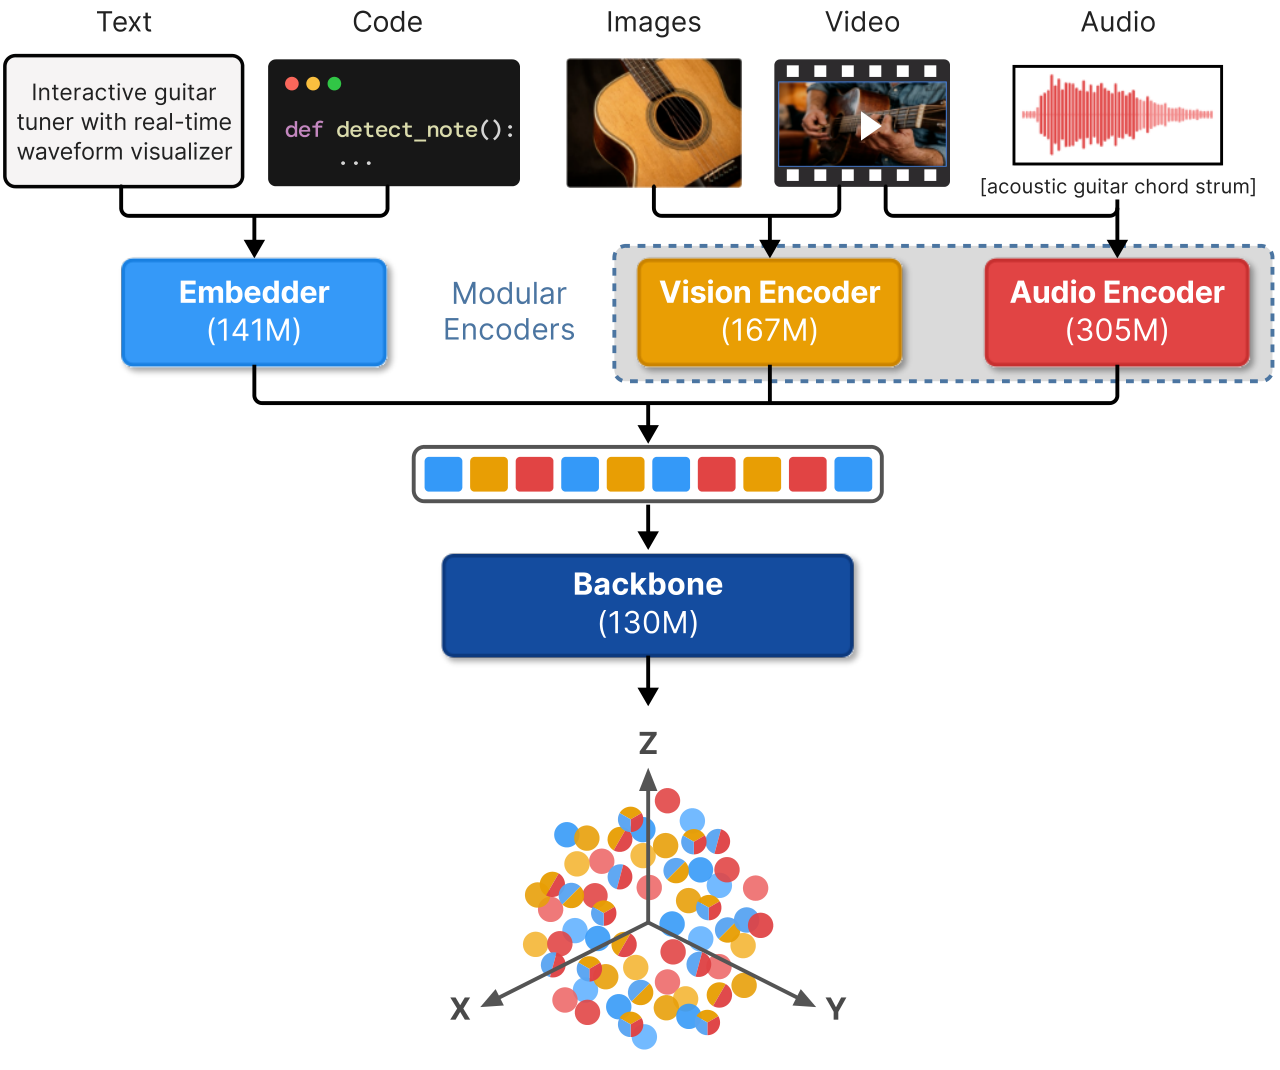
Figure 1 — 모델 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 세 단계(Text Pre-finetuning, Multimodal Pre-finetuning, Multimodal Finetuning)로 구성된 커리큘럼 학습을 통해 EmbeddingGemma 2를 최적화합니다. 특히, 별도의 PLE Lookup Table을 제거하고 Shared Embedding 기반의 Projection-only 방식을 채택하여 파라미터 효율성을 높였으며, Vision Encoder를 함께 학습시켜 멀티모달 성능을 향상시켰습니다 [Table 2]. 주요 실험 결과, 이 모델은 MTEB(Code) 벤치마크에서 78.68을 기록하는 등 이전 세대 모델 대비 현저한 성능 향상을 보였으며, 여러 멀티모달 벤치마크에서 훨씬 큰 규모의 모델들과 대등하거나 더 우수한 성능을 입증하며 새로운 Pareto frontier를 구축하였습니다 [Figure 2]. 또한, QAT를 적용하여 int4 양자화 시에도 높은 정확도를 유지하며, On-device 환경에서 191~567MB 수준의 메모리 점유율로 구동 가능한 효율성을 확보했습니다 [Table 1].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 고성능과 효율성을 동시에 갖춘 통합 멀티모달 임베딩 모델인 EmbeddingGemma 2를 성공적으로 제시하였습니다. 이 모델은 다양한 모달리티를 하나의 통합 공간으로 매핑함으로써 정보 검색, 시각적 질의응답 등 복잡한 멀티모달 태스크에 대한 새로운 기준을 마련했습니다. 본 연구의 결과물은 특히 리소스가 제한된 환경에서 고품질의 임베딩 서비스를 제공하려는 학계와 산업계에 중요한 기술적 이정표가 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WeMM-Embedding: WeChat Multi-Modal Embedding Technical Report
- [논문리뷰] CORE: Improving Compositional Reasoning in MLLM Embedding via Reranker Distillation
- [논문리뷰] Douyin Multimodal Embedding Model Technical Report
- [논문리뷰] MERIT: Learning Disentangled Music Representations for Audio Similarity
- [논문리뷰] TabEmbed: Benchmarking and Learning Generalist Embeddings for Tabular Understanding
Review 의 다른글
- 이전글 [논문리뷰] Cross-modal Steering Vectors Exist Across Both Image and Text Generation
- 현재글 : [논문리뷰] EmbeddingGemma 2: Unified and Efficient Multimodal Representations
- 다음글 [논문리뷰] HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
댓글