[논문리뷰] Memory Tax: Dissecting the Net Value of Agent Memory
링크: 논문 PDF로 바로 열기
The paper "Memory Tax: Dissecting the Net Value of Agent Memory" analyzes the effectiveness of memory systems in long-horizon LLM agents compared to naive RAG.
Authors: Xuan He, Sining Zhoubian, Ruozhen Yang, et al.
Keywords: LLM Agents, Long-term Memory, Memory Tax, Memory Benefit, Naive RAG, Information Preservation, Retrieval Accessibility, Robustness
1. Key Terms & Definitions (핵심 용어 및 정의)
- Memory Tax: Agent memory 시스템이 raw history로부터 정보를 처리하는 과정에서 발생하는 의도치 않은 정보 손실 또는 접근성 저하로 인해 naive RAG 대비 성능이 저하되는 현상.
- Memory Benefit: Agent memory 시스템이 raw history 대비 정보를 더 잘 조직화하거나 추상화하여 특정 쿼리에 대한 성능을 향상시키는 긍정적인 효과.
- Net Value of Memory: Memory system의 전반적인 성능이 naive RAG 대비 얼마나 향상되거나 저하되는지를 나타내는 지표로, Memory Benefit과 Memory Tax의 균형으로 정의된다.
- Naive RAG (Retrieval-Augmented Generation): Raw history를 최소한으로만 처리(chunking 및 indexing)하고 쿼리 시점에 관련 chunk를 직접 검색하여 답변을 생성하는 기본적인 검색 증강 생성 방식. 본 연구의 성능 평가 기준점(reference)으로 사용된다.
- Retrieval Scope (RS): LLM이 검색부터 답변 생성까지 보게 되는 memory unit 내 token의 총량을 시스템의 검색 가능한 전체 memory store 내 token 총량으로 나눈 비율. 각 시스템 간 검색 예산의 공정한 비교를 위해 사용되는 지표이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Long-horizon LLM agents에서 memory의 net value가 raw history로부터 직접 검색하는 것(naive RAG)에 비해 얼마나 가치 있는지 명확히 하는 것을 목표로 한다. 기존 연구들은 다양한 memory representation 및 management mechanism을 도입하며 복잡성을 증가시켜왔지만, 이러한 복잡한 memory system들이 단순한 naive RAG 대비 실제 얼마나 개선되는지에 대한 이해는 부족하다. 많은 memory design들이 naive RAG를 간과하거나, 포함하더라도 설정이 불분명하여 memory 구축의 marginal 또는 net value가 제대로 평가되지 않는 한계가 있었다. 이러한 연구 격차는 memory design의 복잡성 증가와 그 실제 효용성 사이의 불일치를 야기하며, 본 연구는 naive RAG를 기준으로 memory의 net value를 체계적으로 재평가할 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 personal-agent conversational memory를 시작으로 다양한 벤치마크와 model backbones에 걸쳐 대표적인 memory designs을 평가하고, naive RAG를 reference로 삼아 memory의 net value를 분석한다. 이를 위해 LongMemEval-s, PersonaMem-v2, MINT-Eval 세 가지 벤치마크와 Qwen3.5-4B, Qwen3.6-27B, GPT-5.6-luna(low) 세 가지 backbones를 사용했다. 평가 지표로는 Judge Accuracy와 함께 Token Cost, End-to-End Wall-Clock Time, LLM Calls, Memory Storage Size 등의 비용 지표를 활용했다. 특히, retrieval top-k를 시스템별로 조정하여 Retrieval Scope (RS)를 RAG와 유사하게 맞추는 공정한 비교 설정을 도입했다.
실험 결과, naive RAG가 강력한 baseline임을 입증했으며, 많은 memory system들이 다양한 설정에서 naive RAG보다 낮은 성능을 보이는 것으로 나타났다, 이는 해당 경우에 memory가 negative net value를 가짐을 시사한다 [Table 1]. 예를 들어, LongMemEval-s 벤치마크에서 RAG (2rd)는 Qwen3.6-27B backbone에서 81.4%의 Judge Accuracy를 달성했지만, 대다수 memory system은 이보다 낮은 수치를 기록했다 [Table 1]. PersonaMem-v2 벤치마크에서도 RAG (2rd)는 48.7%의 Accuracy를 보였으며, 여러 memory system이 이보다 낮은 성능을 보였다 [Table 1]. 개별 쿼리 수준에서 memory는 RAG가 놓치는 일부 쿼리를 해결하는 Memory Benefit을 보였지만, RAG가 이미 해결한 다른 쿼리에서는 정보 손실이나 접근성 저하로 인해 Memory Tax를 유발했다 [Figure 2, 3]. 이는 memory process가 raw history로부터 불가피하게 유발하는 double-edged deviations(양날의 칼과 같은 편차) 때문이라고 분석된다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 raw history로부터 직접 검색하는 naive RAG 대비 agent memory의 net value를 재조명한다. 대규모 평가를 통해 많은 memory system이 naive RAG보다 낮은 성능을 보여 negative net value를 가짐을 발견했으며, 이는 memory process가 정보의 조직화 및 접근 방식을 변경하면서 발생하는 Memory Benefit과 Memory Tax라는 이중적인 효과 때문임을 밝혀냈다. Memory Tax는 시스템 측면에서 정보의 Faithfulness (보존 충실도) 저하, Accessibility (접근 용이성) 저하, 그리고 Robustness (Backbone 변화에 대한 견고성) 감소로 인해 발생하며 [Table 2, Figure 4, 5, 6], 평가 측면에서는 Benchmark Headroom이 제한적일 때 Memory Tax가 더욱 두드러진다. 또한, 이러한 benefit-tax 관점은 experiential memory 및 world-model memory와 같은 광범위한 시나리오에도 일반화될 수 있음을 보여주었다 [Figure 8]. 이 연구는 memory의 독립적인 성능보다는 net value에 대한 관심 전환을 촉구하며, 보다 신뢰할 수 있는 memory design과 평가 방법을 제시하는 데 중요한 시사점을 제공한다.
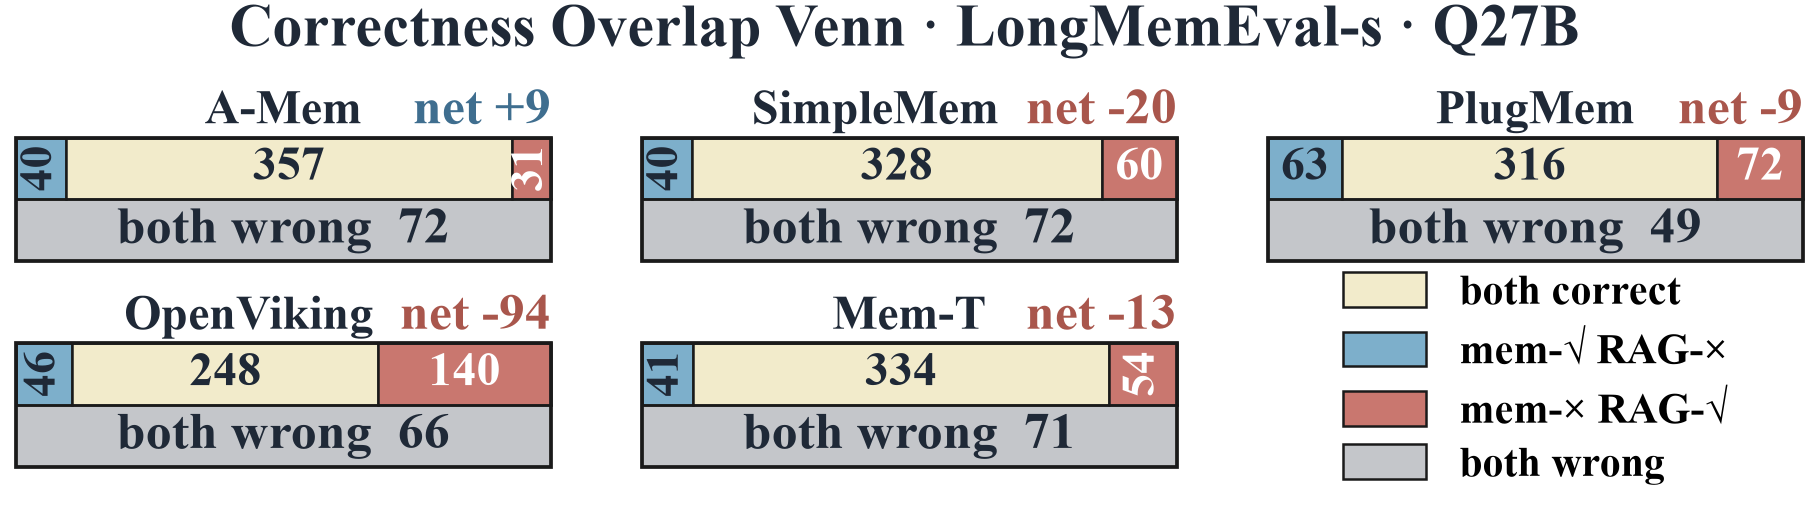
Figure 2 — 쿼리별 정답 비교 (Memory vs RAG)
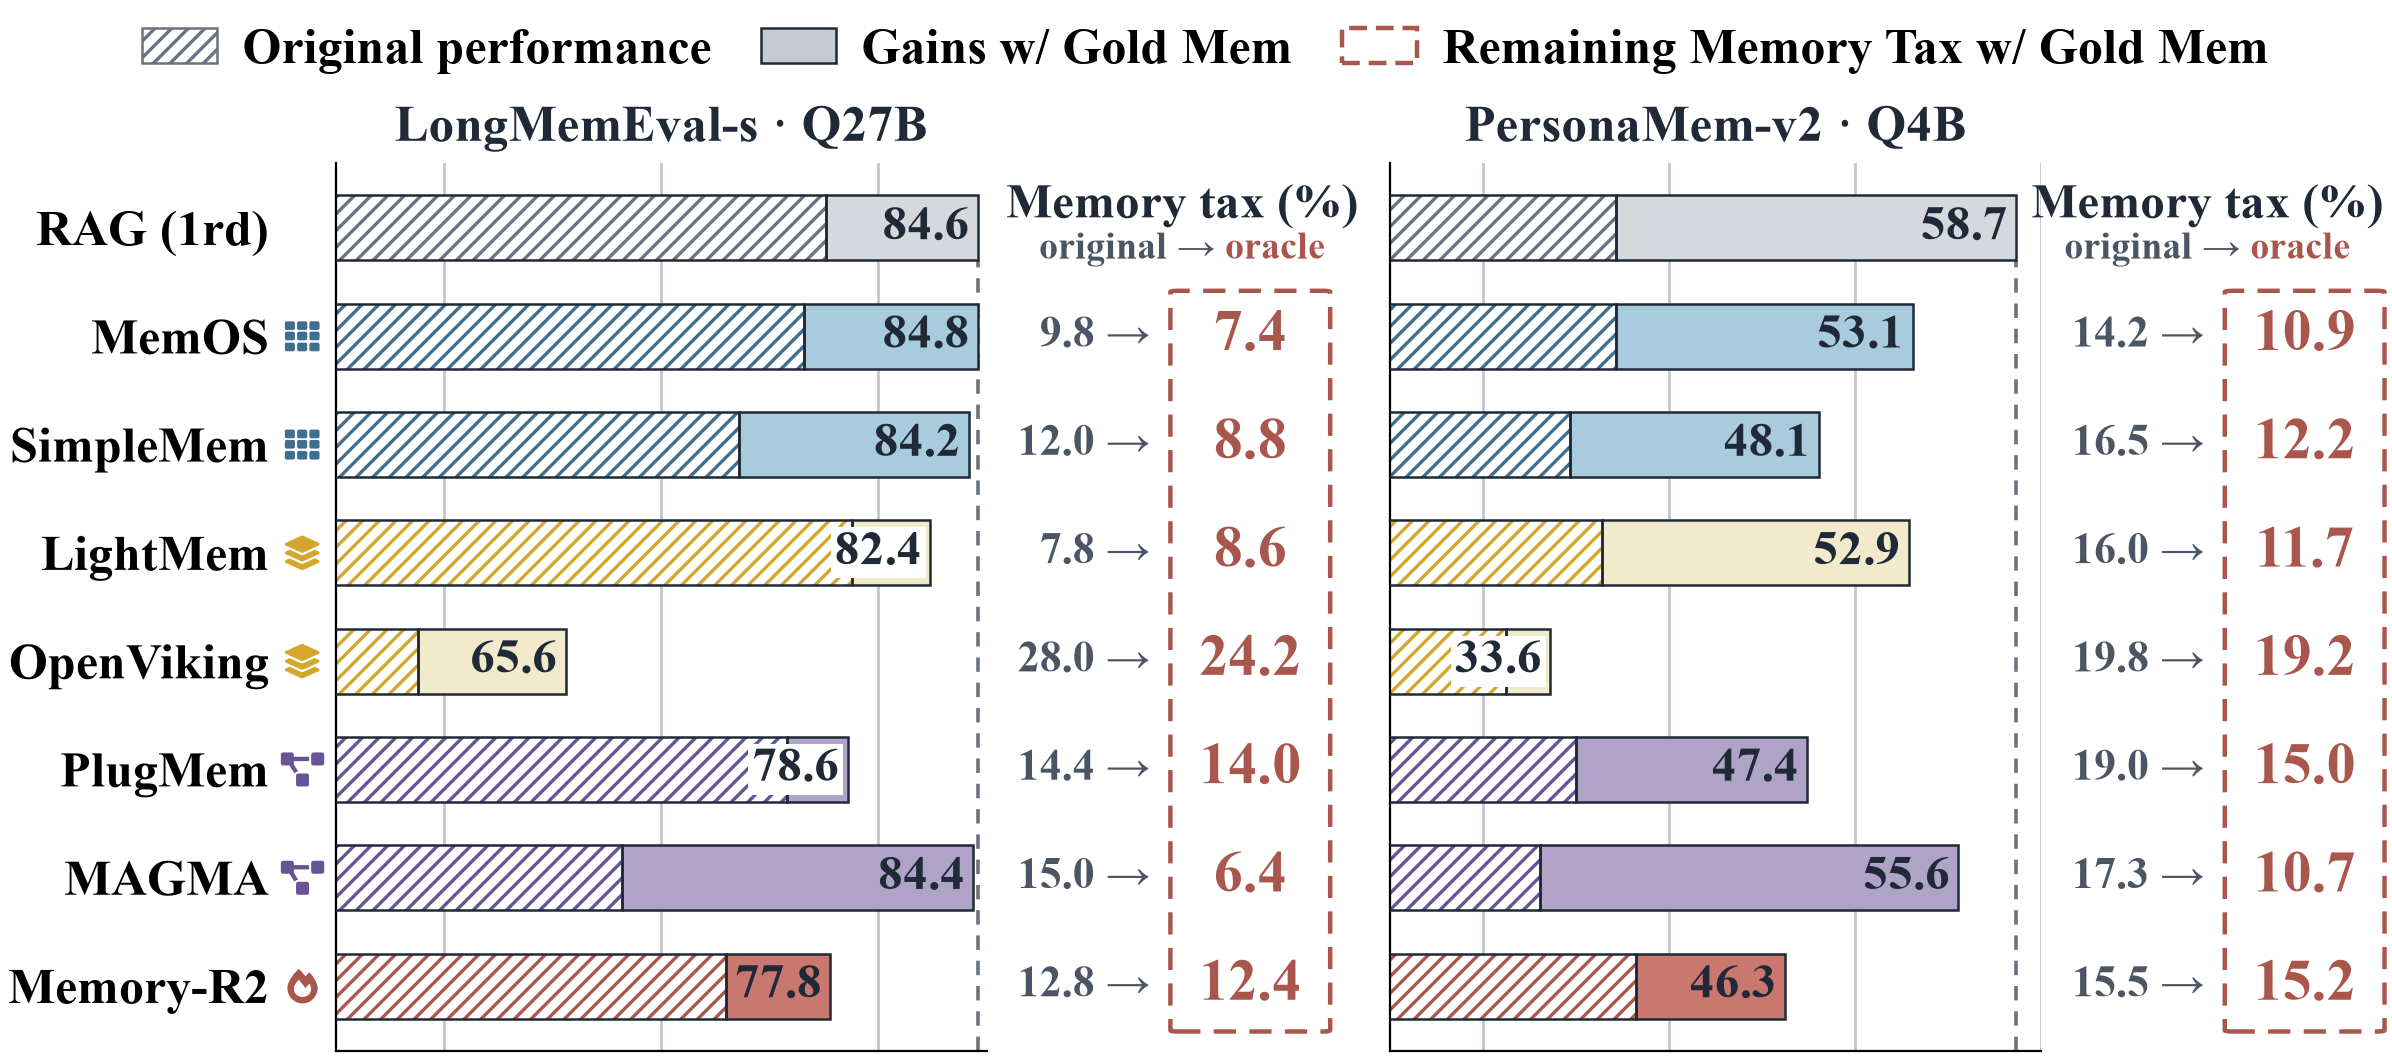
Figure 3 — 원본 성능 대 골드 메모리 유닛
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
- [논문리뷰] TAO: Tool-Aware Joint Scheduling for LLM-Based Agentic Serving
- [논문리뷰] Sensorimotor Alignment: A Platonic Proxy for Embodied Policy Success
- [논문리뷰] RealCLI: Toward a Unified Evaluation of Human-Agent Collaboration for CLI Agents
Review 의 다른글
- 이전글 [논문리뷰] MatAnyone-E: Sparse Memory Propagation for Efficient High-Resolution Video Matting
- 현재글 : [논문리뷰] Memory Tax: Dissecting the Net Value of Agent Memory
- 다음글 [논문리뷰] MoveBench: A Rubric-Based Benchmark for Evaluating Large Language Models in Sports and Health Coaching
댓글