[논문리뷰] MoveBench: A Rubric-Based Benchmark for Evaluating Large Language Models in Sports and Health Coaching
링크: 논문 PDF로 바로 열기
저자: Yitong Li, Jiang Bian, Jingling Wang, Pan Ding, Chengying Gu et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MoveBench: 스포츠 및 건강 코칭 분야에서 Large Language Models (LLMs)의 성능을 평가하기 위해 제안된 최초의 포괄적인 벤치마킹 프레임워크입니다.
- Rubric-Based Evaluation: 응답의 다차원적인 품질을 평가하기 위해 안전성, 과학적 타당성, 개인화, 논리적 일관성 등 세분화된 기준을 포함하는 구조화된 평가 방식입니다.
- Personal Workout Plan Generation (PG): LLM이 사용자의 제약 조건(예: 체력 수준, 부상 이력)을 고려하여 구조화되고 실행 가능한 훈련 프로그램을 생성하는 능력을 평가하는 핵심 Task category입니다.
- Personal Sport Data Analysis (DA): LLM이 실제 운동 데이터를 해석하고 생리학적으로 근거한 통찰력과 실행 가능한 권장 사항을 도출하는 능력을 평가하는 Task category입니다.
- Safety Redline Mechanism: LLM의 응답이 해롭거나 안전하지 않은 권장 사항을 포함할 경우, 해당 항목의 점수를 0으로 처리하여 심각한 안전 위반에 대한 명시적인 페널티를 부여하는 메커니즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Large Language Models (LLMs)를 스포츠 및 건강 코칭 분야에 적용하는 데 있어 domain-specific 평가 벤치마크의 부재로 인한 높은 위험성 문제를 해결하고자 합니다. 기존의 General-Purpose Benchmarks (예: MMLU, HELM)는 주로 광범위한 지식과 추론 능력을 평가하지만, 운동 안전성, 생리학적 적절성, 개인화 및 실행 가능한 코칭 품질과 같은 이 분야의 critical한 요구 사항을 포착하지 못합니다. 또한, Medical and Health-Related Benchmarks (예: MedQA, HealthBench) 역시 주로 진단 추론이나 사실적 정확성에 초점을 맞추어, 행동 지향적이고 개인화된 개입 전략을 제공하는 LLM의 능력을 평가하는 데 한계가 있습니다. 이러한 한계점들은 실제 피트니스 및 건강 애플리케이션에서 부정확하거나 안전하지 않은 권장 사항이 신체적 해를 초래할 수 있다는 심각한 우려를 낳습니다. 기존 벤치마크들은 실제 코칭 workflow와 일치하는 task formulation이 부족하고, 안전성 및 훈련 과학과 관련된 fine-grained domain-specific 평가 기준을 통합하지 못하며, open-ended 응답의 다차원적 품질을 포착하지 못하는 단점이 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 스포츠 및 건강 코칭 분야에서 LLM을 평가하기 위한 MoveBench라는 포괄적인 벤치마킹 프레임워크를 제안합니다. 이 벤치마크는 Multiple-Choice Questions (MCQs)와 실제 사용자 시나리오에 기반한 Open-Ended Question Answering (OpenQA)를 포함하는 이질적인 Task formats을 통합합니다. 특히 OpenQA 항목들은 안전성 준수, 과학적 타당성, 훈련 논리 등을 강조하는 구조화된 Rubric-Based Evaluation을 통해 평가됩니다. 평가 프레임워크는 Personal Workout Plan Generation (PG), Personal Sport Data Analysis (DA), Sport & Health Knowledge Question Answering (QA)의 세 가지 핵심 Task categories로 구성되며, 각 Task category는 고유한 다차원적 Rubric Dimensions를 가집니다. 또한, 잠재적으로 해롭거나 안전하지 않은 권장 사항에 대해 명시적으로 페널티를 부여하는 Safety Redline Mechanism이 구현되었습니다. Judge Models (Gemini 3.1 Pro, Claude 4.6 Sonnet, GPT-5.2)의 weighted aggregation을 통해 평가 신뢰도를 향상시켰으며, Automatic Question Generation Pipeline과 Question Quality Check Pipeline을 통해 벤치마크 데이터셋을 구축했습니다.
대규모 평가를 통해 15개 LLM의 성능을 분석한 결과, Claude 4.6 Opus가 0.943점으로 가장 높은 Overall Performance를 달성했으며, GPT-5.2 (0.929), GPT-5.5 (0.927), Qwen3-Max (0.926)가 그 뒤를 잇는 상위 그룹을 형성했습니다 [Figure 1]. 이는 선도적인 대규모 모델들이 제안된 평가 프레임워크에서 매우 경쟁력 있는 성능을 보임을 시사합니다. 특히, safety awareness, structured program design, personalization capability에서 상당한 성능 편차를 보였으며, 이는 지식과 행동(knowing and doing) 사이의 critical한 gap을 강조합니다. Question Type Performance Analysis 결과, 모든 모델이 Single-Select (SS) 질문에서 1.000의 정확도를 달성하여 ceiling effect를 보였습니다 [Figure 2]. 반면, Multi-Select (MS) 질문은 0.888에서 0.980 사이의 moderate variation을 보였고, Open-Ended (OQ) 질문은 0.812에서 0.917까지 가장 넓은 점수 범위를 나타냈습니다 [Figure 2]. 이는 구조화된 질문에서의 우수한 성능이 반드시 high-quality open-ended coaching responses로 이어지지 않음을 시사합니다. Scoring Reliability 측면에서, 전문가 채점의 adjudicated baseline과의 일치도는 80.60%에서 86.00%였고, Judge Models의 일치도는 62.33%에서 76.33%로 나타나, LLM 기반 평가자와 인간 전문가 간의 간극이 여전히 존재함을 보여줍니다.
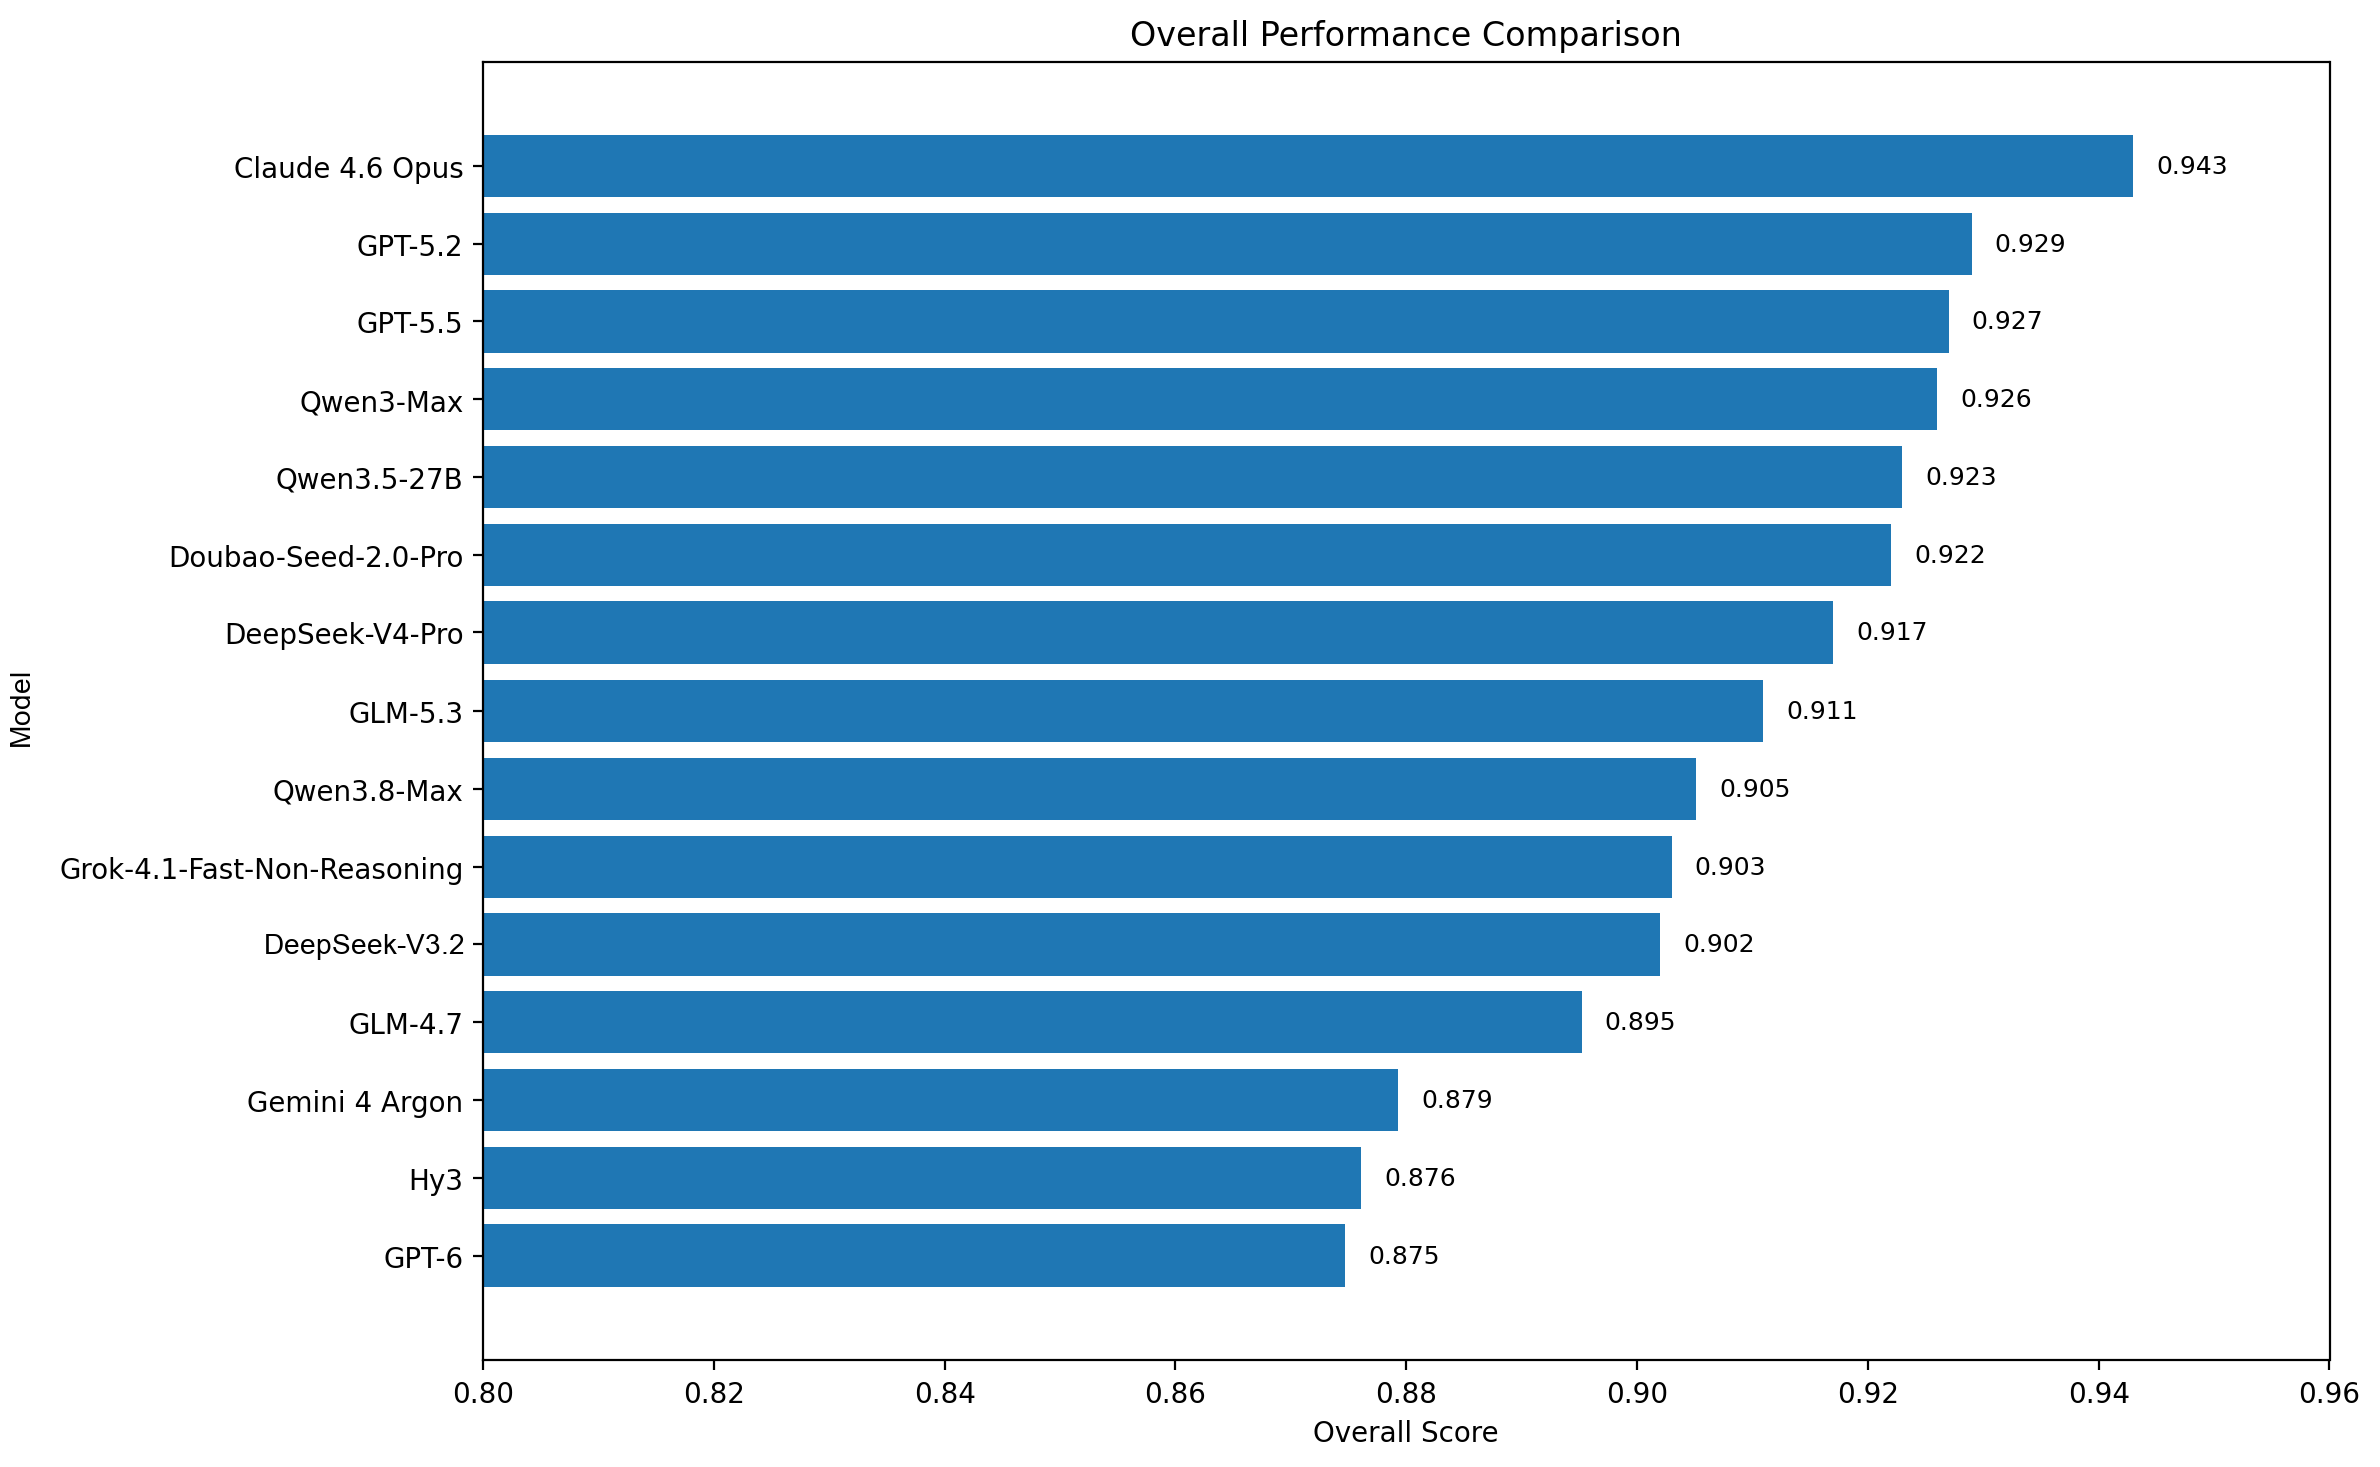
Figure 1 — 15개 모델의 전체 성능
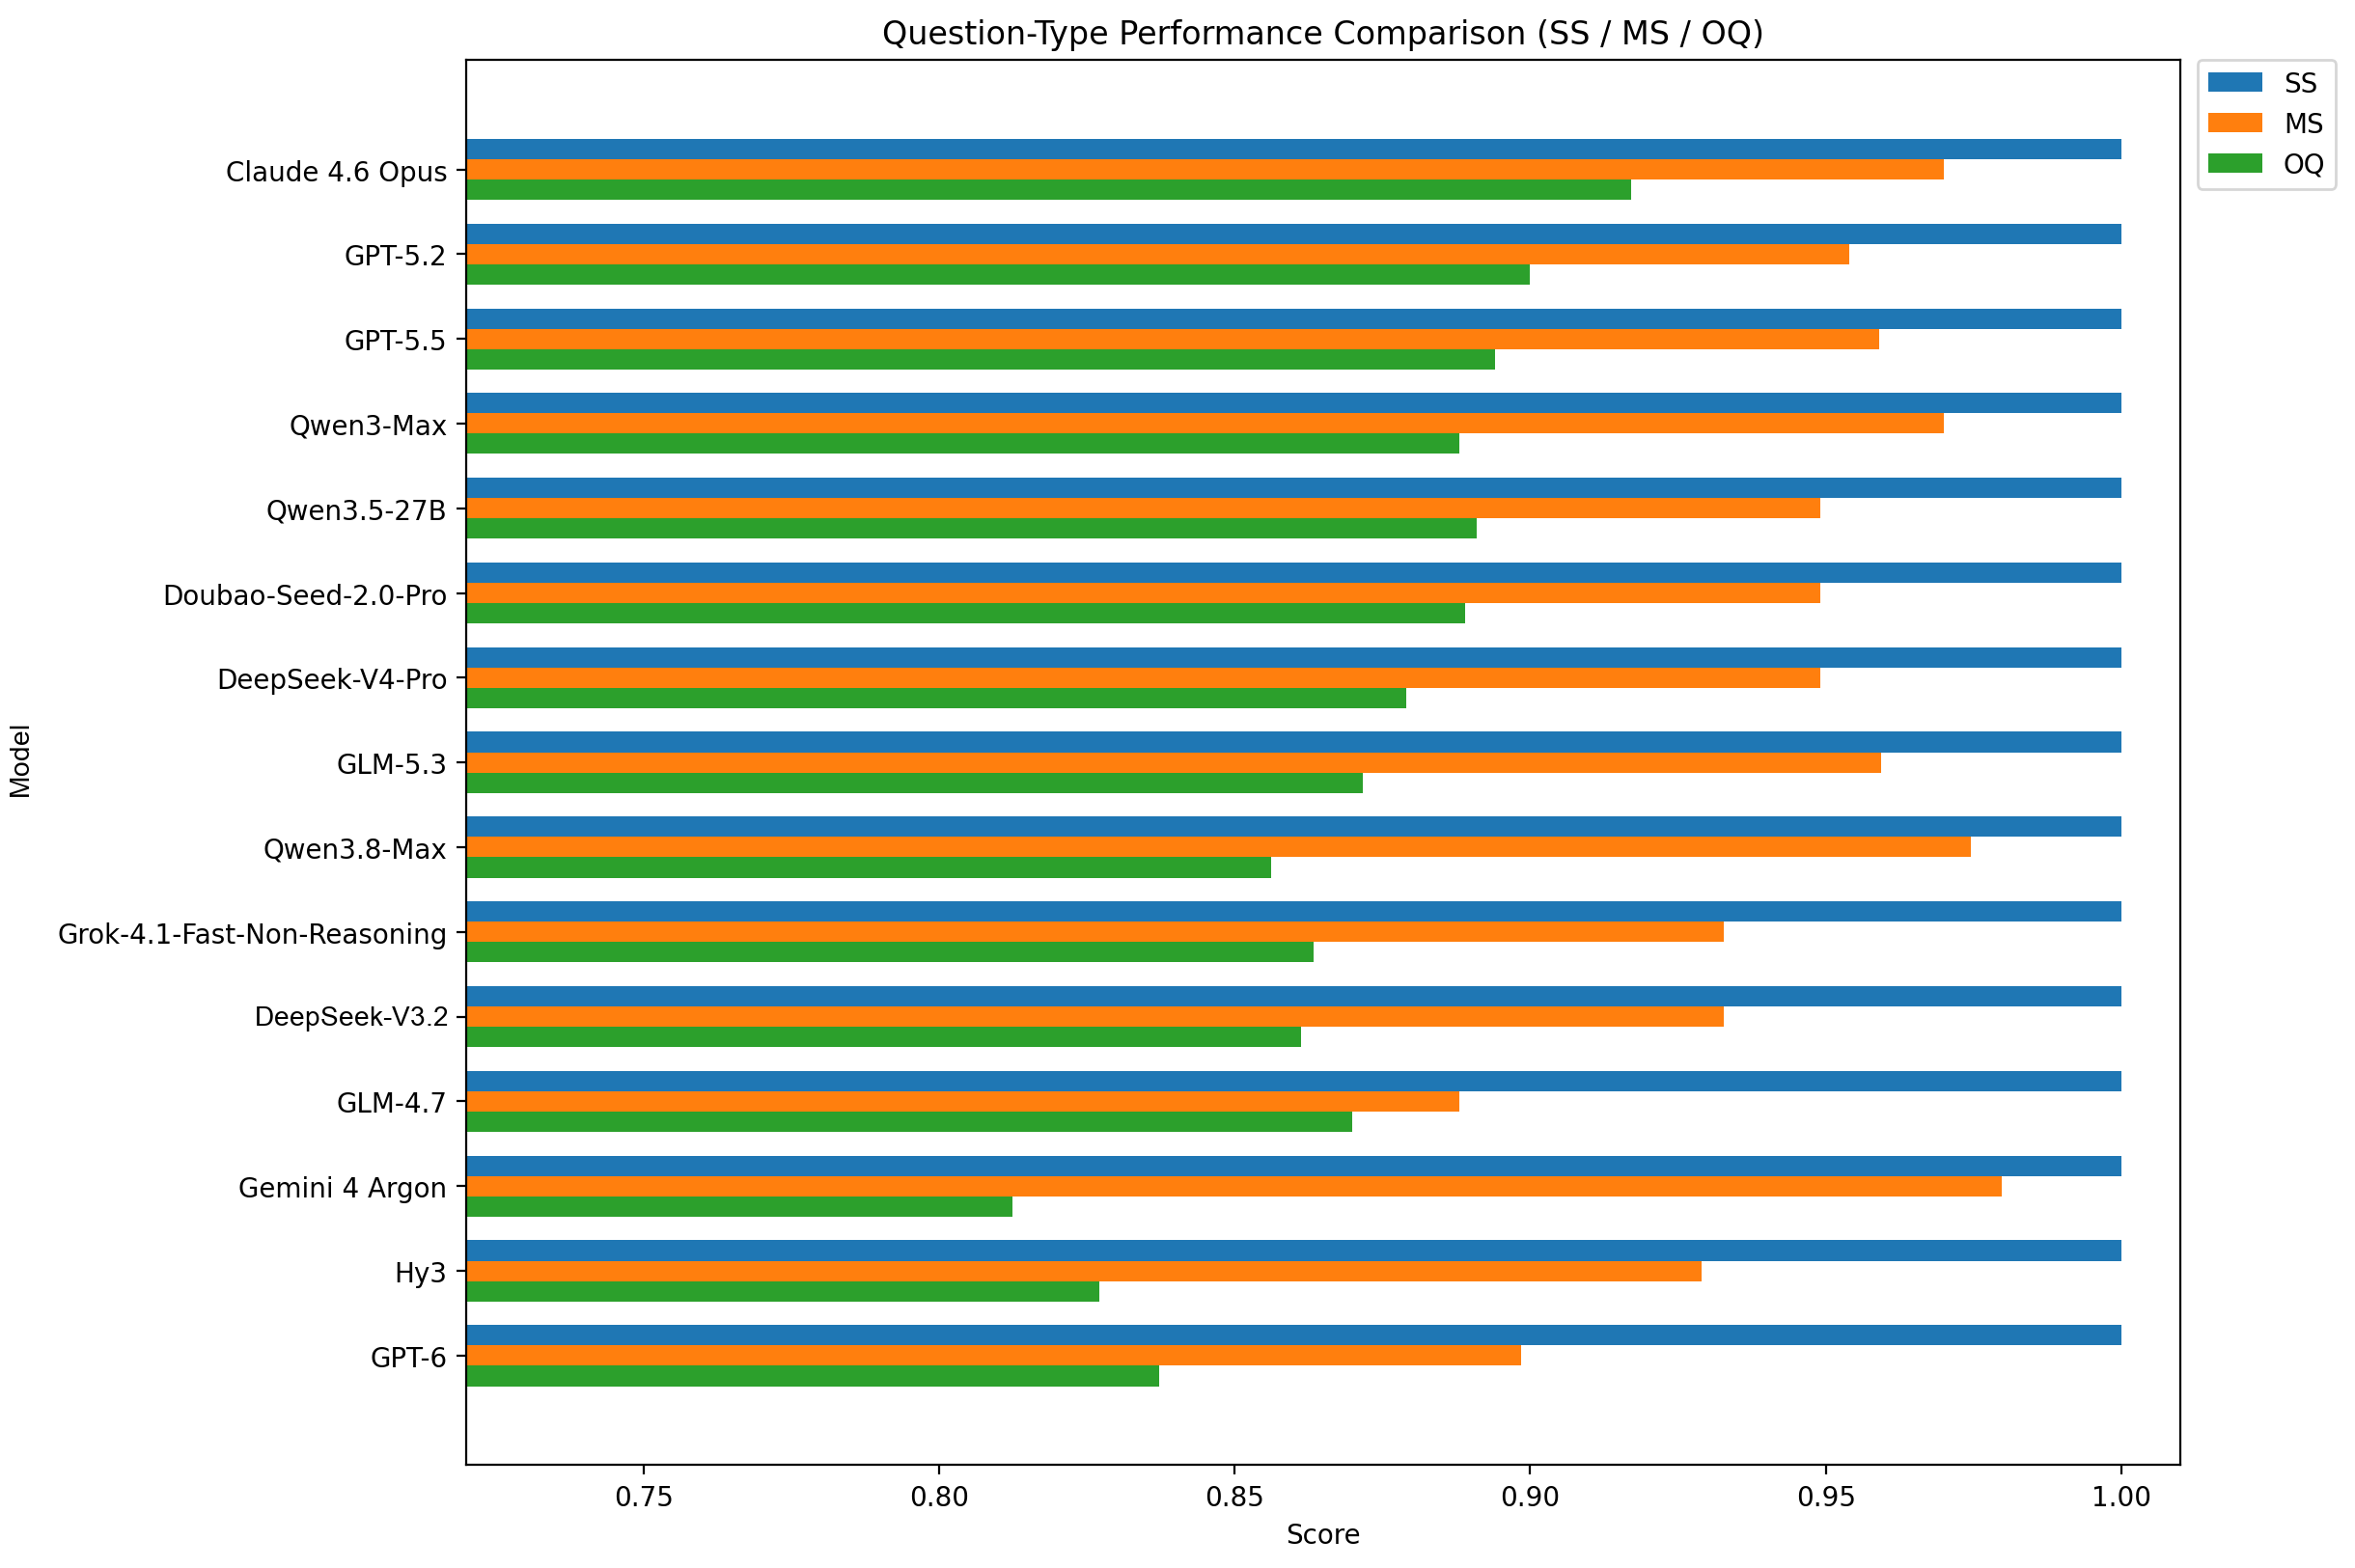
Figure 2 — 질문 형식별 모델 성능
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Personal Workout Plan Generation (PG), Personal Sport Data Analysis (DA), Sport & Health Knowledge Question Answering (QA) 등 세 가지 핵심 영역에 걸쳐 809개의 질문과 5,012개의 Rubric-Level Criteria를 포함하는 MoveBench를 제시합니다. 이 벤치마크는 exact-match MCQ scoring과 three-judge weighted OQ assessment, 그리고 item-level safety override를 결합한 평가 프로토콜을 사용하여, LLM의 스포츠 및 건강 코칭 역량을 다각도로 측정합니다. 평가 결과, Claude 4.6 Opus가 가장 높은 Overall Performance를 기록했으며, 모델 간 성능 차이가 structured program design 및 contextually appropriate coaching과 같은 복잡한 Task에서 특히 두드러지게 나타났습니다. MoveBench는 real-world applicability, safety, decision-making capability에 중점을 두어, 기존 지식 기반 평가의 한계를 넘어 intervention quality 및 safety-critical decision-making으로 평가 패러다임을 전환하는 데 기여합니다. 이는 sports and health LLM applications에 대한 foundational evaluation standard를 수립하고, 안전하고 신뢰할 수 있으며 context-aware AI-driven coaching systems 발전을 위한 reproducible framework를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] BenchPreS: A Benchmark for Context-Aware Personalized Preference Selectivity of Persistent-Memory LLMs
- [논문리뷰] Ask Before You Optimize: Dynamic Pre-Formulation Clarification for Interactive Optimization
- [논문리뷰] RealSWE: A Compositional Evaluation of Coding Agents under Realistic User Requests
- [논문리뷰] Can LLM Agents Stick to the Script? A Benchmark for Long-Horizon Consistency in Interactive Narratives
- [논문리뷰] SPIEval: Evaluating Large Language Models as Mobile Assistants over Scattered Personal Information
Review 의 다른글
- 이전글 [논문리뷰] Memory Tax: Dissecting the Net Value of Agent Memory
- 현재글 : [논문리뷰] MoveBench: A Rubric-Based Benchmark for Evaluating Large Language Models in Sports and Health Coaching
- 다음글 [논문리뷰] Multiscale Policy Optimization for Long-Horizon LLM Agents
댓글