[논문리뷰] SciGame: Let Agents Play the Scientific Discovery Games in the Real and Counterfactual World
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yusheng Zhao, Bowei He, Xue Liu, Mingxiao Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Scientific Card: 과학적 법칙을 체계적으로 구조화한 데이터셋으로, 관계식(Relation), 변수, 도메인, 적용 조건 등을 포함함.
- Counterfactual Environment: 기존(Original) 과학 법칙에 체계적인 구조적 변형(Mutation)을 가하여, 에이전트가 사전 지식(Prior)이 아닌 관측된 데이터에 의존하는지 평가하는 환경.
- Adaptive Protocol: 에이전트가 실험을 스스로 제안하고 데이터를 수집하며 hypothesis를 수정하는 주도적 탐색 방식.
- ESR (Episode Success Rate): 에이전트가 정해진 과제를 성공적으로 완료했는지 측정하는 지표로, 수치 오차를 기반으로 한 Weak 기준과 정확한 기호식(Symbolic form) 복구를 요구하는 Strict 기준으로 나뉨.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 과학적 발견 벤치마크들이 법칙 추론과 프로그래밍을 혼용하거나, 모델의 사전 학습 지식(Pretrained priors)과 실제 경험적 증거를 명확히 구분하지 못하는 문제를 해결하고자 한다. 특히 기존 연구들은 고정된 환경에서의 데이터 피팅에 치중하여 unseen input에 대한 일반화 능력이나, 물리적 법칙이 변하는 반사실적(Counterfactual) 상황에서의 유연성을 충분히 테스트하지 못한다. 저자들은 이러한 한계를 극복하기 위해 과학적 문헌을 구조화된 카드로 변환하고, 동일한 인터페이스에서 Original과 Counterfactual 환경을 비교하는 제어된 벤치마크인 SciGame을 제안한다 [Figure 1].
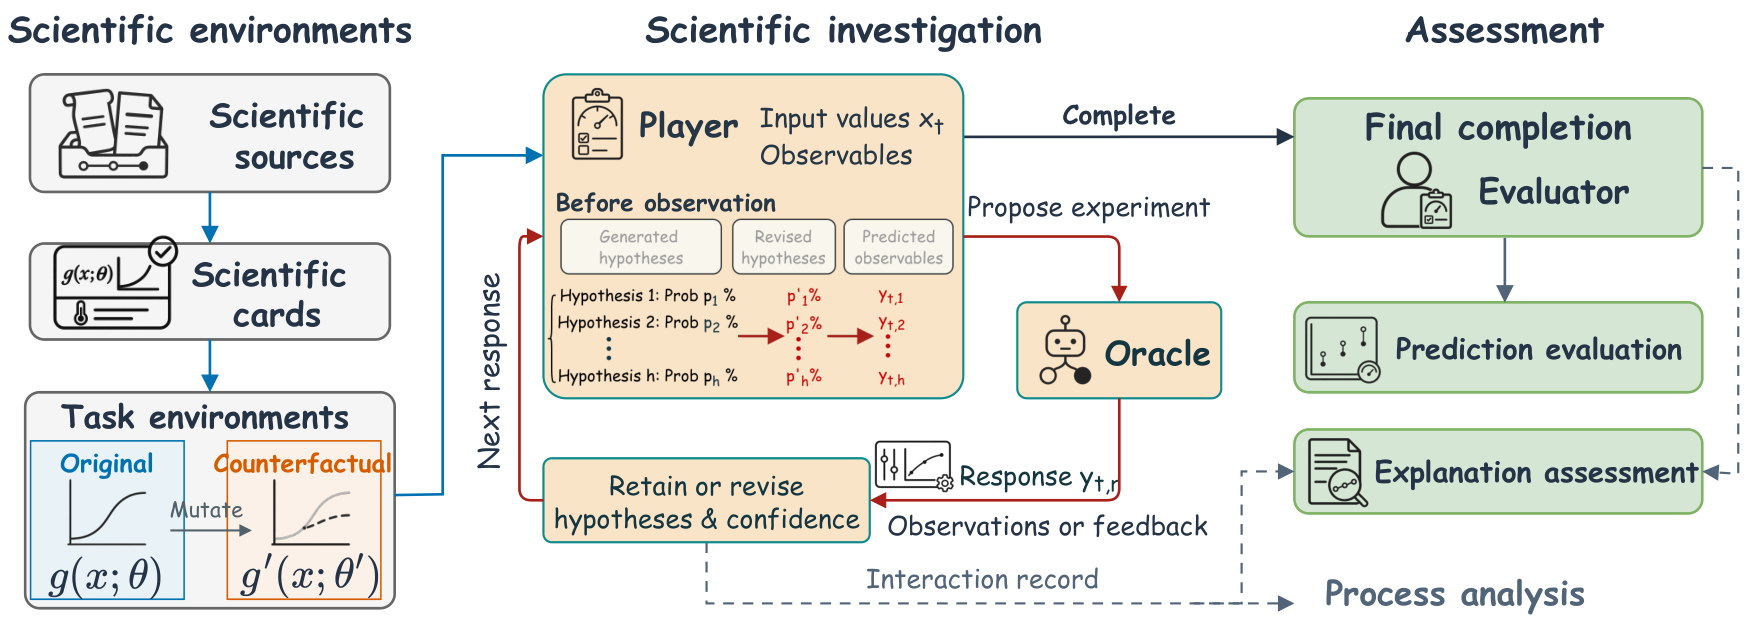
Figure 1 — SciGame 전체 파이프라인
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 과학적 지식을 Historical collection(고전 법칙)과 Temporal collection(최신 논문 기반)으로 구성하고, 세 가지 프로토콜(Prior-only, Fixed, Adaptive) 하에서 에이전트의 능력을 평가한다 [Figure 1]. 방법론의 핵심은 Original 환경과 물리적 차원은 유지하되 법칙이 변형된 Counterfactual 환경을 1:1로 매칭하여, 에이전트가 고정관념을 버리고 데이터를 통해 새로운 법칙을 유도할 수 있는지 엄격히 테스트하는 것이다 [Figure 2, Figure 3].
실험 결과, 강력한 모델일수록 Adaptive 환경에서 성능 향상을 보이나, 여전히 복잡한 법칙 도출 시 기호식 복구(Symbolic recovery)에서 병목 현상이 발생함을 확인했다. 주요 결과는 다음과 같다:
- 강력한 사전 지식은 Counterfactual 환경에서 오히려 성능을 저해하는 요인으로 작용한다.
- Adaptive 실험은 가장 성능이 좋은 모델들에게는 이점을 주지만, 자원 예산이 제한된 경우 약한 모델들에게는 성능 저하를 초래할 수 있다 [Table 2].
- 정성적으로 우수한 설명을 제시하더라도 수치적 예측 실패(Quantitative failure)가 동반될 수 있어, 설명력과 예측 성능을 분리해서 평가해야 한다 [Figure 4, Figure 6].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 과학적 발견의 전 과정을 체계적으로 평가하는 SciGame을 통해 LLM 에이전트의 과학적 추론 한계를 명확히 규명했다. 연구 결과, 현재의 LLM 에이전트들은 Active한 환경 탐색이 가능하지만, 익숙하지 않은 설정 하에서 정확한 물리 법칙을 귀납적으로 유도하는 데에는 여전히 상당한 어려움을 겪고 있다. 이 연구는 향후 에이전트 기반 과학 연구 분야에서 모델의 일반화 성능과 데이터 기반 학습의 진위 여부를 판별하는 표준적인 평가 프레임워크로 활용될 것으로 기대된다.
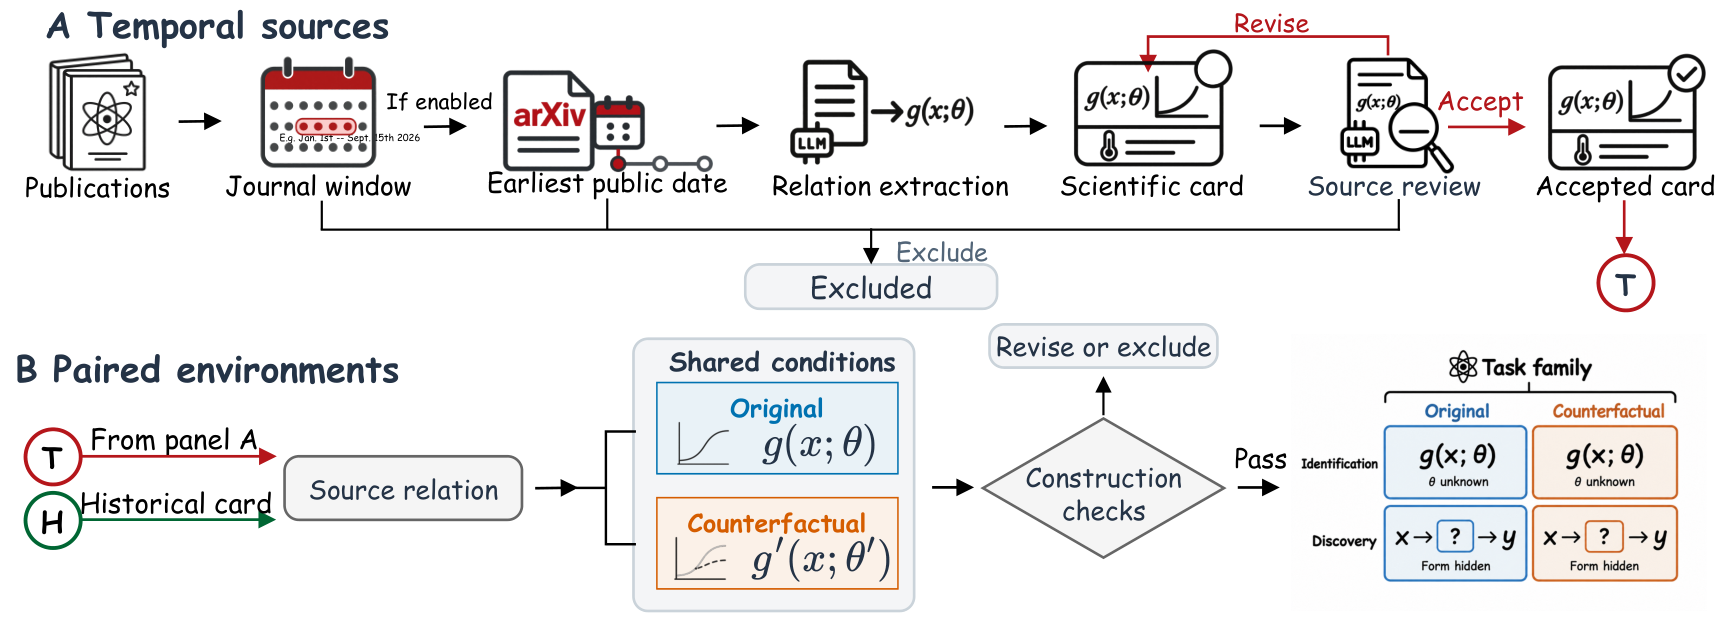
Figure 2 — 데이터 큐레이션 파이프라인
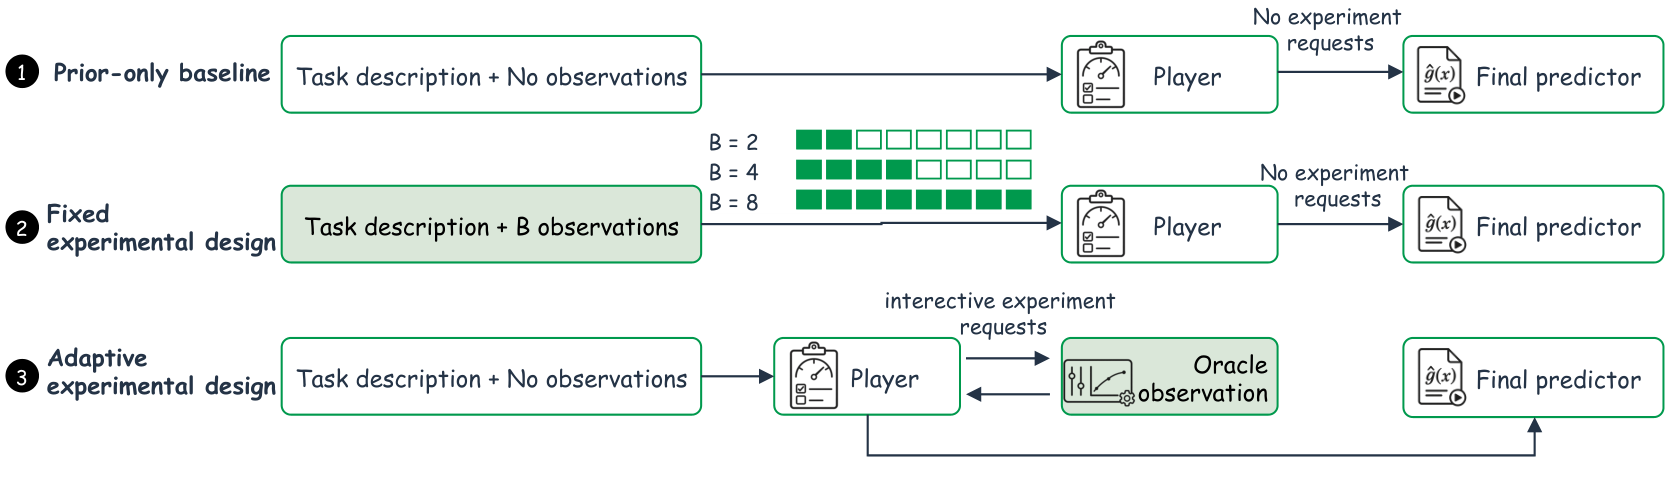
Figure 3 — 관측 프로토콜 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OmniScientist: An Omni-Modal Omni-Discipline AI Scientist
- [논문리뷰] OmniScientist: An Omni-Modal Omni-Discipline AI Scientist
- [논문리뷰] CausaLab: A Scalable Environment for Interactive Causal Discovery Toward AI Scientists
- [논문리뷰] AIRS-Bench: a Suite of Tasks for Frontier AI Research Science Agents
- [논문리뷰] IdeaTaste: Do LLMs Share the Research Taste of Human Researchers?
Review 의 다른글
- 이전글 [논문리뷰] SOMA: A Benchmark for Fine-Grained Egocentric Behavior and Body-Motion Understanding
- 현재글 : [논문리뷰] SciGame: Let Agents Play the Scientific Discovery Games in the Real and Counterfactual World
- 다음글 [논문리뷰] SketchDirector: Complex Scene Sketching via Agentic Layout Reasoning and Detail Refinement
댓글