[논문리뷰] WeFair: Fidelity-Aware Alignment from Human Feedback for Personalized Query Rewriting in Short-Video Search
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yingtao Ren, Aolin Li, Cheng Cheng, Huiyun Hu, Huasheng Liang, Baoxing Xie, Jun Yuan, Haijun Wu, Yiwei Fu, Chenxing Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Personalized Query Rewriting: 사용자의 이전 검색 이력이나 콘텐츠 소비 패턴 등 컨텍스트를 활용하여 모호한 질의를 명확한 의도로 재작성하는 기술.
- Intent Drift: 재작성된 질의가 원래의 검색 의도에서 벗어나, 소비 유도적인 콘텐츠는 포함할지언정 사용자의 즉각적인 정보 욕구와는 괴리되는 현상.
- DPO (Direct Preference Optimization): 보상 모델을 별도로 학습하지 않고, 선택(Chosen) 및 거부(Rejected)된 응답 쌍을 통해 모델의 선호도를 직접 최적화하는 방법론.
- GRPO (Group Relative Policy Optimization): 샘플링된 그룹 내에서 상대적인 보상을 계산하여 정책을 업데이트하는 강화학습 기법으로, 본 논문에서는 명확한 타겟 데이터에 대한 정확도 강화에 활용됨.
- Fidelity-Aware Alignment: 인간 피드백의 질(Fidelity)을 고려하여 학습 단계별로 적절한 수준의 지도 방식을 매칭하는 정렬 프레임워크.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Short-video search 환경에서 사용자의 모호한 질의를 개인화된 의도에 맞게 재작성하면서, 동시에 Intent Drift를 방지하는 최적의 모델 학습 방법을 탐구한다. 기존의 LLM 기반 접근법들은 소비 행동 데이터를 사용하여 성능을 향상시키려 했으나, 이는 실제 사용자의 즉각적인 정보 욕구보다 참여도가 높은 콘텐츠를 우선시하는 경향이 있어 의도 왜곡을 유발한다 [Figure 1]. 따라서 저자들은 신뢰성 있는 데이터의 계층적 피드백을 통해 모델의 정확성을 높이고 엄격한 Latency 제약을 만족시키는 컴팩트한 모델의 필요성을 제기한다.
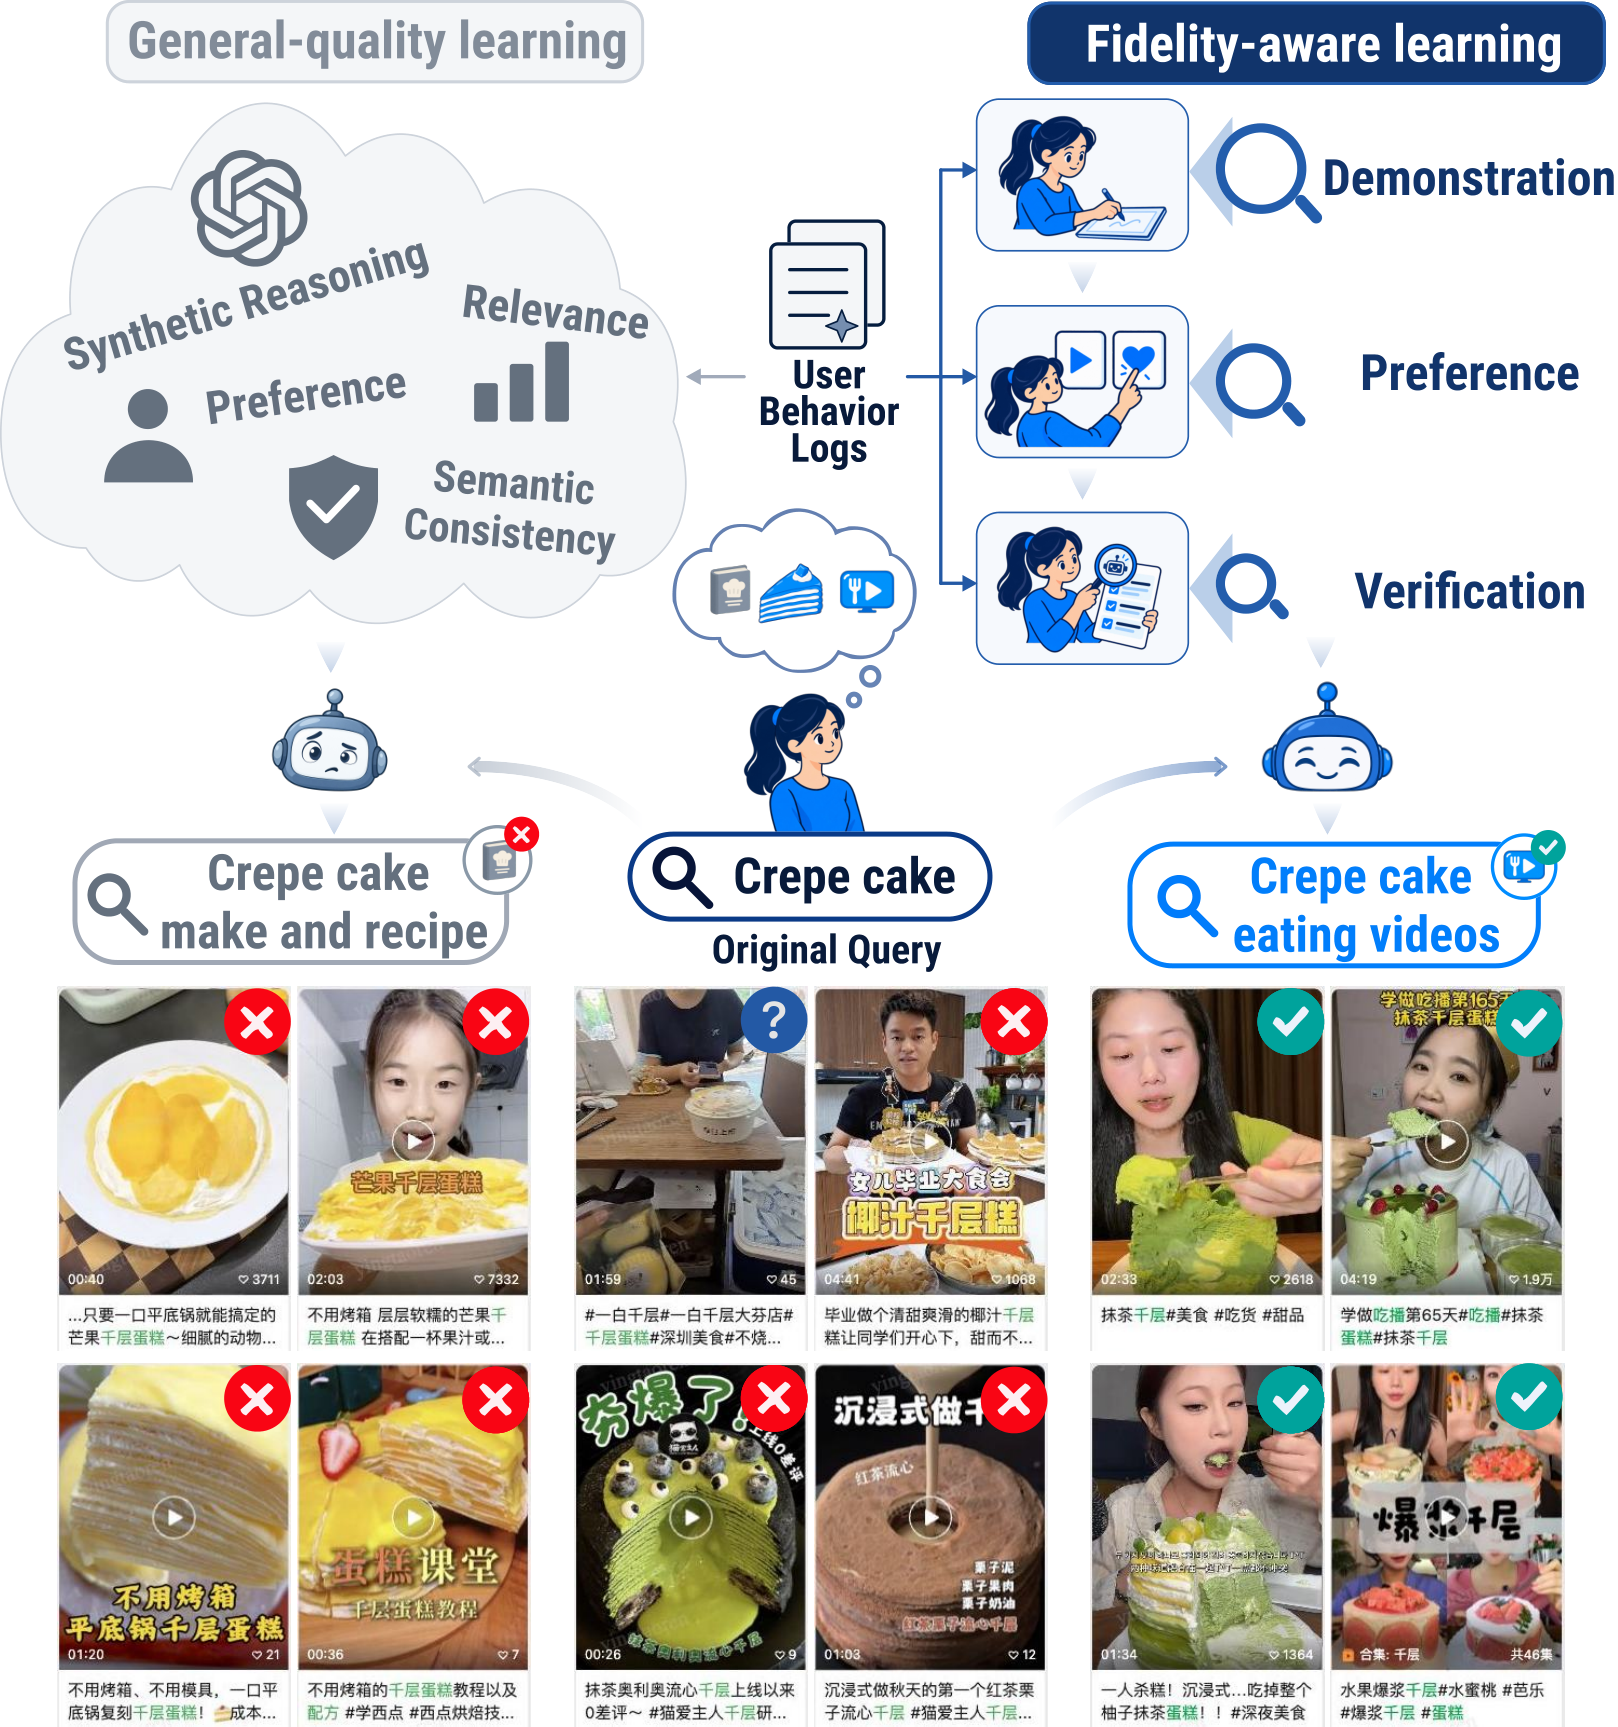
Figure 1 — Short-video 검색에서의 의도 왜곡 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 데이터의 신뢰도에 따른 단계별 학습 방식인 WeFair를 제안한다 [Figure 2]. 첫째, Curriculum SFT 단계에서는 대규모 context-to-query 데이터부터 실제 human reformulation에 이르기까지 점진적으로 학습 범위를 확장하여 기본적인 재작성 역량을 확보한다. 둘째, DPO 단계에서는 후속 소비 행동 피드백을 통해 선호도 학습을 진행한다. 마지막으로, GRPO를 활용한 엄격한 타겟 검증 단계를 통해 실제 인간의 재작성 및 유지(Preservation) 타겟과의 일치도를 극대화하여 Intent Drift를 효과적으로 제어한다 [Table 1]. 실험 결과, WeFair-2B 모델은 기존의 강한 Baseline 대비 Consistent Recall에서 뛰어난 성능을 보였으며, 10일간의 온라인 A/B 테스트에서 Click-through rate 2.951%, 비디오 시청률 2.593% 상승 및 재작성률 2.350% 감소라는 성과를 거두었다.
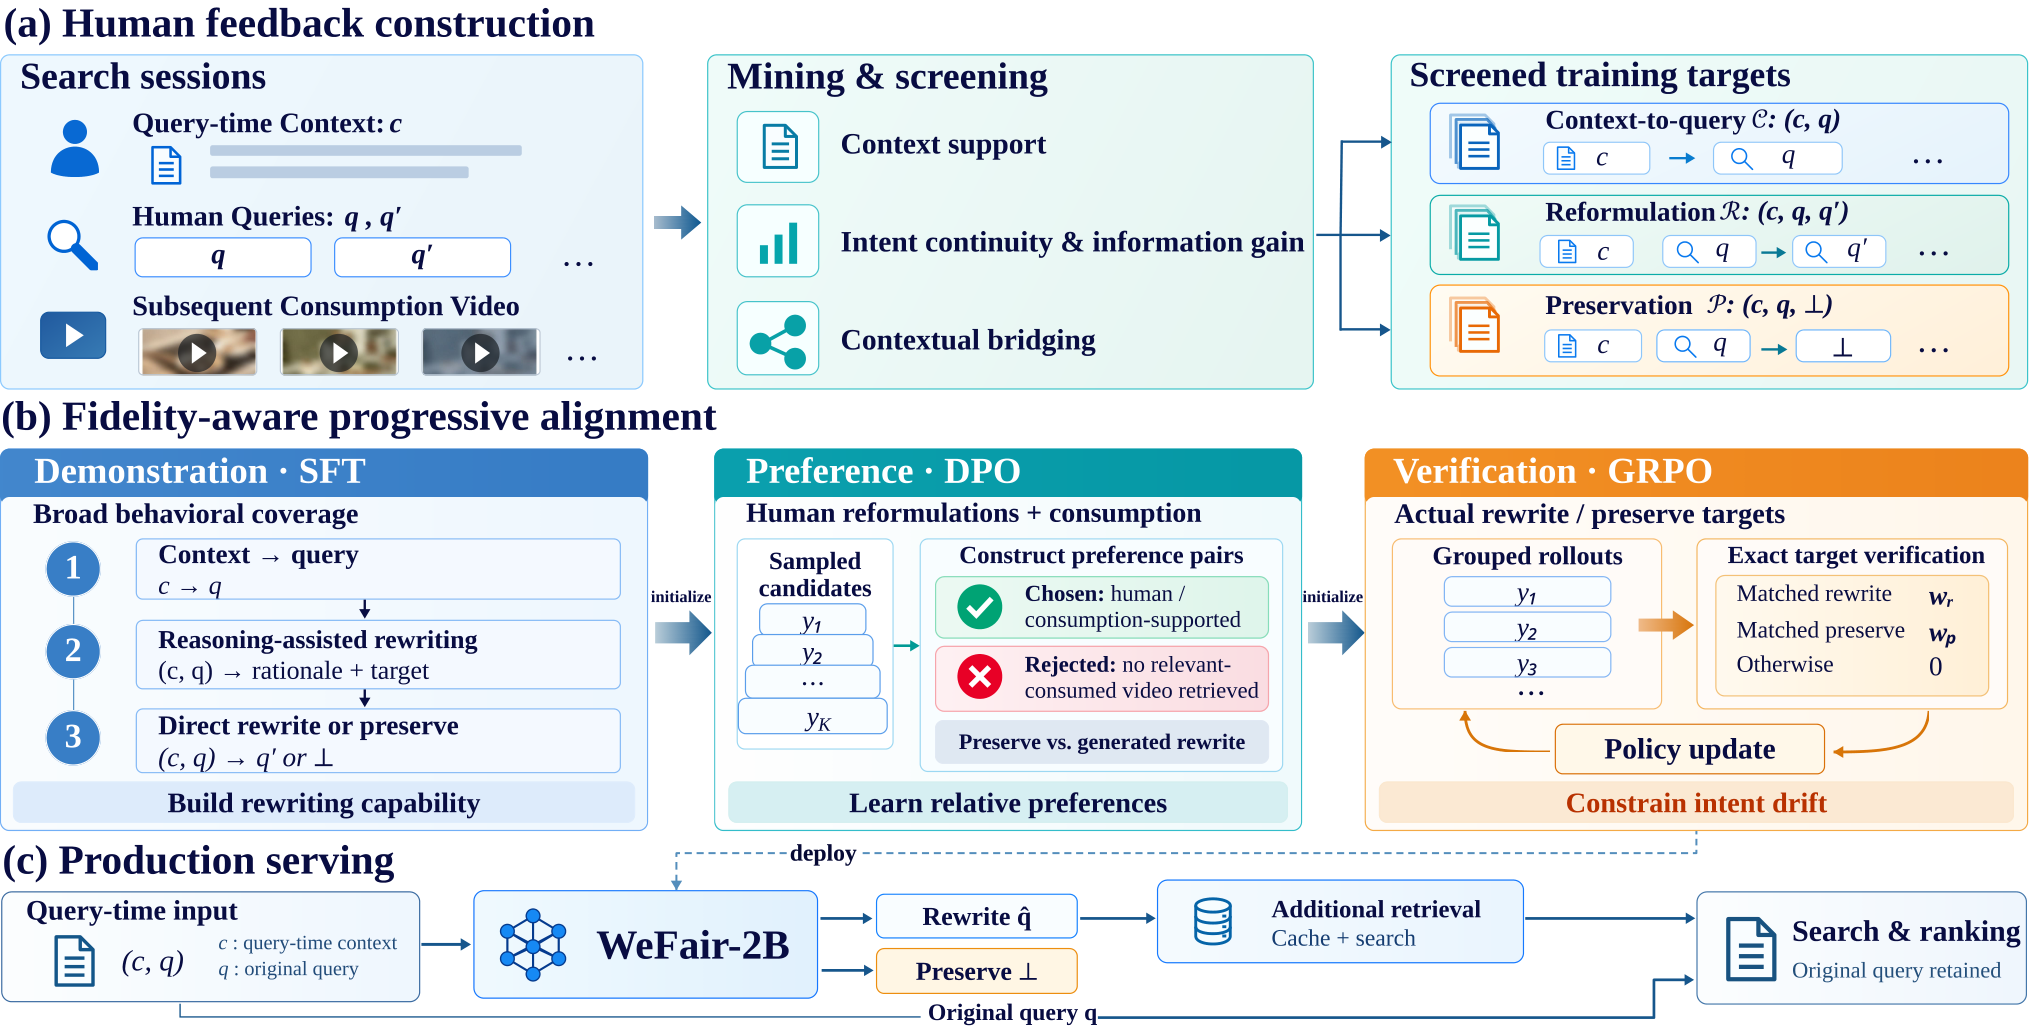
Figure 2 — WeFair 학습 및 추론 프레임워크
4. Conclusion & Impact (결론 및 시사점)
본 논문은 학습 데이터의 Fidelity를 재작성 모델의 단계별 요구사항과 매칭하는 WeFair 프레임워크의 유효성을 성공적으로 입증하였다. 특히, 엄격한 타겟 검증을 기반으로 한 학습 순서가 기존의 소비 중심 피드백보다 실제 의도 보존에 훨씬 효과적임을 확인하였다. 이 연구는 대규모 검색 시스템에서 컴팩트한 LLM을 배포할 때 고품질 데이터의 정교한 활용이 모델의 효율성과 정확성을 어떻게 극대화할 수 있는지에 대한 중요한 설계 원칙을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] On-Policy Self-Distillation with Teacher Evolution
- [논문리뷰] NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
- [논문리뷰] CUA-Master: Scaling Computer-use Agents through Open-World Recursive Improvements
- [논문리뷰] When Requirements Interact: Scaling Long-Horizon Coding via Interdependent Specifications
- [논문리뷰] Think Twice: The Metis-1.6 Technical Report
Review 의 다른글
- 이전글 [논문리뷰] VoxLock: Target-Speaker Extraction for Voice Agents Without an Enrollment Step
- 현재글 : [논문리뷰] WeFair: Fidelity-Aware Alignment from Human Feedback for Personalized Query Rewriting in Short-Video Search
- 다음글 [논문리뷰] When Requirements Interact: Scaling Long-Horizon Coding via Interdependent Specifications
댓글