[논문리뷰] On-Policy Self-Distillation with Teacher Evolution
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shufan Shen, Zhongni Hou, Chao Bi, Yufei Zhang, Guojun Yin, Shuhui Wang
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- On-Policy Self-Distillation (OPSD): 학생 모델(Student)이 스스로 생성한 privileged context를 활용하여 self-teacher로부터 토큰 단위(token-level)의 지도를 받아 학습하는 방식.
- Teacher-Evolution Self-Distillation (TESD): self-teacher의 능력을 능동적으로 개선하고, 학생 모델에게 신뢰할 수 있는 지도만을 선별적으로 제공하는 본 논문의 핵심 프레임워크.
- Privileged Context: 입력 질문에 대한 정답이나 추가 정보를 포함하여 self-teacher가 학생 모델을 가이드하도록 돕는 보조 정보.
- Teacher-Oriented Optimization: self-teacher가 환경으로부터 보상을 획득하여 스스로의 teaching 능력을 강화하는 최적화 기법.
- Adaptive Student-Oriented Optimization: self-teacher가 제공하는 가이드의 신뢰도를 보상 기반으로 추정하여, 신뢰도가 낮은 가이드를 제공하는 샘플에 대해 학생 모델의 gradient 업데이트를 억제(down-weighting)하는 기법.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존 OPSD 방식이 학습 과정에서 성능 개선이 정체되는 문제를 해결하고자 한다. 기존 연구들은 self-teacher가 항상 올바른 가이드를 제공한다는 비현실적인 가정에 의존하며, 학습이 진행됨에 따라 self-teacher의 능력이 개선되지 않거나 오히려 저하되는 한계가 있다 [Figure 1]. 결과적으로, 학생 모델은 부정확하거나 신뢰할 수 없는 지도 정보를 강제로 학습하게 되어 전반적인 성능 향상을 저해하게 된다. 따라서, self-teacher의 능력을 지속적으로 향상시키고 지도 정보의 품질을 관리하는 새로운 접근 방식이 필요하다.
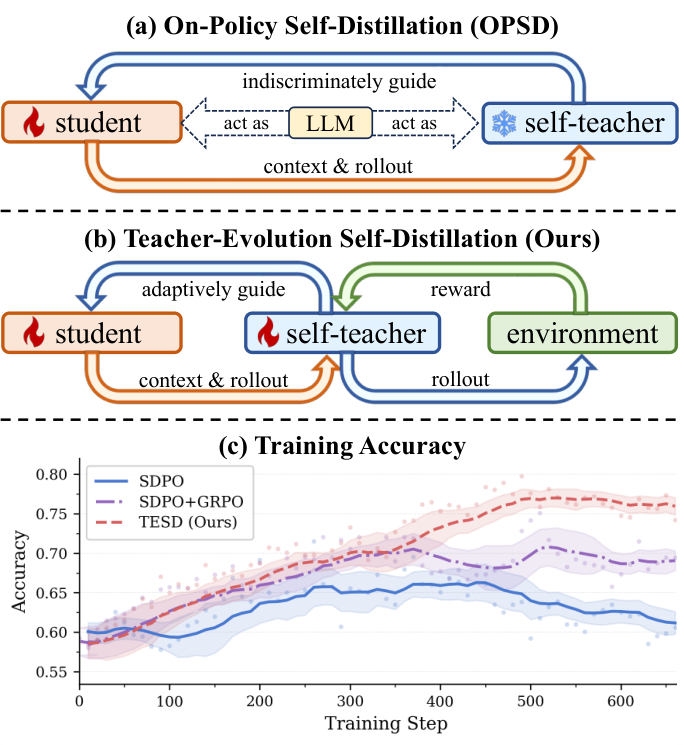
Figure 1 — TESD 프레임워크 개념도
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 TESD 프레임워크를 통해 self-teacher의 능력을 지속적으로 진화시키고 학생 모델의 학습 효율을 최적화한다. TESD는 self-teacher가 환경과 직접 상호작용하여 task correctness와 context independence를 포함한 보상을 얻게 하며, 이를 바탕으로 self-teacher를 최적화하는 Teacher-Oriented Optimization을 수행한다 [Figure 3]. 동시에, 해당 보상을 활용하여 가이드의 신뢰도를 평가하고, 신뢰도가 낮은 샘플에 대해서는 학생 모델의 distillation loss에 Adaptive Student-Oriented Optimization을 적용해 가중치를 조절한다. 실험 결과, Qwen3-8B 및 Olmo3-7B 모델을 사용한 다양한 벤치마크 테스트에서 TESD는 기존 SDPO 및 GRPO 기법 대비 일관된 성능 우위를 보였다 [Table 1, Table 2]. 특히, SciKnowEval 데이터셋에서 TESD는 경쟁 기법들보다 우수한 평균 정확도를 기록하였으며, catastrophic forgetting 문제 또한 효과적으로 완화하는 것으로 나타났다 [Table 3].
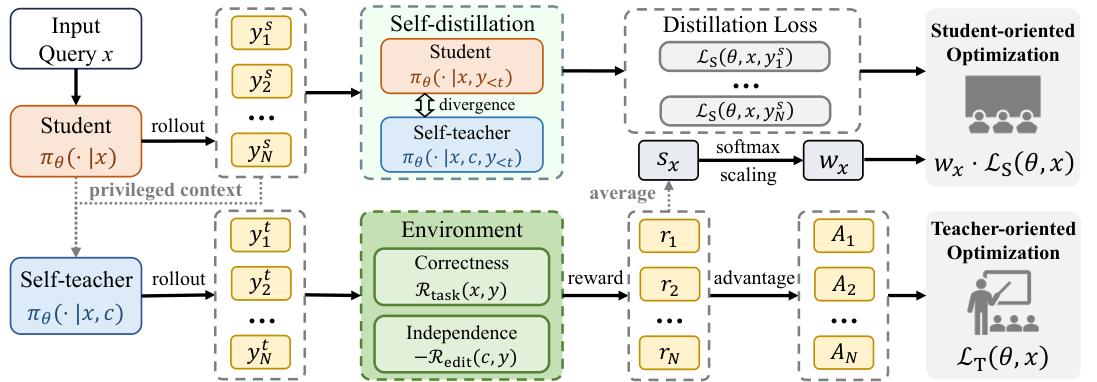
Figure 3 — TESD 전체 프레임워크
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 self-teacher의 능력을 정적으로 간주하지 않고 학습 과정에서 진화시키는 TESD 프레임워크를 제안하여 OPSD의 고질적인 정체 문제를 해결하였다. 연구 결과는 self-teacher의 지도 품질(supervision quality) 개선이 언어 모델의 추론 능력 향상에 결정적인 기여를 함을 입증한다. 본 연구는 향후 대규모 언어 모델의 post-training 전략을 더욱 고도화하고, 복잡한 추론 작업이나 멀티모달 환경 등 더 넓은 도메인으로 확장 가능한 중요한 이론적 토대를 마련하였다.
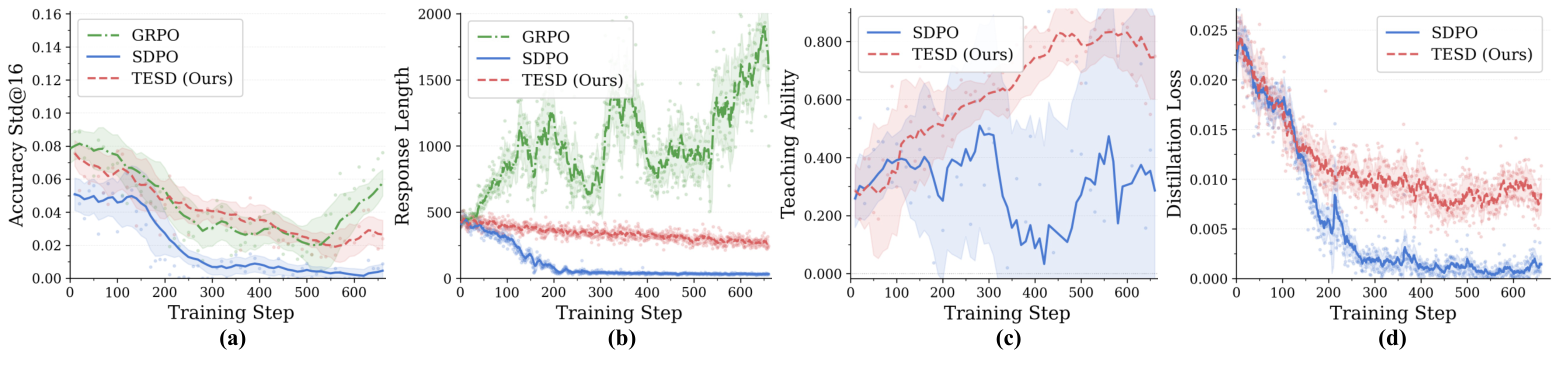
Figure 4 — 학습 과정의 지표 변화
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LongZero: Enhancing Long-Context Reasoning in LLMs from Zero Data
- [논문리뷰] Amortizing Sequential Experimental Design in Reasoning LLMs
- [논문리뷰] Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] Cowork-Gym: Synthesizing Interactive Work Environments at Scale
Review 의 다른글
- 이전글 [논문리뷰] NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
- 현재글 : [논문리뷰] On-Policy Self-Distillation with Teacher Evolution
- 다음글 [논문리뷰] Order-Only On-Policy Distillation
댓글